
Оптимизация производительности OpenGL: основы
Этот документ описывает некоторые фундаментальные понятия и методы для оптимизации производительности в приложениях OpenGL, включая настраивающуюся дорожную карту для использования 'вершины', Акулы и Профилировщика OpenGL для понимания, какому количеству полное приложение может принести преимущества из оптимизации OpenGL. Это также представляет инструменты производительности, такие как Монитор Драйвера OpenGL и покрывает несколько общих рекомендаций на использовании OpenGL эффективно.
Введение
Оптимизация кода OpenGL стала все более и более важным действием в разработке основанных на OpenGL приложений. Этот документ предназначен к разработчикам OpenGL, надеющимся улучшать производительность их приложений. У разработчиков должно быть фундаментальное знание программирования OpenGL и знакомства с OpenGL на Mac OS X, чтобы полностью использовать и понять информацию, представленную здесь.
Прежде, чем погрузиться в код для запуска производительности, настраивающей приложение OpenGL, лучше исследовать основные принципы оптимизации OpenGL и разрабатывать систематический подход к улучшению производительности приложений OpenGL. Этот документ обеспечивает поэтапные демонстрации при использовании Монитора Действия (или Инструменты) и Профилировщик OpenGL для определения, насколько полная производительность приложения может быть улучшена, если OpenGL должен был быть сокращен для обнуления наверху.
Документ тогда дает больше информации о Профилировщике OpenGL и других инструментах, доступных на Mac OS X для настройки производительности OpenGL, включая Монитор Драйвера OpenGL и Акулу. Следующее является несколькими важными вопросами, и разработчики уведомлений должны иметь в виду при разработке приложений OpenGL.
Настраивающая дорожная карта производительности
Запустите Приложение OpenGL (оконное) бок о бок с Инструментами Монитора Монитора или Действия Действия
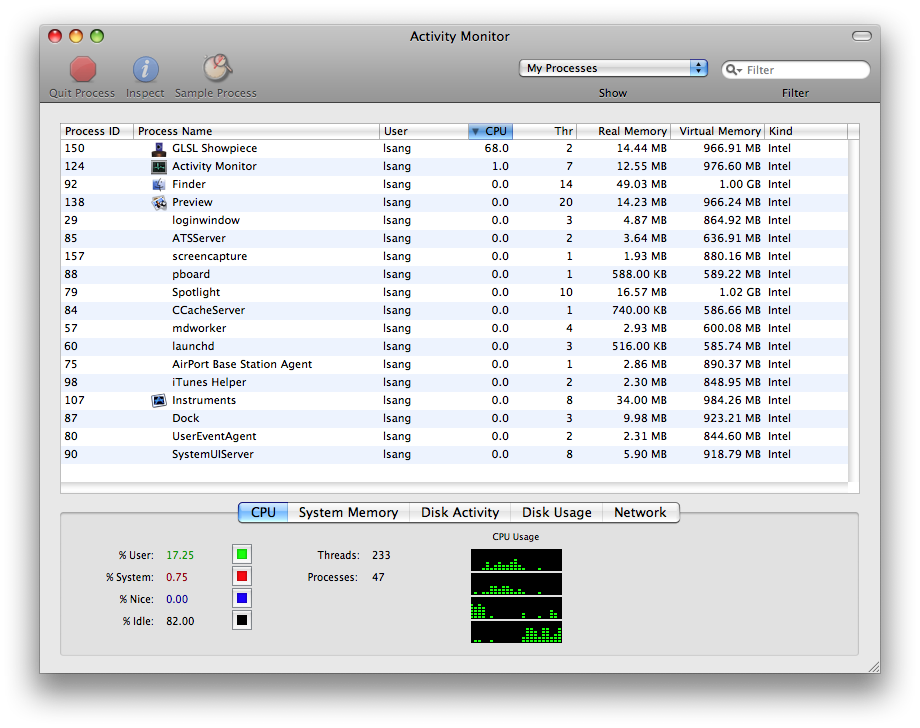
Это приводит к базовому показателю производительности для суммы процессорного времени, использованного приложением. Снимок экрана в качестве примера Монитора Действия показан ниже с рассматриваемым приложением (GLSLShowpiece), перечисленный на вершине.
Определите стандартную загрузку ЦП
Отметьте время в вышеупомянутом изображении. Приложение GLSLShowpiece в настоящее время использует 68,0% доступного процессорного времени. Это - базовое значение, которое должно использоваться для определения, как приложение выполняет.
Соберите статистические данные функции OpenGL и трассировку с помощью Профилировщика OpenGL
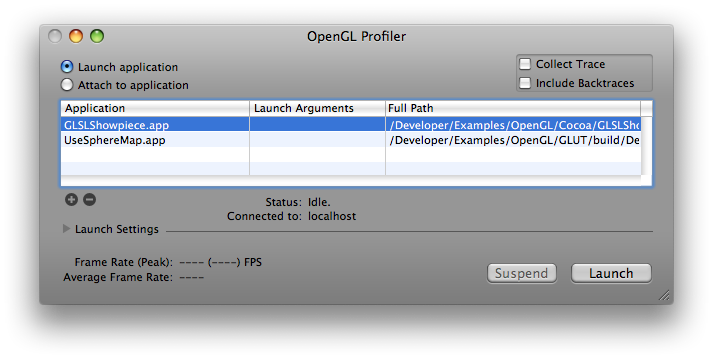
Существует два способа проанализировать приложение в Профилировщике OpenGL. Можно запустить приложение в Профилировщике, как продемонстрировано следующим диалоговым окном:
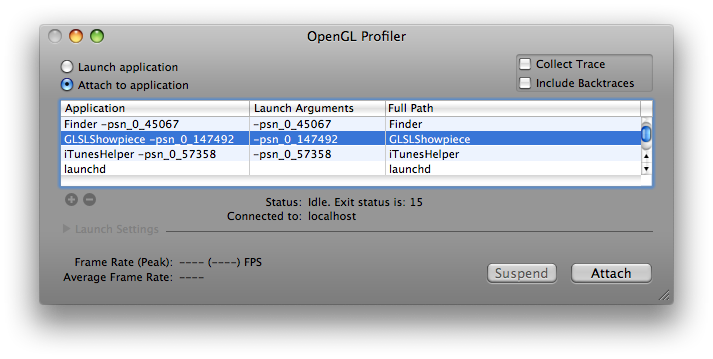
Или можно присоединить запущенное приложение к Профилировщику, как продемонстрировано этим диалоговым окном:
После того, как рассматриваемое приложение запускается или присоединяется, можно собрать статистические данные OpenGL путем выбора Statistics в соответствии с меню Views или нажатия cmd-opt-s. Точно так же можно собрать трассировку вызовов OpenGL путем выбора Trace в соответствии с меню Views или нажатия cmd-opt-t. Можно также собрать следы функций OpenGL путем проверки опции Include Backtraces в главное окно Профилировщика:
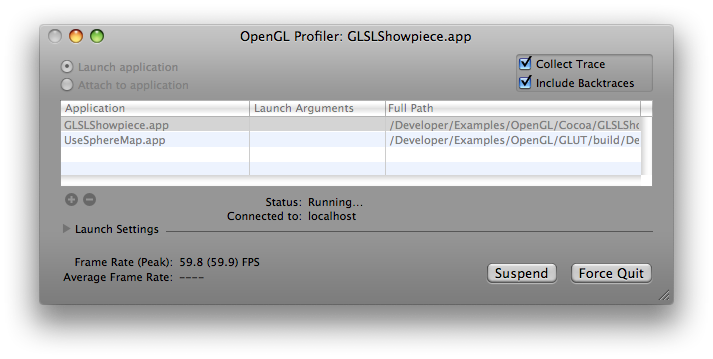
Когда Профилировщик собирает следы, можно видеть маленькие отклонения или незначительные сбои в приложении, особенно. Это нормально и не будет влиять на Вашу статистику производительности значительно. Причина этого состоит в том, что Профилировщик собирается и выписывает большой объем данных для функционального перечисления трассировки.
Проанализируйте данные статистики Профилировщика; Ищите процент времени приложения, проведенного в OpenGL и где проводится то время в OpenGL.
Это изображение показывает статистику Профилировщика от выборки GLSLShowpiece. Перечисление сортируется большей частью времени OpenGL, использованного в порядке убывания. Это указывает, что объем времени, проведенного в OpenGL, происходит в вычислениях двумерной сетки точек или строк (glEvalMesh2).
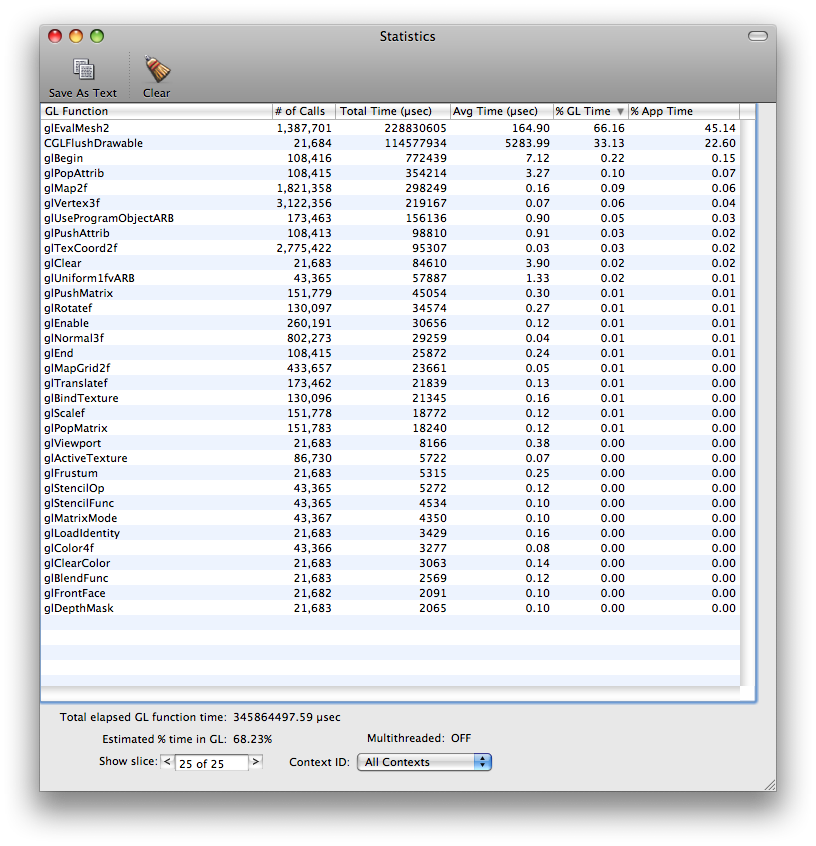
Вниз у основания изображения в левом углу имеет немного данные маркированное «Оцененное время % в OpenGL: 68,23%». В этой точке в анализе то число имеет большую часть беспокойства. Чем выше это число, тем больше времени приложение тратит в OpenGL и большей возможности, там может быть должно улучшить производительность приложения путем оптимизации OpenGL.
Проанализируйте трассировки функции Профилировщика; Ищите двойные вызовы функции и избыточные или ненужные изменения состояния.
Это изображение имеет саму функциональную трассировку. Обратите внимание на то, что это - только частичное перечисление полной функциональной трассировки, показывая вызовы функции от 100 587 до 100 615. Если Профилировщику разрешают продолжать собирать функциональные трассировки, могут быть тысячи страниц, таких как они, миллионы. Можно просмотреть перечисление путем прокрутки со стрелками внизу страницы. Внешние стрелки берут Вас к первым и последним страницам, левым и правым соответственно, и внутренние стрелки прокручивают одну страницу назад или вперед, снова левые и правые соответственно.
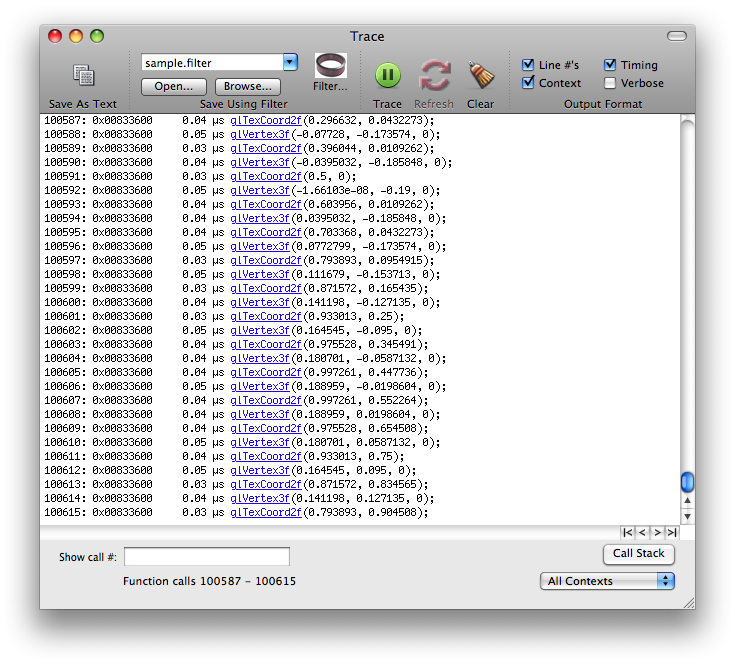
Трассировка может быть очень полезна для нахождения двойных вызовов функции или избыточных изменений состояния. При просмотре трассировок ищите идущие подряд вызовы функции с теми же или подобными данными. Это области, которые могут обычно оптимизироваться в коде для удаления некоторого вызова функции наверху. При поиске избыточных изменений состояния некоторые обычно замечаемые копии включают функции, такие как glTexParameter* (), glPixelStore* (), glEnable () и glDisable (). Много раз эти функции можно вызвать один раз от установки или подпрограммы модификации состояния и только вызвать при необходимости. Это - обычно хорошая практика для хранения изменений состояния из рендеринга циклов (который может быть замечен в функциональной трассировке как та же последовательность изменений состояния и рисующий много раз), так же столь же возможный и использование отдельные подпрограммы для корректировки состояния по мере необходимости. Этот предмет будет описан более подробно позже в документе.
Определите то, чем было бы преимущество максимальной производительности то, если OpenGL должен был быть сокращен для обнуления наверху
Возможно, самый важный аспект производительности OpenGL - то, как это касается полной производительности приложения. Используя вышеупомянутые данные от выборки GLSLShowpiece, 68,0% (от Монитора Действия или Инструментов) доступного процессорного времени используются приложением. В то время как остаток используется самим приложением, из этого 68,0% 68,23% (от Профилировщика) тратятся в OpenGL. Следующие уравнения иллюстрируют отношение этих двух чисел и сколько может получить полное приложение, если OpenGL должен был быть сокращен для обнуления наверху:
Увеличение общей производительности = (общее использованное процессорное время) * (Процент времени, проведенного в OpenGL)
Новый Framerate = предыдущий FPS * (1 + (увеличение производительности процента)
Размещение сгенерированных данных в уравнения приводит к следующим результатам:
Увеличение общей производительности = (68,0%) * (68,23%) = 46,3964%
Новый Framerate = 59.8 футов в секунду * 1.464 = 87.5 футов в секунду
Используйте профилировщика, монитор драйвера, инструменты и акулу
Предыдущий раздел предложил некоторые подсказки и инструкции для использования Профилировщика OpenGL для сбора данных о производительности для приложения OpenGL. С Профилировщиком видят разработчики, сколько времени проводится в OpenGL, в которых функциях то время проводится и трассировки вызова функции для проанализированного приложения. Профилировщик OpenGL содержит еще много функций и функций, не просто тех упомянутых ранее. Для большего количества полного описания Профилировщика OpenGL посетите профилирование Реального мира с веб-страницей Профилировщика OpenGL.
Эти три инструмента, включенные с установкой Инструментов Разработчика Mac OS X, первостепенной важности когда производительность, настраивающая приложения OpenGL. Они способны к разыскиванию и иллюстрированию многих общих проблем производительности, найденных в приложениях OpenGL. Вместо того, чтобы копировать большую информацию в этом документе относительно этих инструментов, включенных ниже, список ссылок к надлежащей документации инструментов.
При использовании Профилировщика существует пара вещей иметь в виду. Когда Вы начинаете работать с Профилировщиком, следующее является коротким списком элементов для учета:
Соберите статистические данные для наблюдения, где время проводится в OpenGL
Соберите функциональную трассировку для поиска двойных вызовов функции и избыточных изменений состояния
Искать
glFinish()команды в функциональной статистике и удаляют из кода, если это возможно.Проверьте на команды представления вершины - определяют, как вершины представляются OpenGL.
Монитор Драйвера OpenGL может быть подавляющим сначала, так для получения лучшего схватывания на выведенных на экран данных, смотрите на раздел «OpenGL Driver Monitor Parameters» в Руководстве пользователя Монитора Драйвера OpenGL. Этот документ описывает в умеренной подробности различные аспекты Монитора Драйвера и некоторые более важные статистические данные, которые могут быть исследованы в приложении.
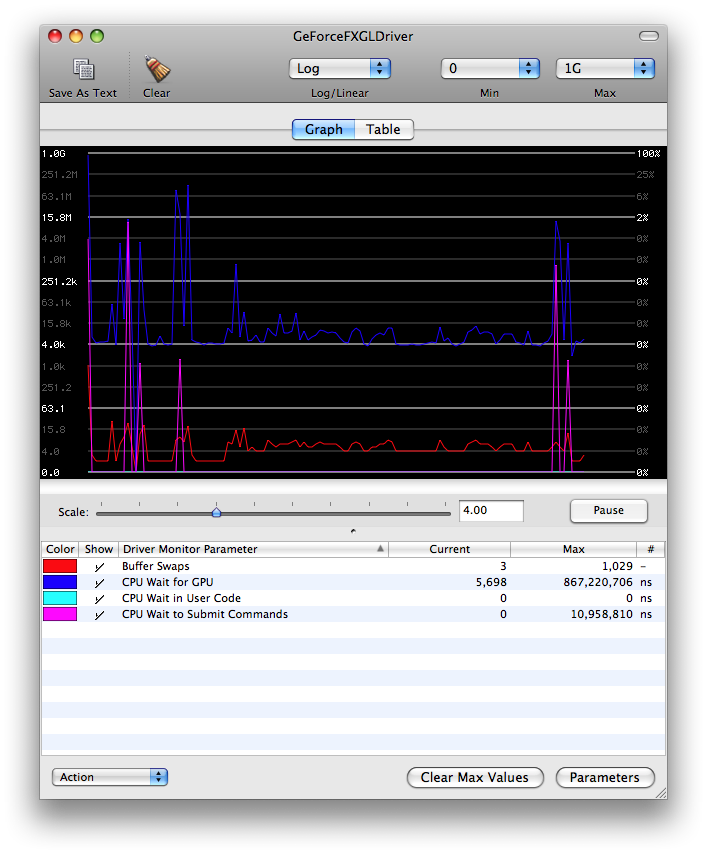
В этом изображении Монитора Драйвера, работающего одновременно с приложением GLSLShowpiece, фактически, все параметры и состояния драйвера могут быть просмотрены и проанализированы. В этом определенном примере существует 4 различных элемента, в настоящее время прослеживаемые Монитором Драйвера: bufferSwapCount (Буферные Подкачки), clientGLWaitTime (CPU ожидает GPU), hardwareSubmitWaitTime (CPU ожидает в пользовательском коде), и hardwareWaitTime (CPU Ожидает для представления Команд). Первый относительно прост - bufferSwapCount общее количество буферных подкачек, выполняемых драйвером. Второе, clientGLWaitTime, количество времени, CPU останавливается клиентом драйвер OpenGL при ожидании аппаратной метки времени для поступления. Это обычно происходит при ожидании обновления текстуры или завершения glFence () команды. Третий параметр, hardwareSubmitWaitTime, показывает, сколько времени CPU останавливается, ожидая, чтобы быть в состоянии представить новый пакет команд OpenGL. Это - особенно важная функция, поскольку она может предложить некоторое понимание относительно того, сколько времени тратится впустую CPU, ожидающим GPU для обработки ранее представленных буферов команд. Последний параметр, hardwareWaitTime, глобальный индикатор того, сколько времени CPU останавливается при ожидании GPU. Этот параметр охватывает параметры такой как hardwareSubmitWaitTime и другие аппаратные средства, ожидая ситуации.
Инструменты являются очень мощным инструментом, который может собрать множество данных о производительности от Вашего запущенного приложения, включая использование CPU, использование памяти, активность диска, сетевую активность, и т.д. В отличие от большей части другой производительности и средств отладки, Инструменты позволяют Вам просмотреть во временной шкале все различные типы информации рядом. Это позволяет Вам коррелировать полное поведение своего приложения, не только поведение в одной определенной области. В дополнение к обеспечению графического представления временной шкалы Инструменты обеспечивают инструменты, чтобы помочь Вам анализировать поведение своего приложения в течение долгого времени. Например, окно Instruments позволяет Вам хранить данные от многократных выполнений так, чтобы Вы видели, улучшается ли поведение Вашего приложения фактически или должно ли это все еще работать. Для получения дополнительной информации о том, как использовать инструмент, см. Инструментальное Руководство пользователя.
Дополнять Инструменты данных о производительности собирается, приложение Акулы позволяет Вам просмотреть события системного уровня, такие как системные вызовы, решения планирования потоков, прерывания и отказы виртуальной памяти. Когда Вы находите, что проблемы производительности в Вашем коде более связаны со взаимодействием между Вашим кодом, Mac OS X и аппаратной архитектурой устройства, можно использовать Акулу, чтобы получить информацию о тех итерациях и найти узкие места производительности. Для получения дополнительной информации об Акуле сошлитесь на Использование документации Акулы.
Нахождение и устранение двойных вызовов функции и избыточных изменений состояния
Один из основных преступников для проблем производительности OpenGL является двойными вызовами функции. Существует много форм этой определенной проблемы, включая избыточные настройки состояния и многократные сбросы, или загружает единственный кадр. Например, если Вы позволяли осветить вызовом такой как glEnable(GL_LIGHTING) или включение текстурирования с glEnable(GL_TEXTURE_2D), их только нужно вызвать один раз для включения и/или один раз для отключения. Общий сценарий здесь для приложения, чтобы позволить текстурировать и/или осветить каждый раз через цикл получения. Вообще говоря, приложение должно будет только внести изменения состояния, такие как они один раз, если они должны использоваться всюду по приложению и должны быть сделаны в специализированной подпрограмме установки. Однако существуют экземпляры, где текстурирование или освещение, возможно, должны быть выключены и назад на снова (такой, таща каркасную схему вокруг текстурированного многоугольника) для выполнения определенного визуального эффекта или операции рисования. В этом случае изолированные подпрограммы должны присутствовать, который изменит состояние, только если необходимый и должен быть сделан на прикладном уровне вместо в самом OpenGL.
Важно понять, что OpenGL не выполняет типа проверок непротиворечивости или избыточных проверок набора состояния. Например, как в примере выше, если вызов выполняется такой как glEnable(GL_LIGHTING) и впоследствии, этот тот же приказ издан, OpenGL не проверит, что фактически изменяется состояние. Даже если то значение будет идентично своей текущей стоимости, это просто обновит значение состояния предоставленного параметра. Это - проектное решение в спецификации OpenGL и не специфичное для реализации. Дополнительный код, требуемый выполнять эти проверки, в то время как полезный для разработчиков, неизбежно вызвал бы проблемы производительности даже для приложений, не делавших таких вещей.
Изменения состояния в OpenGL имеют тенденцию быть дорогими и должны вспыхнуться в отдельную инициализацию или подпрограммы конфигурации. Размещение их призывает, рисуют циклы, или функции, выполняемые циклами получения, имеют эффект замедления производительности OpenGL вследствие ненужных изменений в состоянии. Вследствие того, что OpenGL с нравом к производительности, никакая условная или проверка ошибок не выполняется на входящих изменениях состояния, таким образом, эти вызовы будут стоить стольких циклов для избыточных записей, сколько они были бы для изменения данных.
Эффективное использование glFlush () и glFinish ()
Эти две команды оба используются, чтобы сделать по существу ту же вещь, тот являющийся для представления всех команд OpenGL с очередями аппаратным средствам для выполнения. Существенное различие между этими двумя - это glFinish() блоки до всех тех команд были выполнены аппаратными средствами, в то время как glFlush() просто ожидает, пока все команды не были представлены. Один только этот факт делает его довольно ясным это glFinish() может вызвать намного более серьезные проблемы, чем glFlush().
Проблемы, центрируемые вокруг этих двух вызовов функции, обычно просто разыскать. Неправильное использование этих команд может вызвать остановы и замедлить холмы, неизбежно приводящие к низкой производительности приложений. Это обычно выводится на экран как заикание, вялый ответ и высокие уровни загрузки ЦП. Беглый взгляд через отчет статистики от Профилировщика OpenGL должен показать, где проблемы заключаются, если glFlush() или glFinish() виновато.
Поскольку можно вообразить, glFlush() оказывает намного меньше значительное влияние на производительность, чем glFinish() делает. В поисках более высокой производительности, glFinish() команды должны быть удалены, если они не считаются абсолютно необходимыми. glFlush() команды могут использоваться, пока это сделано так эффективным способом. Например, Вы могли использовать glFlush() для принуждения обновлений получения в конце цикла получения но Вы не хотели бы делать это правильно перед вызовом к буферной команде свопинга (такой как aglSwapBuffers(), который содержит неявное glFlush() самостоятельно). Для более подробного описания этих двух команд сошлитесь на Вопросы и ответы glFlush() и glFinish и их влияние на производительность.
Понимание вертикальной синхронизации
Вертикальная синхронизация (VSYNC) относится к синхронизации изменений кадра с вертикалью, восстанавливают. Вертикальный восстанавливают, также известный как вертикальный интервал обратного хода луча или вертикальный сигнал синхронизации, используется для описания действия, выполняемого в дисплее CRT, поворачивающем электронный луч от каждого раза, когда луч завершил трассировку всего экрана для создания изображения.
Приложения обычно синхронизируются с вертикалью, восстанавливают для устранения проблемы разрыва кадра. Разрыв кадра является ситуацией, где часть следующего кадра перезаписывает предыдущие данные кадра в кадровом буфере, прежде чем тот кадр был полностью представлен на экране. Визуальный эффект этого - то, что каждый будет видеть, возможно, половину (более или менее в зависимости от ситуации) нового кадра и остатка от предыдущего кадра. Вертикальная синхронизация устраняет эту проблему только кадром получения 1 во время вертикали, восстанавливают, который гарантирует, что только 1 кадр будет нарисован на экранное обновление.
Другая причина необходимо включить вертикальную синхронизацию, состоит в том, чтобы избежать перегружать цикл получения при использовании рендеринга таймеров. Вы найдете, что больше информации об этом в следующей главе не пытается перегрузить графический конвейер (рендерингом таймеров).
Существуют некоторые протесты к выполнению этого, как бы то ни было. Обновление только происходит в целочисленных факторах текущей частоты обновления монитора (60 Гц, 30 Гц, 15 Гц, и т.д.). Проблема здесь состоит в том, что OpenGL блокирует, в то время как ожидание следующей вертикали восстанавливает, который имеет тенденцию напрасно тратить время, который мог быть потрачен, выполнив другие операции рисования.
Не пытайтесь перегрузить графический конвейер (рендерингом таймеров)
Другой общей проблемой производительности является попытка приложения перегрузить циклы получения. Это обычно возникает, когда вертикальная синхронизация не включена и использование таймера, стреляющего в быстрой последовательности, вызывая цикл получения каждый раз, когда это стреляет. Как правило, интервал таймера был установлен в некоторое исключительно маленькое значение (такое как 0,001 секунды привести к 1 000 выполнения в секунду). Эффект этого как раз наоборот от того, что часто ожидается - процессорное время используется в двойном или тройном (иногда намного выше), что это было бы или должно обычно быть, и производительность приложения сильно ухудшается.
В этой ситуации, лучше любой позволять системе регулировать получение (использование -setNeedsDisplay: в Какао, например) или синхронизировать буферные подкачки с частотой кадровой развертки. Это вызвано тем, что, когда блоки приложений, ожидающие следующей вертикали, восстанавливают, таймер не может стрелять, таким образом не занимая дополнительного процессорного времени. Когда вертикальная синхронизация включена, это - фактически хорошая практика для установки таймера в маленький интервал, такой как 0,001 секунды или 1 000 кадр/с, так, чтобы приложение OpenGL могло иметь всю длительность повтора для рисования.
Как альтернатива для использования таймеров, можно принять решение использовать Базовую ссылку Видеодисплея для управления циклом получения, не волнуясь о выборе интервала подходящего времени или перегрузке конвейера. Для получения дополнительной информации о Базовой ссылке Видеодисплея, посмотрите
Для получения дополнительной информации об этом предмете и примерах короткого кода, посмотрите Технические Вопросы и ответы QA1385, 'Ведущие Циклы Рендеринга OpenGL'. Документ обеспечивает примеры кода управления циклом получения Какао приложение OpenGL с помощью a CVDisplayLink а также использование NSTimer когда идет вертикальная синхронизация. Код, перечисленный там, иллюстрирует надлежащую архитектуру цикла рендеринга в Какао в обоих случаях.
Чтение пикселей от кадрового буфера
Чтение пикселей назад от кадрового буфера в OpenGL обычно выполняется с glReadPixels() API. Понимание, как эта команда функционирует, является ключевым для достижения хорошей производительности приложения, когда назад требуется буферное чтение.
Стандартный glReadPixels() блокирует конвейер, пока все команды рендеринга не завершены, и ожидает, пока все пиксельные данные не передаются и готовы к употреблению, прежде чем он возвратит управление вызывающему приложению. Можно легко видеть, что это имеет два отрицательного влияния производительности, вызывая точку синхронизации между вызывающим приложением и OpenGL (что-то, чего необходимо всегда стремиться избежать), и стоимость передачи данных от GPU до CPU через шину (который может быть довольно дорогим в зависимости от того, сколько данных получено).
Наоборот, glReadPixels() с PBOs (пиксельные буферные объекты) может запланировать асинхронную передачу данных и сразу возвращается без останова. Поэтому приложение может выполнить другие процессы сразу же при передаче данных OpenGL одновременно. Другое преимущество использования PBOs является быстрой передачей пиксельных данных от (и к) видеокарта хотя DMA, не включая циклы CPU. Стандартным способом пиксельные данные загружаются в системную память CPU. Используя PBO, вместо этого, GPU управляет копированием данных от кадрового буфера до PBO. Это означает, что OpenGL выполняет работу передачи DMA, не тратя впустую циклы CPU.
Для максимизации асинхронного чтения назад производительность можно использовать два PBOs. Каждый кадр, приложение читает пиксельные данные от кадрового буфера до одного использования PBO glReadPixels(), и обрабатывает пиксельные данные в другом. Вызовы к glMapBufferARB() и glUnmapBufferARB() отобразит/не отобразит OpenGL управлял буферным объектом к адресному пространству клиента так, чтобы можно было получить доступ и изменить буфер через указатель. Они чтение и процесс могут быть выполнены одновременно, потому что glReadPixels() к первым возвратам PBO сразу, таким образом, CPU может начать обрабатывать данные во втором PBO незамедлительно. Вы чередуете между двумя PBOs каждый кадр.
Заключительные замечания
В заключение вышеупомянутая информация должна предложить прочную основу, на которую можно создать быстрое, оптимизированное приложение OpenGL на Mac OS X. Важная вещь помнить вот состоит в том, что это - действительно «верхушка айсберга», если можно так выразиться, и что существуют многочисленные другие методы и технологии, которые могут использоваться для дальнейшего улучшения производительности приложения. Другая проблема для учета - то, что все приложения не управляют графическим конвейером таким же образом, поэтому различные методы оптимизации могут быть необходимыми в зависимости от того, как приложение проектируется и как это обрабатывает рендеринг.
Ссылочный раздел
Руководство пользователя монитора драйвера OpenGL
Профилирование реального мира с Профилировщиком OpenGL
Инструментальное руководство пользователя
Управление рендерингом циклов с
Кроме того, представления OpenGL от предыдущих сеансов WWDC являются чрезвычайно ценными ссылками для производительности OpenGL. Они доступны на DVD всем разработчикам, посещающим конференцию.
История версии документа
| Дата | Примечания |
|---|---|
| 07.06.2013 | Исправленные ссылки. |
| 05.11.2008 | Добавленный краткий обзор; Обновленный снимки экрана и соответствующий текст с версиями Leopard; Добавленный больше подробных данных к главе «Понимания Вертикальной Синхронизации» (был назван как «Понимание VSYNC»), и «Чтение пикселей от кадрового буфера». |
| 01.12.2004 | Этот документ описывает некоторые понятия и методы для оптимизации производительности в приложениях OpenGL. |
Новый документ, что этот документ описывает некоторые понятия и методы для оптимизации производительности в приложениях OpenGL. |