Подпрограммы и каналы − учебник
В этом учебнике вы узнаете, как использовать подпрограммы в IntelliJ IDEA для выполнения сетевых запросов без блокировки базовой потоковой нити или обратных вызовов.
Вы узнаете:
Зачем и как использовать отложенные функции для выполнения сетевых запросов.
Как отправлять запросы одновременно с помощью подпрограмм.
Как обмениваться информацией между различными подпрограммами с помощью каналов.
Для сетевых запросов вам потребуется библиотека Retrofit, но подход, показанный в этом учебнике, аналогичен для других библиотек, поддерживающих подпрограммы.
Прежде чем начать
Загрузите и установите последнюю версию IntelliJ IDEA.
-
Клонируйте шаблон проекта, выбрав Получить из VCS на экране «Добро пожаловать» или выбрав Файл | Новый | Проект из системы управления версиями.
Вы также можете клонировать его из командной строки:
git clone https://github.com/kotlin-hands-on/intro-coroutines
Генерация маркера разработчика GitHub
В проекте вы будете использовать API GitHub. Для получения доступа предоставьте имя учетной записи GitHub и либо пароль, либо маркер. Если у вас включена двухфакторная аутентификация, то достаточно маркера.
Сгенерируйте новый маркер GitHub для использования API GitHub со своей учетной записью:
-
Укажите имя маркера, например,
coroutines-tutorial,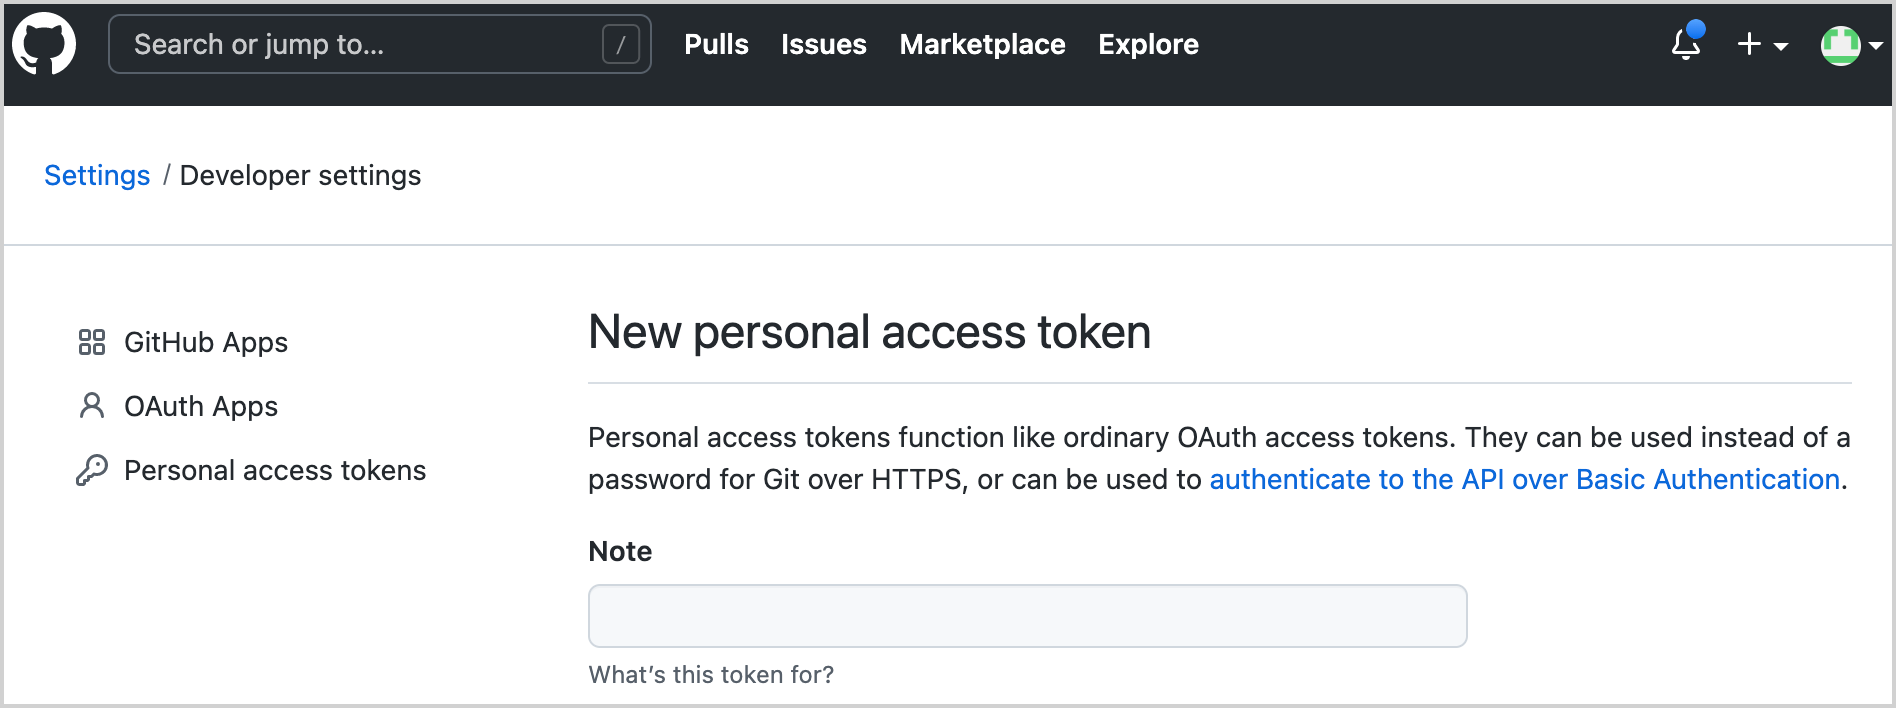
Не выбирайте никакие области. Нажмите Создать маркер в нижней части страницы.
Скопируйте сгенерированный маркер.
Запуск кода
Программа загружает авторов для всех репозиториев в указанной организации (по умолчанию «kotlin»). Позже вы добавите логику для сортировки пользователей по количеству их вкладов.
-
Откройте файл
src/contributors/main.ktи запустите функциюmain(). Вы увидите следующее окно: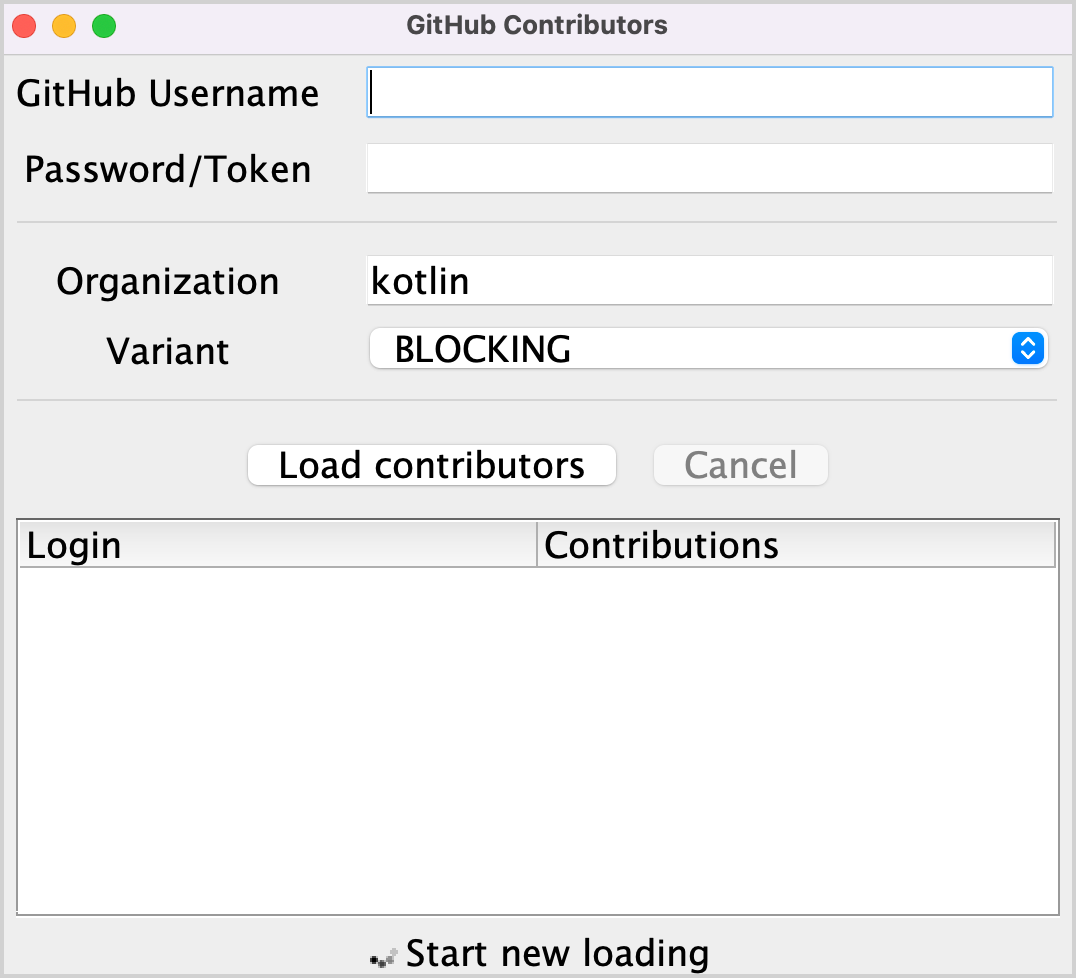
Если шрифт слишком мелкий, отрегулируйте его, изменив значение
setDefaultFontSize(18f)в функцииmain(). В соответствующих полях укажите имя пользователя GitHub и маркер (или пароль).
Убедитесь, что в раскрывающемся списке «Вариант» выбран параметр БЛОКИРУЮЩИЙ.
Нажмите Загрузить авторов. Интерфейс пользователя должен на некоторое время заморозиться, а затем отобразить список авторов.
Откройте вывод программы, чтобы убедиться, что данные загружены. Список авторов регистрируется после каждого успешного запроса.
Существует несколько способов реализации этой логики: с использованием блокирующих запросов или обратных вызовов. Вы сравните эти решения с решением, использующим подпрограммы, и увидите, как каналы можно использовать для обмена информацией между различными подпрограммами.
Блокирующие запросы
Для выполнения HTTP-запросов к GitHub вы будете использовать библиотеку Retrofit. Она позволяет запрашивать список репозиториев в рамках заданной организации и список участников для каждого репозитория:
interface GitHubService {
    @GET("orgs/{org}/repos?per_page=100")
    fun getOrgReposCall(
        @Path("org") org: String
    ): Call<List<Repo>>

    @GET("repos/{owner}/{repo}/contributors?per_page=100")
    fun getRepoContributorsCall(
        @Path("owner") owner: String,
        @Path("repo") repo: String
    ): Call<List<User>>
}
Этот API используется функцией loadContributorsBlocking() для получения списка участников заданной организации.
-
Откройте
src/tasks/Request1Blocking.ktдля просмотра её реализации:fun loadContributorsBlocking(service: GitHubService, req: RequestData): List<User> { val repos = service .getOrgReposCall(req.org) // #1 .execute() // #2 .also { logRepos(req, it) } // #3 .body() ?: emptyList() // #4 return repos.flatMap { repo -> service .getRepoContributorsCall(req.org, repo.name) // #1 .execute() // #2 .also { logUsers(repo, it) } // #3 .bodyList() // #4 }.aggregate() }Сначала вы получаете список репозиториев заданной организации и сохраняете его в списке
repos. Затем для каждого репозитория запрашивается список участников, и все списки объединяются в один итоговый список участников.getOrgReposCall()иgetRepoContributorsCall()оба возвращают экземпляр класса*Call(#1). На этом этапе ни один запрос не отправляется.Затем вызывается
*Call.execute()для выполнения запроса (#2).execute()— это синхронный вызов, который блокирует подлежащую нить.При получении ответа результат регистрируется с помощью специальных функций
logRepos()иlogUsers()(#3). Если HTTP-ответ содержит ошибку, эта ошибка будет зарегистрирована здесь.Наконец, получите тело ответа, содержащее необходимые данные. Для этого учебника в случае ошибки вы будете использовать пустой список в качестве результата и регистрировать соответствующую ошибку (
#4).
-
Чтобы избежать повторения
.body() ?: emptyList(), объявляется функция-расширениеbodyList().fun <T> Response<List<T>>.bodyList(): List<T> { return body() ?: emptyList() } -
Запустите программу ещё раз и посмотрите вывод системы в IntelliJ IDEA. Он должен быть примерно таким:
1770 [AWT-EventQueue-0] INFO  Contributors - kotlin: loaded 40 repos
2025 [AWT-EventQueue-0] INFO  Contributors - kotlin-examples: loaded 23 contributors
2229 [AWT-EventQueue-0] INFO  Contributors - kotlin-koans: loaded 45 contributors
...
Первым элементом на каждой строке является количество миллисекунд, прошедших с момента запуска программы, затем имя потока в квадратных скобках. Вы можете увидеть, из какого потока был вызван запрос загрузки.
Последним элементом на каждой строке является фактическое сообщение: сколько репозиториев или участников было загружено.
Этот вывод журнала демонстрирует, что все результаты были зарегистрированы из основного потока. При запуске кода с опцией БЛОКИРОВКА окно замирает и не реагирует на ввод до завершения загрузки. Все запросы выполняются из того же потока, что и вызов
loadContributorsBlocking(), который является основным потоком пользовательского интерфейса (в Swing это поток диспетчеризации событий AWT). Этот основной поток блокируется, и поэтому пользовательский интерфейс замирает:
После загрузки списка участников результат обновляется.
-
В
src/contributors/Contributors.kt, найдите функциюloadContributors(), отвечающую за выбор способа загрузки участников, и посмотрите, как вызываетсяloadContributorsBlocking().when (getSelectedVariant()) { BLOCKING -> { // Blocking UI thread val users = loadContributorsBlocking(service, req) updateResults(users, startTime) } }Вызов
updateResults()идёт сразу после вызоваloadContributorsBlocking().updateResults()обновляет пользовательский интерфейс, поэтому его всегда необходимо вызывать из потока пользовательского интерфейса.Поскольку
loadContributorsBlocking()также вызывается из потока пользовательского интерфейса, поток пользовательского интерфейса блокируется, и пользовательский интерфейс замирает.
Задача 1
Первая задача поможет вам познакомиться с областью задачи. В настоящее время имя каждого участника повторяется несколько раз, по одному разу для каждого проекта, в котором он участвовал. Реализуйте функцию aggregate(), объединяющую пользователей, так что каждый участник добавляется только один раз. Свойство User.contributions должно содержать общее количество вкладов данного пользователя во все проекты. Результирующий список должен быть отсортирован в порядке убывания количества вкладов.
Откройте src/tasks/Aggregation.kt и реализуйте функцию List<User>.aggregate(). Пользователи должны быть отсортированы по общему количеству их вкладов.
Соответствующий тестовый файл test/tasks/AggregationKtTest.kt показывает пример ожидаемого результата.
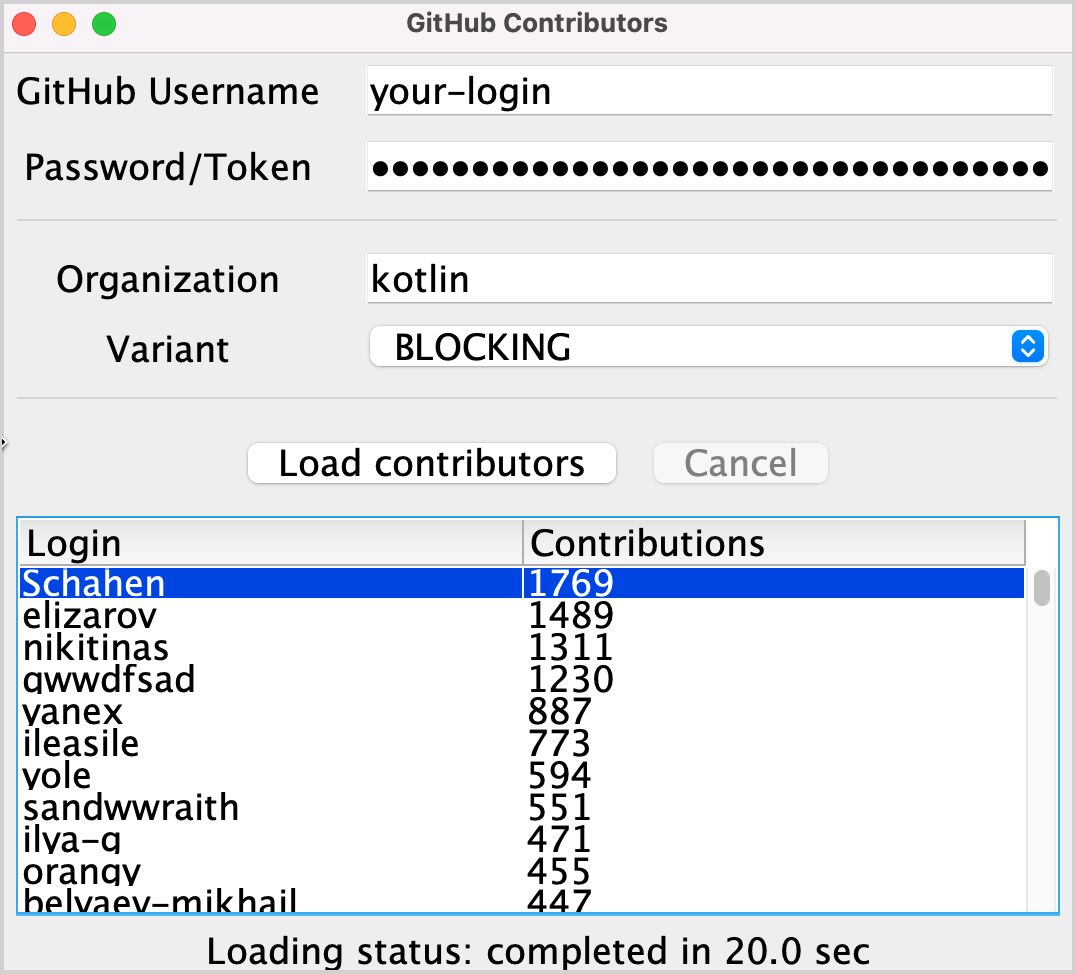
После выполнения этой задачи результирующий список для организации "kotlin" должен быть похож на следующий:
Решение для задачи 1
Для группировки пользователей по логину используйте
groupBy(), которая возвращает карту из логина к всем появлениям пользователя с этим логином в различных репозиториях.Для каждой записи в карте подсчитайте общее количество вкладов для каждого пользователя и создайте новый экземпляр класса
Userс заданным именем и общим количеством вкладов.-
Отсортируйте полученный список в порядке убывания:
fun List<User>.aggregate(): List<User> =
    groupBy { it.login }
        .map { (login, group) -> User(login, group.sumOf { it.contributions }) }
        .sortedByDescending { it.contributions }
Альтернативным решением является использование функции groupingBy() вместо groupBy().
Обратные вызовы
Предыдущее решение работает, но блокирует поток, а значит, замораживает пользовательский интерфейс. Традиционный подход, который этого избегает, использует обратные вызовы.
Вместо вызова кода, который должен быть вызван сразу после завершения операции, его можно выделить в отдельный обратный вызов, часто лямбду, и передать эту лямбду вызывающей стороне, чтобы она вызвала ее позже.
Для обеспечения отзывчивости пользовательского интерфейса можно либо перенести все вычисления в отдельный поток, либо переключиться на API Retrofit, который использует обратные вызовы вместо блокирующих вызовов.
Использование фонового потока
-
Откройте
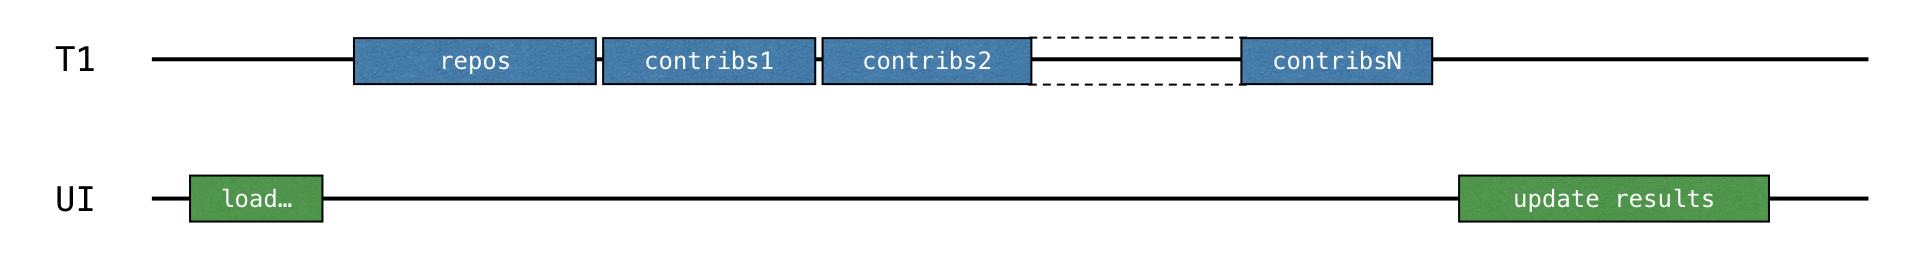
src/tasks/Request2Background.ktи посмотрите его реализацию. Сначала все вычисления переносятся в другой поток. Функцияthread()запускает новый поток:thread { loadContributorsBlocking(service, req) }Теперь, когда вся загрузка перенесена в отдельный поток, основной поток свободен и может быть занят другими задачами:
-
Подпись функции
loadContributorsBackground()изменяется. Она принимаетupdateResults()обратный вызов в качестве последнего аргумента, чтобы вызвать его после завершения всей загрузки:fun loadContributorsBackground( service: GitHubService, req: RequestData, updateResults: (List<User>) -> Unit ) -
Теперь, когда вызывается
loadContributorsBackground(), вызовupdateResults()происходит в обратном вызове, а не сразу после него, как было раньше:loadContributorsBackground(service, req) { users -> SwingUtilities.invokeLater { updateResults(users, startTime) } }Вызывая
SwingUtilities.invokeLater, вы гарантируете, что вызовupdateResults(), обновляющий результаты, происходит в главном потоке пользовательского интерфейса (потоке обработки событий AWT).
Однако, если вы попытаетесь загрузить авторов через опцию BACKGROUND, вы увидите, что список обновляется, но ничего не меняется.
Задача 2
Исправьте функцию loadContributorsBackground() в src/tasks/Request2Background.kt, чтобы результирующий список отображался в пользовательском интерфейсе.
Решение задачи 2
Если вы попытаетесь загрузить авторов, вы увидите в логах, что авторы загружены, но результат не отображается. Чтобы это исправить, вызовите updateResults() для результирующего списка пользователей:
thread {
    updateResults(loadContributorsBlocking(service, req))
}
Убедитесь, что явным образом вызывается логика, переданная в обратном вызове. В противном случае ничего не произойдёт.
Использование API Retrofit с обратными вызовами
В предыдущем решении вся логика загрузки перемещается в фоновый поток, но это всё ещё не лучшее использование ресурсов. Все запросы загрузки выполняются последовательно, а поток блокируется, ожидая результата загрузки, в то время как он мог быть занят другими задачами. В частности, поток мог начать загрузку другого запроса, чтобы получить весь результат раньше.
Обработка данных для каждого репозитория должна быть разделена на две части: загрузка и обработка полученного ответа. Вторая часть обработки должна быть выделена в обратный вызов.
Загрузка для каждого репозитория может быть начата до получения результата для предыдущего репозитория (и вызова соответствующего обратного вызова):
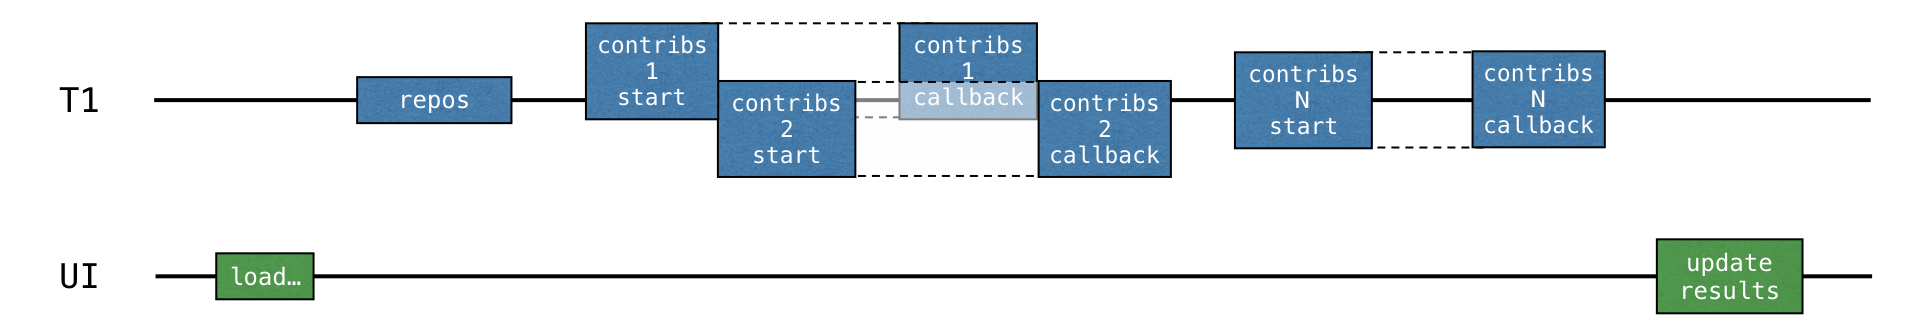
API Retrofit с обратными вызовами может помочь в этом. Функция Call.enqueue() запускает HTTP-запрос и принимает обратный вызов в качестве аргумента. В этом обратном вызове необходимо указать, что нужно сделать после каждого запроса.
Откройте src/tasks/Request3Callbacks.kt и посмотрите реализацию loadContributorsCallbacks(), которая использует этот API:
fun loadContributorsCallbacks(
    service: GitHubService, req: RequestData,
    updateResults: (List<User>) -> Unit
) {
    service.getOrgReposCall(req.org).onResponse { responseRepos ->  // #1
        logRepos(req, responseRepos)
        val repos = responseRepos.bodyList()

        val allUsers = mutableListOf<User>()
        for (repo in repos) {
            service.getRepoContributorsCall(req.org, repo.name)
                .onResponse { responseUsers ->  // #2
                    logUsers(repo, responseUsers)
                    val users = responseUsers.bodyList()
                    allUsers += users
                }
            }
        }
        // TODO: Why doesn't this code work? How to fix that?
        updateResults(allUsers.aggregate())
    }
Для удобства этот фрагмент кода использует функцию расширения
onResponse(), объявленную в том же файле. Она принимает лямбду в качестве аргумента вместо выражения объекта.Логика обработки ответов выделена в обратные вызовы: соответствующие лямбды начинаются с строк
#1и#2.
Однако, приведенное решение не работает. Если запустить программу и загрузить авторов, выбрав опцию CALLBACKS, ничего не будет отображаться. Однако тесты, которые сразу возвращают результат, проходят.
Подумайте, почему данный код не работает как ожидается, и попробуйте исправить его, или посмотрите решения ниже.
Задача 3 (необязательно)
Перепишите код в файле src/tasks/Request3Callbacks.kt так, чтобы загруженный список авторов отображался.
Первое попытанное решение задачи 3
В текущем решении много запросов запускаются одновременно, что уменьшает общее время загрузки. Однако результат не загружается. Это происходит потому, что обратный вызов updateResults() вызывается сразу после запуска всех запросов загрузки, до того, как список allUsers заполнится данными.
Можно попробовать исправить это с помощью такого изменения:
val allUsers = mutableListOf<User>()
for ((index, repo) in repos.withIndex()) {   // #1
    service.getRepoContributorsCall(req.org, repo.name)
        .onResponse { responseUsers ->
            logUsers(repo, responseUsers)
            val users = responseUsers.bodyList()
            allUsers += users
            if (index == repos.lastIndex) {    // #2
                updateResults(allUsers.aggregate())
            }
        }
}
Сначала вы перебираете список репозиториев с индексом (
#1).Затем из каждого обратного вызова вы проверяете, является ли это последней итерацией (
#2).И если это так, то результат обновляется.
Однако, этот код также не решает задачу. Попробуйте найти ответ самостоятельно или посмотрите решение ниже.
Второе попытанное решение задачи 3
Поскольку запросы загрузки запускаются одновременно, нет гарантии, что результат последнего будет последним. Результаты могут приходить в любом порядке.
Таким образом, если вы сравниваете текущий индекс с lastIndex в качестве условия завершения, вы рискуете потерять результаты для некоторых репозиториев.
Если запрос, обрабатывающий последний репозиторий, возвращается быстрее, чем некоторые предыдущие запросы (что вероятно произойдёт), все результаты запросов, которые занимают больше времени, будут потеряны.
Один из способов исправить это — ввести индекс и проверить, все ли репозитории уже обработаны:
val allUsers = Collections.synchronizedList(mutableListOf<User>())
val numberOfProcessed = AtomicInteger()
for (repo in repos) {
    service.getRepoContributorsCall(req.org, repo.name)
        .onResponse { responseUsers ->
            logUsers(repo, responseUsers)
            val users = responseUsers.bodyList()
            allUsers += users
            if (numberOfProcessed.incrementAndGet() == repos.size) {
                updateResults(allUsers.aggregate())
            }
        }
}
Этот код использует синхронизированный вариант списка и AtomicInteger(), потому что, в общем случае, нет гарантии, что различные обратные вызовы, обрабатывающие getRepoContributors() запросы, всегда будут вызываться из одного потока.
Третье попытанное решение задачи 3
Ещё лучшее решение — использовать класс CountDownLatch. Он хранит счётчик, инициализированный количеством репозиториев. Этот счётчик уменьшается после обработки каждого репозитория. Затем он ожидает, пока счётчик не станет равным нулю, прежде чем обновлять результаты:
val countDownLatch = CountDownLatch(repos.size)
for (repo in repos) {
    service.getRepoContributorsCall(req.org, repo.name)
        .onResponse { responseUsers ->
            // processing repository
            countDownLatch.countDown()
        }
}
countDownLatch.await()
updateResults(allUsers.aggregate())
Результат затем обновляется из главного потока. Это более прямо, чем делегирование логики дочерним потокам.
После рассмотрения этих трёх попыток решения, вы можете увидеть, что написание корректного кода с обратными вызовами — непростая и подверженная ошибкам задача, особенно при наличии нескольких подлежащих потоков и синхронизации.
Функции приостановки
Вы можете реализовать ту же логику, используя функции приостановки. Вместо возвращения Call<List<Repo>>, определите вызов API как функцию приостановки следующим образом:
interface GitHubService {
    @GET("orgs/{org}/repos?per_page=100")
    suspend fun getOrgRepos(
        @Path("org") org: String
    ): List<Repo>
}
getOrgRepos()определяется как функцияsuspend. Когда вы используете функцию приостановки для выполнения запроса, поток выполнения не блокируется. Более подробные сведения о работе с этим будут представлены в последующих разделах.getOrgRepos()возвращает результат непосредственно, вместо возвращенияCall. Если результат неудачный, выбрасывается исключение.
В качестве альтернативы, Retrofit позволяет возвращать результат, обернутый в Response. В этом случае, тело результата предоставляется, и есть возможность вручную проверить наличие ошибок. В этом руководстве используются версии, возвращающие Response.
В src/contributors/GitHubService.kt, добавьте следующие объявления в интерфейс GitHubService:
interface GitHubService {
    // getOrgReposCall & getRepoContributorsCall declarations

    @GET("orgs/{org}/repos?per_page=100")
    suspend fun getOrgRepos(
        @Path("org") org: String
    ): Response<List<Repo>>

    @GET("repos/{owner}/{repo}/contributors?per_page=100")
    suspend fun getRepoContributors(
        @Path("owner") owner: String,
        @Path("repo") repo: String
    ): Response<List<User>>
}
Задача 4
Ваша задача — изменить код функции, загружающей участников, чтобы использовать две новые функции приостановки, getOrgRepos() и getRepoContributors(). Новая функция loadContributorsSuspend() помечена как suspend для использования нового API.
Скопируйте реализацию
loadContributorsBlocking()изsrc/tasks/Request1Blocking.ktвloadContributorsSuspend(), которая определена вsrc/tasks/Request4Suspend.kt.Измените код так, чтобы использовались новые функции приостановки вместо функций, возвращающих
Call.Запустите программу, выбрав опцию ПРИОСТАНОВИТЬ, и убедитесь, что пользовательский интерфейс по-прежнему отзывчив во время выполнения запросов к GitHub.
Решение задачи 4
Замените .getOrgReposCall(req.org).execute() на .getOrgRepos(req.org) и повторите ту же замену для второго запроса "contributors":
suspend fun loadContributorsSuspend(service: GitHubService, req: RequestData): List<User> {
    val repos = service
        .getOrgRepos(req.org)
        .also { logRepos(req, it) }
        .bodyList()

    return repos.flatMap { repo ->
        service.getRepoContributors(req.org, repo.name)
            .also { logUsers(repo, it) }
            .bodyList()
    }.aggregate()
}
loadContributorsSuspend()должна быть определена как функцияsuspend.Вам больше не нужно вызывать
execute, которая раньше возвращалаResponse, поскольку теперь функции API возвращаютResponseнапрямую. Обратите внимание, что эта деталь специфична для библиотеки Retrofit. С другими библиотеками API будет другим, но концепция остаётся такой же.
Сопрограммы
Код с функциями приостановки выглядит похожим на "блокирующий" вариант. Главное различие с блокирующим вариантом заключается в том, что вместо блокировки потока сопрограмма приостанавливается:
block -> suspend
thread -> coroutine
Запуск новой сопрограммы
Если вы посмотрите на то, как используется loadContributorsSuspend() в src/contributors/Contributors.kt, вы увидите, что она вызывается внутри launch . launch — это функция библиотеки, которая принимает лямбда-выражение в качестве аргумента:
launch {
    val users = loadContributorsSuspend(req)
    updateResults(users, startTime)
}
Здесь launch запускает новую вычислительную операцию, которая отвечает за загрузку данных и отображение результатов. Вычислительная операция приостанавливается – при выполнении сетевых запросов она приостанавливается и освобождает соответствующий поток. При возврате результата сетевого запроса вычислительная операция возобновляется.
Такая приостанавливаемая вычислительная операция называется сопрограммой. Таким образом, в этом случае launch запускает новую сопрограмму, отвечающую за загрузку данных и отображение результатов.
Сопрограммы выполняются поверх потоков и могут быть приостановлены. Когда сопрограмма приостанавливается, соответствующая вычислительная операция приостанавливается, удаляется из потока и хранится в памяти. Тем временем поток свободен для выполнения других задач:
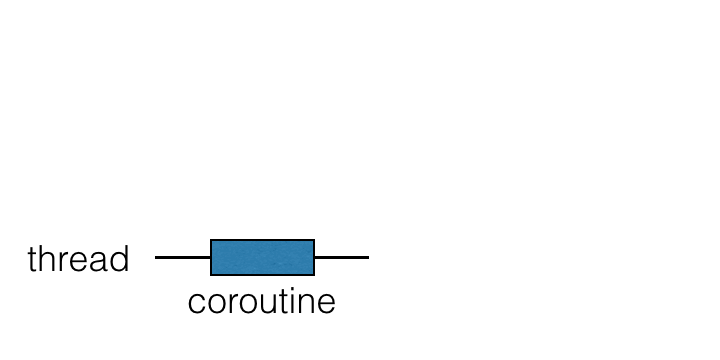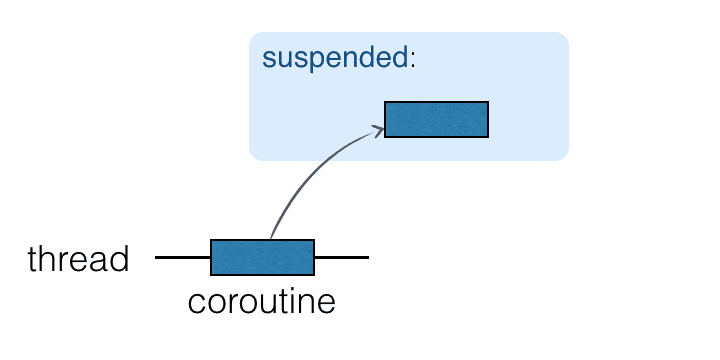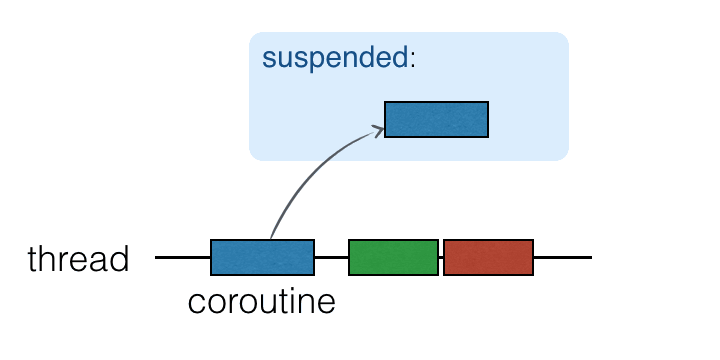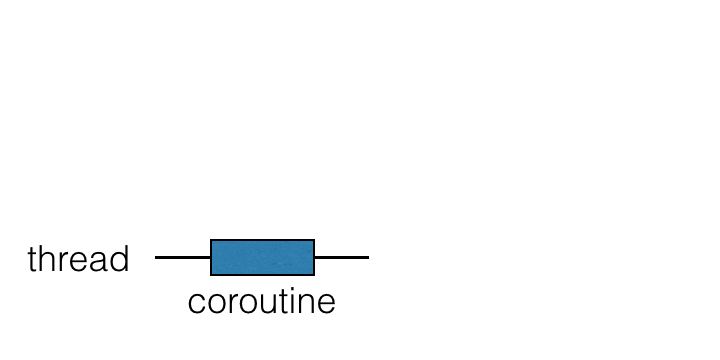
Когда вычислительная операция готова к продолжению, она возвращается в поток (не обязательно в тот же самый).
В примере loadContributorsSuspend() каждый запрос "contributors" теперь ожидает результата, используя механизм приостановки. Сначала отправляется новый запрос. Затем, в ожидании ответа, вся сопрограмма "загрузка участников", запущенная функцией launch , приостанавливается.
Сопрограмма возобновляется только после получения соответствующего ответа:
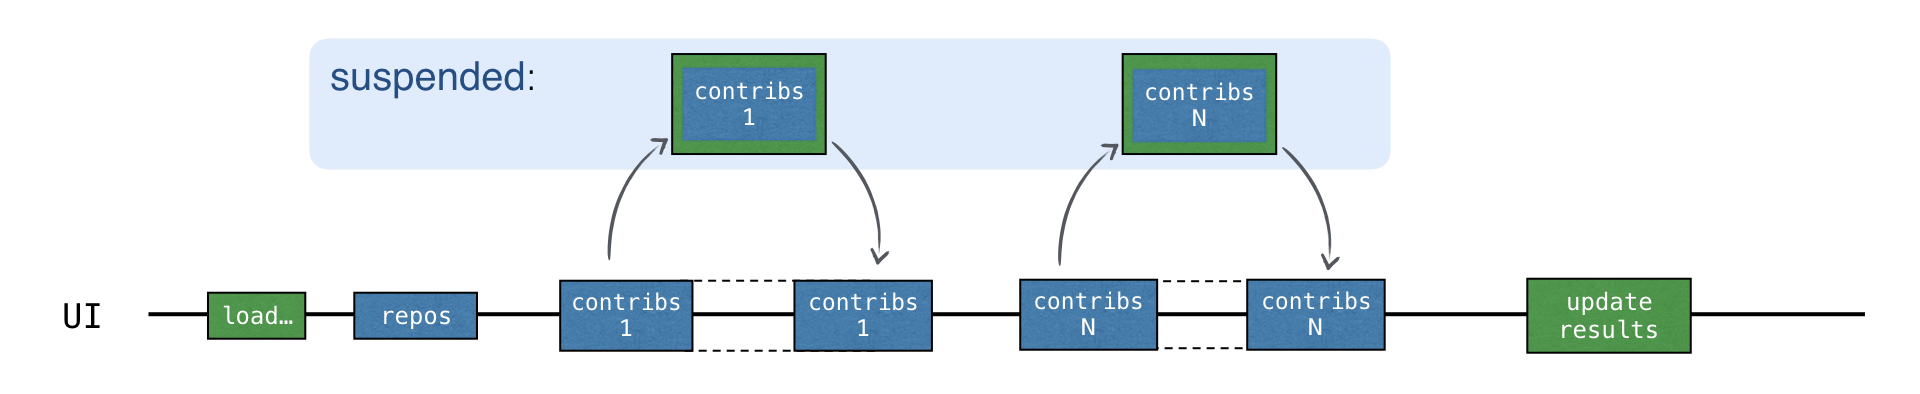
Пока ответ ожидает получения, поток свободен для выполнения других задач. Пользовательский интерфейс остаётся отзывчивым, несмотря на все запросы, выполняемые в основном потоке пользовательского интерфейса:
-
Запустите программу с опцией ПРИОСТАНОВИТЬ. Лог подтверждает, что все запросы отправлены в основной поток пользовательского интерфейса:
2538 [AWT-EventQueue-0 @coroutine#1] INFO  Contributors - kotlin: loaded 30 repos
2729 [AWT-EventQueue-0 @coroutine#1] INFO  Contributors - ts2kt: loaded 11 contributors
3029 [AWT-EventQueue-0 @coroutine#1] INFO  Contributors - kotlin-koans: loaded 45 contributors
...
11252 [AWT-EventQueue-0 @coroutine#1] INFO  Contributors - kotlin-coroutines-workshop: loaded 1 contributors
-
Лог может показать, в какой сопрограмме выполняется соответствующий код. Для этого откройте Запуск | Редактирование конфигураций и добавьте параметр VM
-Dkotlinx.coroutines.debug: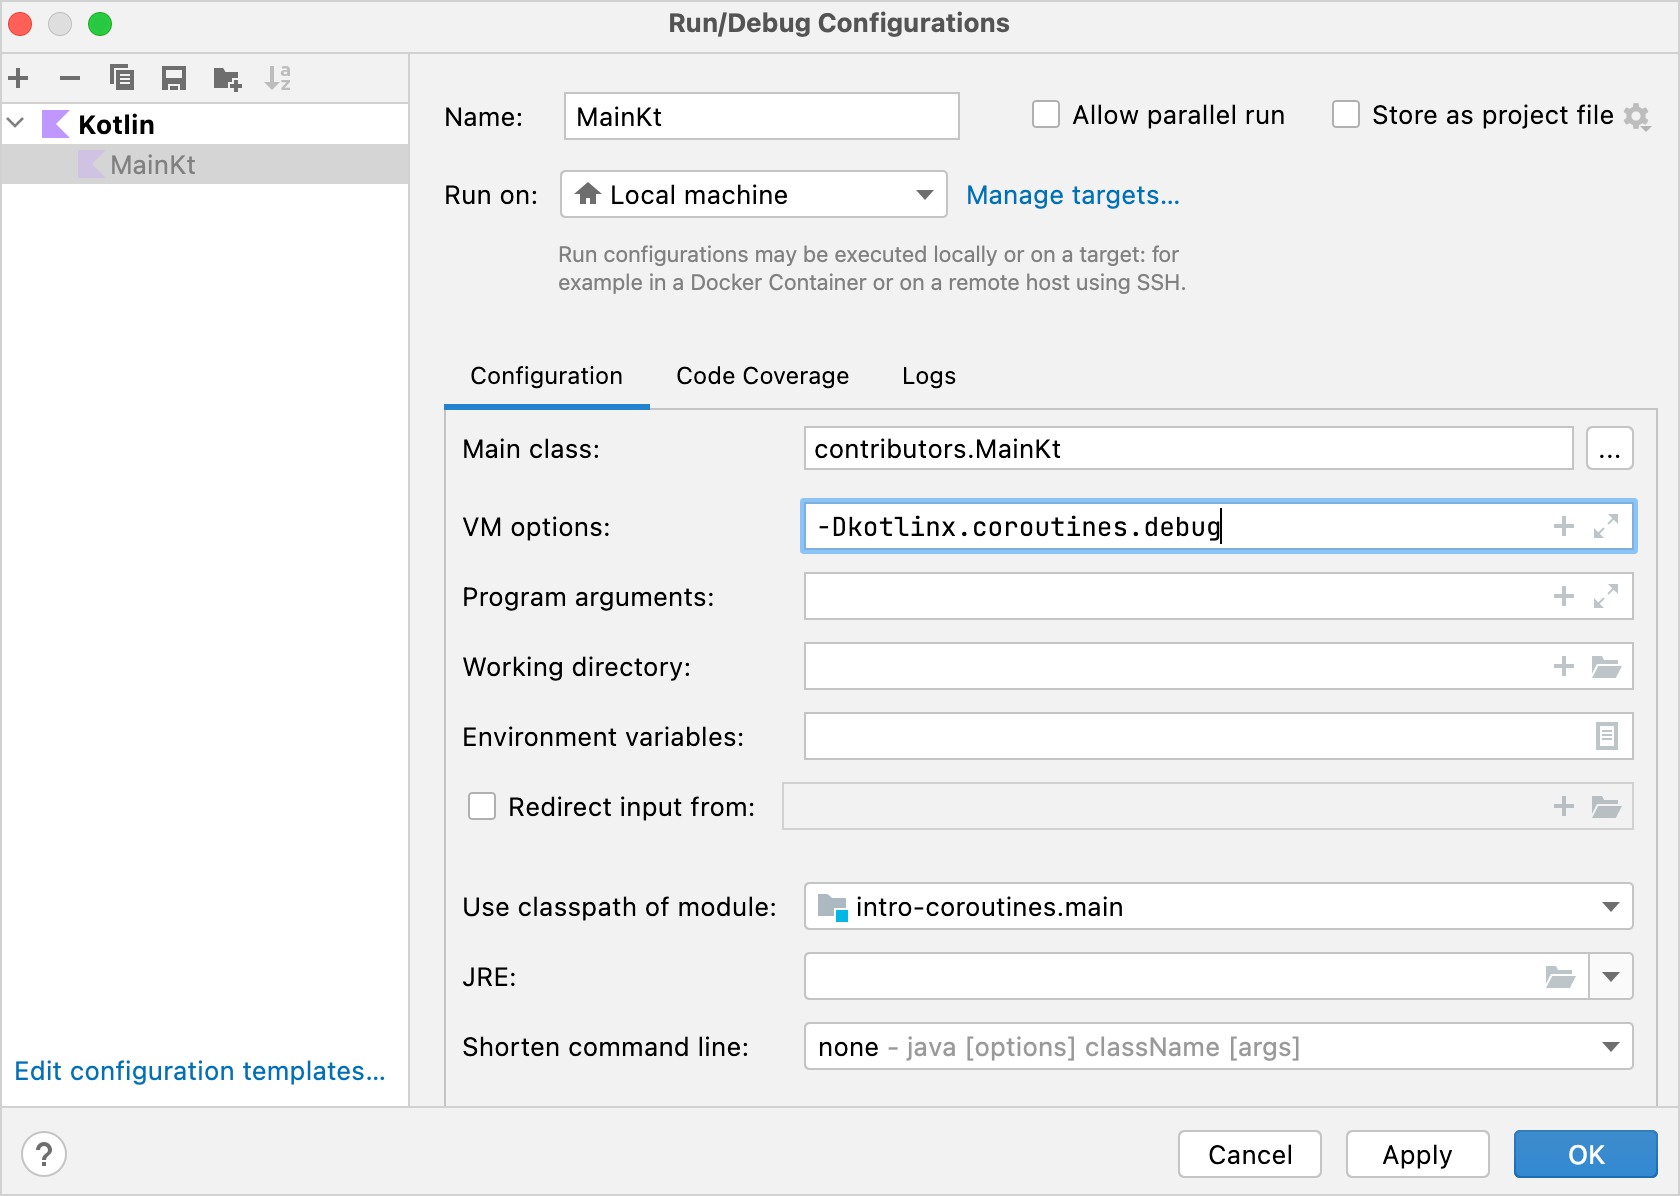
Имя сопрограммы будет добавлено к имени потока во время выполнения
main()с этим параметром. Вы также можете изменить шаблон для запуска всех файлов Kotlin и включить этот параметр по умолчанию.
Теперь весь код выполняется в одной сопрограмме, "сопрограмме загрузки участников", упомянутой выше, обозначенной как @coroutine#1. В ожидании результата не следует повторно использовать поток для отправки других запросов, так как код написан последовательно. Новый запрос отправляется только после получения предыдущего результата.
Функции приостановки справедливо относятся к потокам и не блокируют их в ожидании. Однако это пока не вносит никакой параллельности.
Асинхронность
Kotlin сопрограммы потребляют гораздо меньше ресурсов, чем потоки. Каждый раз, когда вы хотите запустить новое асинхронное вычисление, можно создать новую сопрограмму вместо этого.
Для запуска новой сопрограммы используйте один из основных строителей сопрограмм: launch, async, или runBlocking. Различные библиотеки могут определять дополнительные строители сопрограмм.
async запускает новую сопрограмму и возвращает объект Deferred. Deferred представляет собой концепцию, известную другими именами, такими как Future или Promise. Он хранит вычисление, но откладывает момент получения окончательного результата; он обещает результат в будущем.
Основное различие между async и launch заключается в том, что launch используется для запуска вычисления, от которого не ожидается получение конкретного результата. launch возвращает Job, представляющий сопрограмму. Можно дождаться её завершения, вызвав Job.join().
Deferred — это универсальный тип, который расширяет Job. Вызов async может вернуть Deferred<Int> или Deferred<CustomType>, в зависимости от того, что возвращает лямбда (последнее выражение внутри лямбды — результат).
Чтобы получить результат сопрограммы, можно вызвать await() на экземпляре Deferred. Во время ожидания результата сопрограмма, из которой вызван этот await(), приостанавливается:
import kotlinx.coroutines.*

fun main() = runBlocking {
    val deferred: Deferred<Int> = async {
        loadData()
    }
    println("waiting...")
    println(deferred.await())
}

suspend fun loadData(): Int {
    println("loading...")
    delay(1000L)
    println("loaded!")
    return 42
}
runBlocking используется как мост между обычными и приостанавливаемыми функциями, или между блокирующим и неблокирующим мирами. Он работает как адаптер для запуска главной сопрограммы верхнего уровня. Он предназначен в основном для использования в функциях main() и тестах.
Если есть список отложенных объектов, можно вызвать awaitAll() для ожидания результатов всех из них:
import kotlinx.coroutines.*

fun main() = runBlocking {
    val deferreds: List<Deferred<Int>> = (1..3).map {
        async {
            delay(1000L * it)
            println("Loading $it")
            it
        }
    }
    val sum = deferreds.awaitAll().sum()
    println("$sum")
}
Когда каждый запрос "contributors" запускается в новой сопрограмме, все запросы запускаются асинхронно. Новый запрос может быть отправлен до получения результата предыдущего:
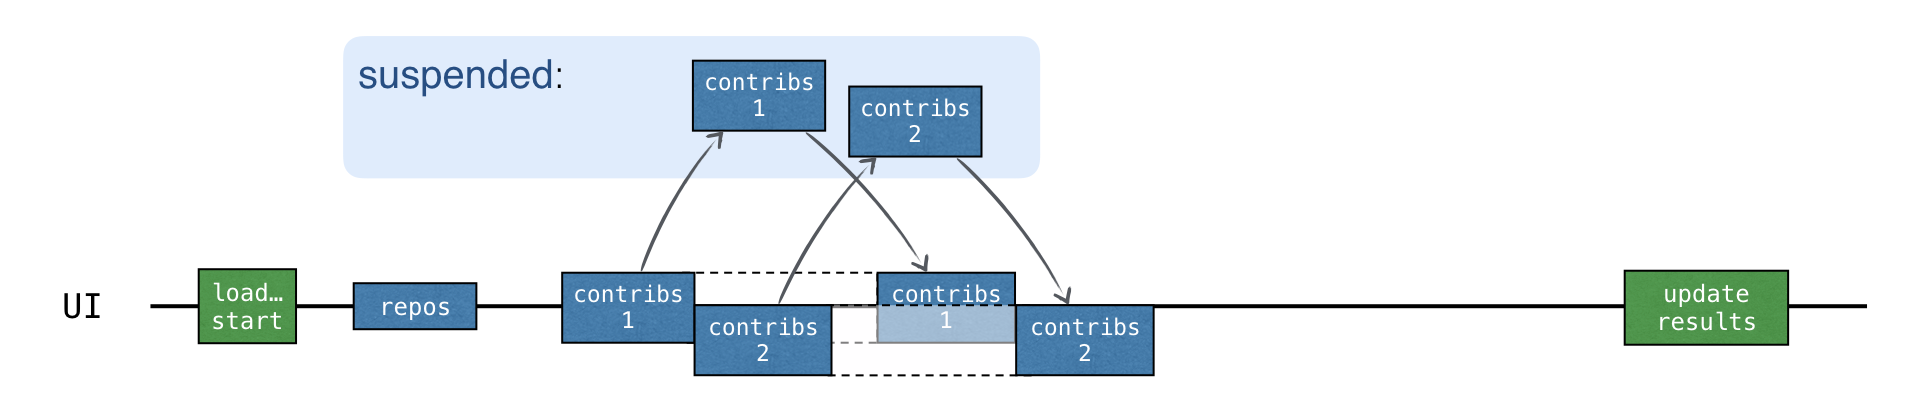
Общее время загрузки примерно такое же, как в версии CALLBACKS, но оно не требует обратных вызовов. Более того, async явно выделяет в коде, какие части выполняются параллельно.
Задача 5
В файле Request5Concurrent.kt реализуйте функцию loadContributorsConcurrent() с помощью предыдущей функции loadContributorsSuspend().
Подсказка к задаче 5
Вы можете запустить новую сопрограмму только внутри области сопрограммы. Скопируйте содержимое из loadContributorsSuspend() в вызов coroutineScope, чтобы вы могли вызывать там функции async:
suspend fun loadContributorsConcurrent(
    service: GitHubService,
    req: RequestData
): List<User> = coroutineScope {
    // ...
}
Основывайте своё решение на следующей схеме:
val deferreds: List<Deferred<List<User>>> = repos.map { repo ->
    async {
        // load contributors for each repo
    }
}
deferreds.awaitAll() // List<List<User>>
Решение задачи 5
Оборачивайте каждый запрос "contributors" в async, чтобы создать столько сопрограмм, сколько репозиториев. async возвращает Deferred<List<User>>. Это не проблема, потому что создание новых сопрограмм не очень ресурсоёмко, так что можно создавать столько, сколько нужно.
-
Вы больше не можете использовать
flatMap, потому что результатmapтеперь — список объектовDeferred, а не список списков.awaitAll()возвращаетList<List<User>>, поэтому вызовитеflatten().aggregate()для получения результата:suspend fun loadContributorsConcurrent( service: GitHubService, req: RequestData ): List<User> = coroutineScope { val repos = service .getOrgRepos(req.org) .also { logRepos(req, it) } .bodyList() val deferreds: List<Deferred<List<User>>> = repos.map { repo -> async { service.getRepoContributors(req.org, repo.name) .also { logUsers(repo, it) } .bodyList() } } deferreds.awaitAll().flatten().aggregate() } Запустите код и проверьте лог. Все сопрограммы по-прежнему выполняются в основном потоке пользовательского интерфейса, потому что многопоточность ещё не использована, но вы уже можете увидеть преимущества параллельного запуска сопрограмм.
-
Чтобы изменить этот код на запуск сопрограмм "contributors" в разных потоках из общего пула потоков, укажите
Dispatchers.Defaultв качестве аргумента контекста для функцииasync:async(Dispatchers.Default) { }CoroutineDispatcherопределяет, в каком потоке или потоках должна выполняться соответствующая сопрограмма. Если вы не укажете его в качестве аргумента,asyncбудет использовать диспетчер из внешней области.Dispatchers.Defaultпредставляет собой общий пул потоков в JVM. Этот пул обеспечивает возможность параллельного выполнения. Он состоит из столько потоков, сколько доступно ядер процессора, но все равно будет иметь два потока, если всего одно ядро.
-
Измените код в функции
loadContributorsConcurrent()для запуска новых сопрограмм в разных потоках из общего пула потоков. Также добавьте дополнительное логирование перед отправкой запроса:async(Dispatchers.Default) { log("starting loading for ${repo.name}") service.getRepoContributors(req.org, repo.name) .also { logUsers(repo, it) } .bodyList() } -
Запустите программу ещё раз. В логе вы сможете увидеть, что каждая сопрограмма может быть запущена в одном потоке из пула потоков и продолжена в другом:
1946 [DefaultDispatcher-worker-2 @coroutine#4] INFO  Contributors - starting loading for kotlin-koans
1946 [DefaultDispatcher-worker-3 @coroutine#5] INFO  Contributors - starting loading for dokka
1946 [DefaultDispatcher-worker-1 @coroutine#3] INFO  Contributors - starting loading for ts2kt
...
2178 [DefaultDispatcher-worker-1 @coroutine#4] INFO  Contributors - kotlin-koans: loaded 45 contributors
2569 [DefaultDispatcher-worker-1 @coroutine#5] INFO  Contributors - dokka: loaded 36 contributors
2821 [DefaultDispatcher-worker-2 @coroutine#3] INFO  Contributors - ts2kt: loaded 11 contributors
Например, в этом фрагменте лога
coroutine#4запущена в потокеworker-2и продолжена в потокеworker-1.
В src/contributors/Contributors.kt, проверьте реализацию опции CONCURRENT:
-
Чтобы запустить сопрограмму только в главном потоке пользовательского интерфейса, укажите
Dispatchers.Mainв качестве аргумента:launch(Dispatchers.Main) { updateResults() }Если основной поток занят, когда вы запускаете новую сопрограмму в нём, сопрограмма приостанавливается и планируется для выполнения в этом потоке. Сопрограмма возобновится только когда поток станет свободным.
Считается хорошей практикой использовать диспетчер из внешней области, а не явно указывать его на каждом конце. Если вы определите
loadContributorsConcurrent()без передачиDispatchers.Defaultв качестве аргумента, вы можете вызвать эту функцию в любом контексте: с диспетчеромDefault, с основным потоком пользовательского интерфейса или с пользовательским диспетчером.Как вы увидите позже, при вызове
loadContributorsConcurrent()из тестов, вы можете вызвать его в контексте сTestDispatcher, что упрощает тестирование. Это делает решение гораздо более гибким.
-
Чтобы указать диспетчер на стороне вызывающей функции, внесите следующие изменения в проект, позволяя
loadContributorsConcurrentзапускать сопрограммы в унаследованном контексте:launch(Dispatchers.Default) { val users = loadContributorsConcurrent(service, req) withContext(Dispatchers.Main) { updateResults(users, startTime) } }updateResults()должен вызываться в главном потоке пользовательского интерфейса, поэтому вы вызываете его с контекстомDispatchers.Main.withContext()вызывает заданный код с указанным контекстом сопрограммы, приостанавливается до его завершения и возвращает результат. Альтернативный, но более громоздкий способ выразить это — запустить новую сопрограмму и явно дождаться (с помощью приостановки) её завершения:launch(context) { ... }.join().
Запустите код и убедитесь, что сопрограммы выполняются в потоках из пула потоков.
Структурированная конвейерность
Область распределения корутин отвечает за структуру и родительско-дочерние отношения между различными корутинами. Новые корутины обычно необходимо запускать внутри области.
Контекст корутины хранит дополнительную техническую информацию, используемую для запуска данной корутины, например, пользовательское имя корутины или диспетчер, определяющий потоки, на которых должна планироваться корутина.
Когда launch, async, или runBlocking используются для запуска новой корутины, они автоматически создают соответствующую область. Все эти функции принимают лямбда-выражение с получателем в качестве аргумента, и CoroutineScope — это неявный тип получателя:
launch { /* this: CoroutineScope */ }
Новые корутины могут запускаться только внутри области.
launchиasyncобъявлены как расширения дляCoroutineScope, поэтому при их вызове всегда необходимо передавать неявного или явного получателя.Корутина, запущенная с помощью
runBlocking, является единственным исключением, потому чтоrunBlockingопределена как функция верхнего уровня. Но поскольку она блокирует текущий поток, она предназначена в основном для использования в функцияхmain()и тестах в качестве функции-моста.
Новая корутина внутри runBlocking, launch, или async запускается автоматически внутри области:
import kotlinx.coroutines.*

fun main() = runBlocking { /* this: CoroutineScope */
    launch { /* ... */ }
    // the same as:
    this.launch { /* ... */ }
}
При вызове launch внутри runBlocking, она вызывается как расширение для неявного получателя типа CoroutineScope. В качестве альтернативы вы можете явно написать this.launch.
Вложенную корутину (запущенную в этом примере с помощью launch) можно рассматривать как дочернюю корутину внешней корутины (запущенной с помощью runBlocking). Это отношение «родитель-дочерний» реализовано через области; дочерняя корутина запускается из области, соответствующей родительской корутине.
Можно создать новую область без запуска новой корутины, используя функцию coroutineScope. Чтобы структурированно запустить новые корутины внутри функции suspend без доступа к внешней области, можно создать новую область корутины, которая автоматически становится дочерней области, из которой вызвана функция suspend. loadContributorsConcurrent() — хороший пример.
Также можно запустить новую корутину из глобальной области, используя GlobalScope.async или GlobalScope.launch. Это создаст независимую корутину верхнего уровня.
Механизм, лежащий в основе структуры корутин, называется структурированной конвейерностью. Он предоставляет следующие преимущества по сравнению с глобальными областями:
Область в целом отвечает за дочерние корутины, срок жизни которых привязан к сроку жизни области.
Область может автоматически отменять дочерние корутины, если что-то пойдет не так или пользователь изменит свое мнение и решит отменить операцию.
Область автоматически ожидает завершения всех дочерних корутин. Следовательно, если область соответствует корутине, родительская корутина не завершается, пока все корутины, запущенные в ее области, не завершатся.
При использовании GlobalScope.async, нет структуры, которая связывает несколько корутин в более узкую область. Корутины, запущенные из глобальной области, все независимы — их срок жизни ограничен только сроком жизни всего приложения. Можно сохранить ссылку на корутину, запущенную из глобальной области, и дождаться ее завершения или явно отменить ее, но этого не произойдет автоматически, как это происходит со структурированной конвейерностью.
Отмена загрузки участников
Рассмотрим два варианта функции loadContributorsConcurrent(). Первый использует coroutineScope для запуска всех дочерних корутин, а второй — GlobalScope. Сравните, как оба варианта ведут себя, когда вы пытаетесь отменить родительскую корутину.
Скопируйте реализацию
loadContributorsConcurrent()изRequest5Concurrent.ktвloadContributorsNotCancellable()вRequest5NotCancellable.kt, а затем удалите создание новойcoroutineScope.-
Вызовы
asyncтеперь не могут быть разрешены, поэтому запустите их, используяGlobalScope.async.suspend fun loadContributorsNotCancellable( service: GitHubService, req: RequestData ): List<User> { // #1 // ... GlobalScope.async { // #2 log("starting loading for ${repo.name}") // load repo contributors } // ... return deferreds.awaitAll().flatten().aggregate() // #3 }Функция теперь возвращает результат напрямую, а не как последнее выражение внутри лямбда-выражения (строки
#1и#3).Все корутины «участников» запускаются внутри
GlobalScope, а не как дочерние корутины области корутин (строка#2).
-
Добавьте 3-секундную задержку ко всем корутинам, отправляющим запросы, чтобы у вас было достаточно времени для отмены загрузки после запуска корутин, но до отправки запросов:
suspend fun loadContributorsConcurrent(
    service: GitHubService,
    req: RequestData
): List<User> = coroutineScope {
    // ...
    GlobalScope.async {
        log("starting loading for ${repo.name}")
        delay(3000)
        // load repo contributors
    }
    // ...
}
Запустите программу и выберите вариант CONCURRENT для загрузки участников.
-
Дождитесь запуска всех корутин «участников», а затем нажмите Отмена. В журнале новых результатов нет, что означает, что все запросы действительно были отменены:
2896 [AWT-EventQueue-0 @coroutine#1] INFO  Contributors - kotlin: loaded 40 repos
2901 [DefaultDispatcher-worker-2 @coroutine#4] INFO  Contributors - starting loading for kotlin-koans
...
2909 [DefaultDispatcher-worker-5 @coroutine#36] INFO  Contributors - starting loading for mpp-example
/* click on 'cancel' */
/* no requests are sent */
-
Повторите шаг 5, но на этот раз выберите вариант
NOT_CANCELLABLE.2570 [AWT-EventQueue-0 @coroutine#1] INFO Contributors - kotlin: loaded 30 repos 2579 [DefaultDispatcher-worker-1 @coroutine#4] INFO Contributors - starting loading for kotlin-koans ... 2586 [DefaultDispatcher-worker-6 @coroutine#36] INFO Contributors - starting loading for mpp-example /* click on 'cancel' */ /* but all the requests are still sent: */ 6402 [DefaultDispatcher-worker-5 @coroutine#4] INFO Contributors - kotlin-koans: loaded 45 contributors ... 9555 [DefaultDispatcher-worker-8 @coroutine#36] INFO Contributors - mpp-example: loaded 8 contributors
В этом случае корутины не отменяются, и все запросы по-прежнему отправляются.
-
Проверьте, как происходит отмена в программе «участники». Когда нажимается кнопка Отмена, основная корутина «загрузки» явно отменяется, и дочерние корутины отменяются автоматически:
interface Contributors {

    fun loadContributors() {
        // ...
        when (getSelectedVariant()) {
            CONCURRENT -> {
                launch {
                    val users = loadContributorsConcurrent(service, req)
                    updateResults(users, startTime)
                }.setUpCancellation()      // #1
            }
        }
    }

    private fun Job.setUpCancellation() {
        val loadingJob = this              // #2

        // cancel the loading job if the 'cancel' button was clicked:
        val listener = ActionListener {
            loadingJob.cancel()            // #3
            updateLoadingStatus(CANCELED)
        }
        // add a listener to the 'cancel' button:
        addCancelListener(listener)

        // update the status and remove the listener
        // after the loading job is completed
    }
}
Функция launch возвращает экземпляр Job. Job хранит ссылку на корутину «загрузка», которая загружает все данные и обновляет результаты. Вы можете вызвать функцию-расширение setUpCancellation() для нее (строка #1), передав экземпляр Job в качестве получателя.
Другой способ выразить это — явно написать:
val job = launch { }
job.setUpCancellation()
Для повышения читаемости вы можете обратиться к получателю функции
setUpCancellation()внутри функции с новой переменнойloadingJob(строка#2).Затем вы можете добавить слушателя к кнопке Отмена, чтобы при ее нажатии корутина
loadingJobотменялась (строка#3).
При использовании структурированной конвейерности необходимо отменить только родительскую корутину, и это автоматически распространяет отмену на все дочерние корутины.
Использование контекста внешней области
При запуске новых корутин внутри данной области гораздо проще убедиться, что все они выполняются в одном контексте. Также гораздо проще заменить контекст при необходимости.
Теперь самое время узнать, как работает использование диспетчера из внешней области. Новая область, созданная с помощью coroutineScope или с помощью билдеров корутин, всегда наследует контекст от внешней области. В данном случае внешняя область — это область, из которой была вызвана функция suspend loadContributorsConcurrent():
launch(Dispatchers.Default) {  // outer scope
    val users = loadContributorsConcurrent(service, req)
    // ...
}
Все вложенные корутины автоматически запускаются с унаследованным контекстом. Диспетчер является частью этого контекста. Вот почему все корутины, запущенные с помощью async , запускаются с контекстом по умолчанию:
suspend fun loadContributorsConcurrent(
    service: GitHubService, req: RequestData
): List<User> = coroutineScope {
    // this scope inherits the context from the outer scope
    // ...
    async {   // nested coroutine started with the inherited context
        // ...
    }
    // ...
}
При использовании структурированной конвейерности можно указать основные элементы контекста (например, диспетчер) один раз при создании корутины верхнего уровня. Все вложенные корутины затем наследуют контекст и изменяют его только при необходимости.
Отображение прогресса
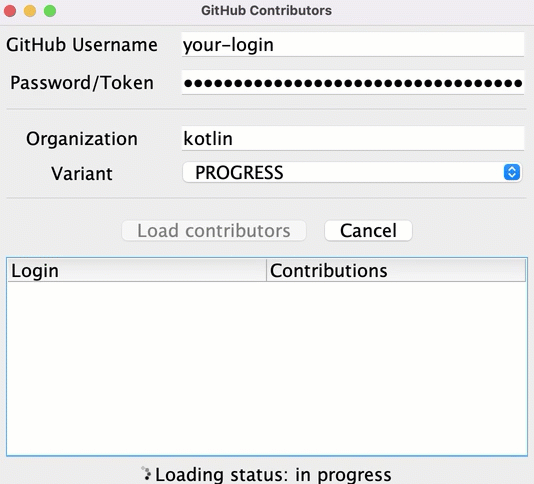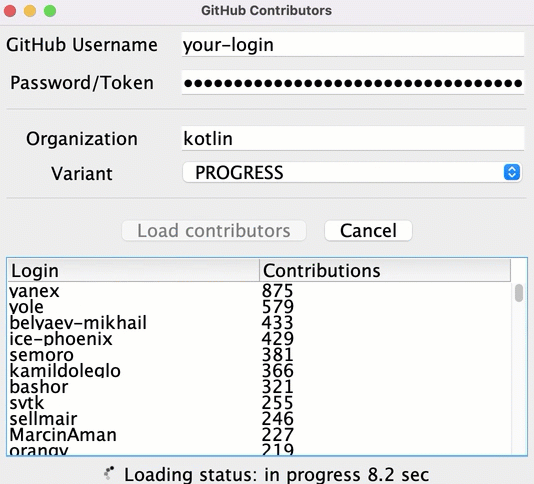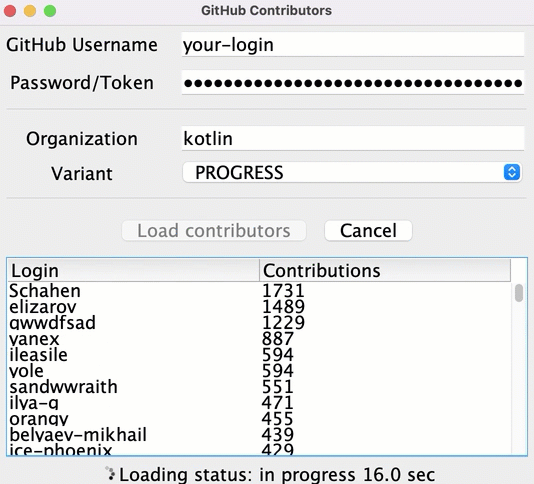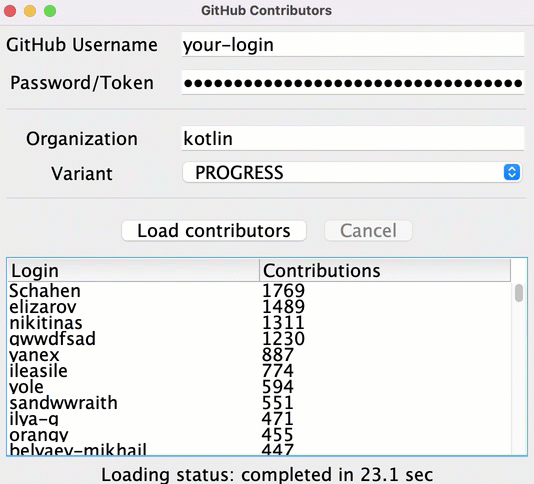
Несмотря на то, что информация для некоторых репозиториев загружается довольно быстро, пользователь видит результирующий список только после загрузки всех данных. До этого момента значок загрузчика отображает прогресс, но нет никакой информации о текущем состоянии или уже загруженных участниках.
Вы можете отображать промежуточные результаты раньше и отображать всех участников после загрузки данных для каждого репозитория:
Для реализации этой функциональности в src/tasks/Request6Progress.kt, вам необходимо передать логику обновления пользовательского интерфейса в качестве обратного вызова, чтобы он вызывался на каждом промежуточном шаге:
suspend fun loadContributorsProgress(
    service: GitHubService,
    req: RequestData,
    updateResults: suspend (List<User>, completed: Boolean) -> Unit
) {
    // loading the data
    // calling `updateResults()` on intermediate states
}
В месте вызова в Contributors.kt, обратный вызов передается для обновления результатов из потока Main для параметра PROGRESS:
launch(Dispatchers.Default) {
    loadContributorsProgress(service, req) { users, completed ->
        withContext(Dispatchers.Main) {
            updateResults(users, startTime, completed)
        }
    }
}
Параметр
updateResults()объявлен какsuspendвloadContributorsProgress(). Необходимо вызватьwithContext, которая является функциейsuspendвнутри соответствующего лямбда-аргумента.Обратный вызов
updateResults()принимает дополнительный булевый параметр в качестве аргумента, указывающий, завершена ли загрузка и являются ли результаты окончательными.
Задача 6
В файле Request6Progress.kt реализуйте функцию loadContributorsProgress(), которая отображает промежуточный прогресс. Опирайтесь на функцию loadContributorsSuspend() из Request4Suspend.kt.
Используйте простую версию без конкурентности; вы добавите её позже в следующем разделе.
Промежуточный список участников должен быть показан в "агрегированном" состоянии, а не просто список пользователей, загруженных для каждого репозитория.
Общее количество вкладов для каждого пользователя должно увеличиваться при загрузке данных для каждого нового репозитория.
Решение задачи 6
Для хранения промежуточного списка загруженных участников в "агрегированном" состоянии определите переменную allUsers, которая хранит список пользователей, а затем обновляйте её после загрузки участников для каждого нового репозитория:
suspend fun loadContributorsProgress(
    service: GitHubService,
    req: RequestData,
    updateResults: suspend (List<User>, completed: Boolean) -> Unit
) {
    val repos = service
        .getOrgRepos(req.org)
        .also { logRepos(req, it) }
        .bodyList()

    var allUsers = emptyList<User>()
    for ((index, repo) in repos.withIndex()) {
        val users = service.getRepoContributors(req.org, repo.name)
            .also { logUsers(repo, it) }
            .bodyList()

        allUsers = (allUsers + users).aggregate()
        updateResults(allUsers, index == repos.lastIndex)
    }
}
Последовательный против конкурентного
Обратный вызов updateResults() вызывается после завершения каждого запроса:
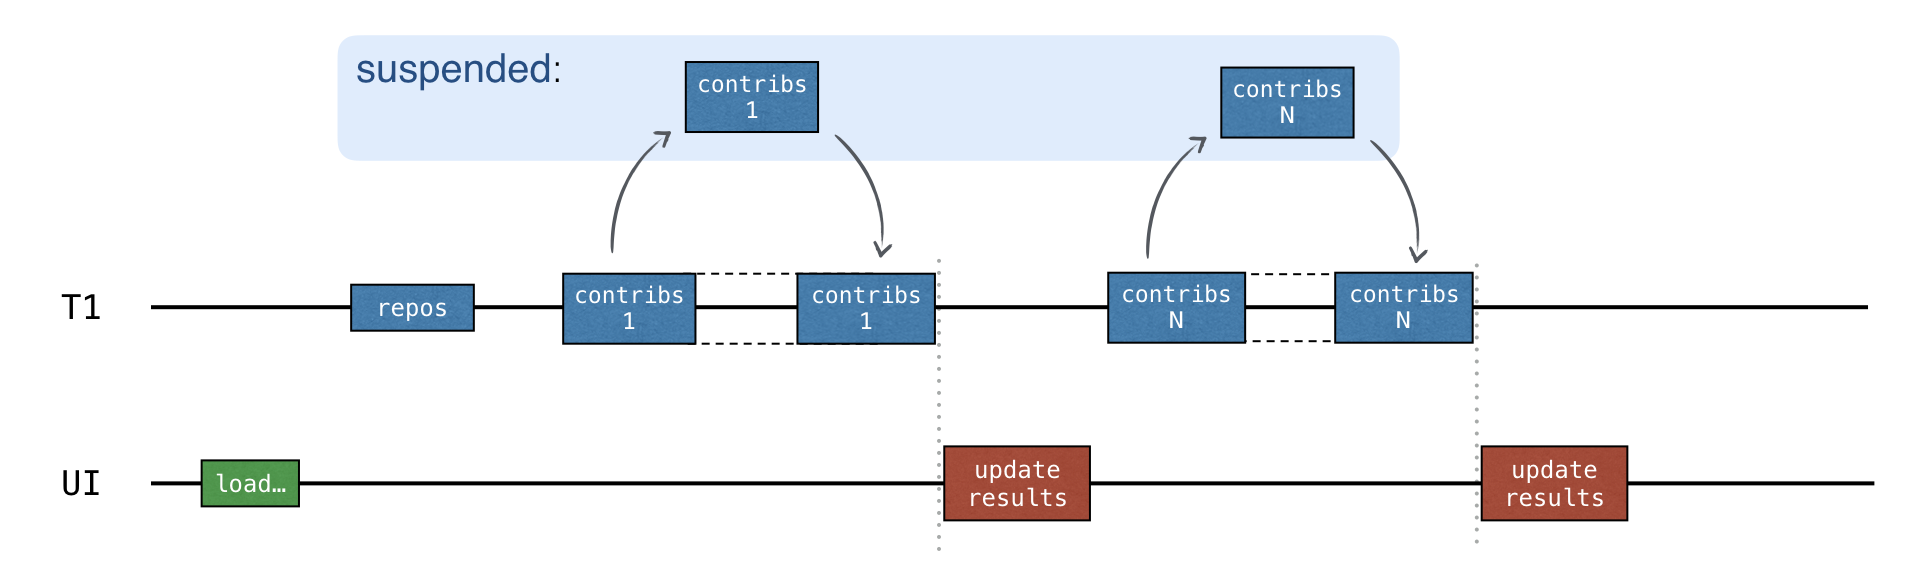
Этот код не включает конкурентности. Он последовательный, поэтому вам не нужна синхронизация.
Лучшим вариантом было бы отправить запросы конкурентно и обновить промежуточные результаты после получения ответа для каждого репозитория:
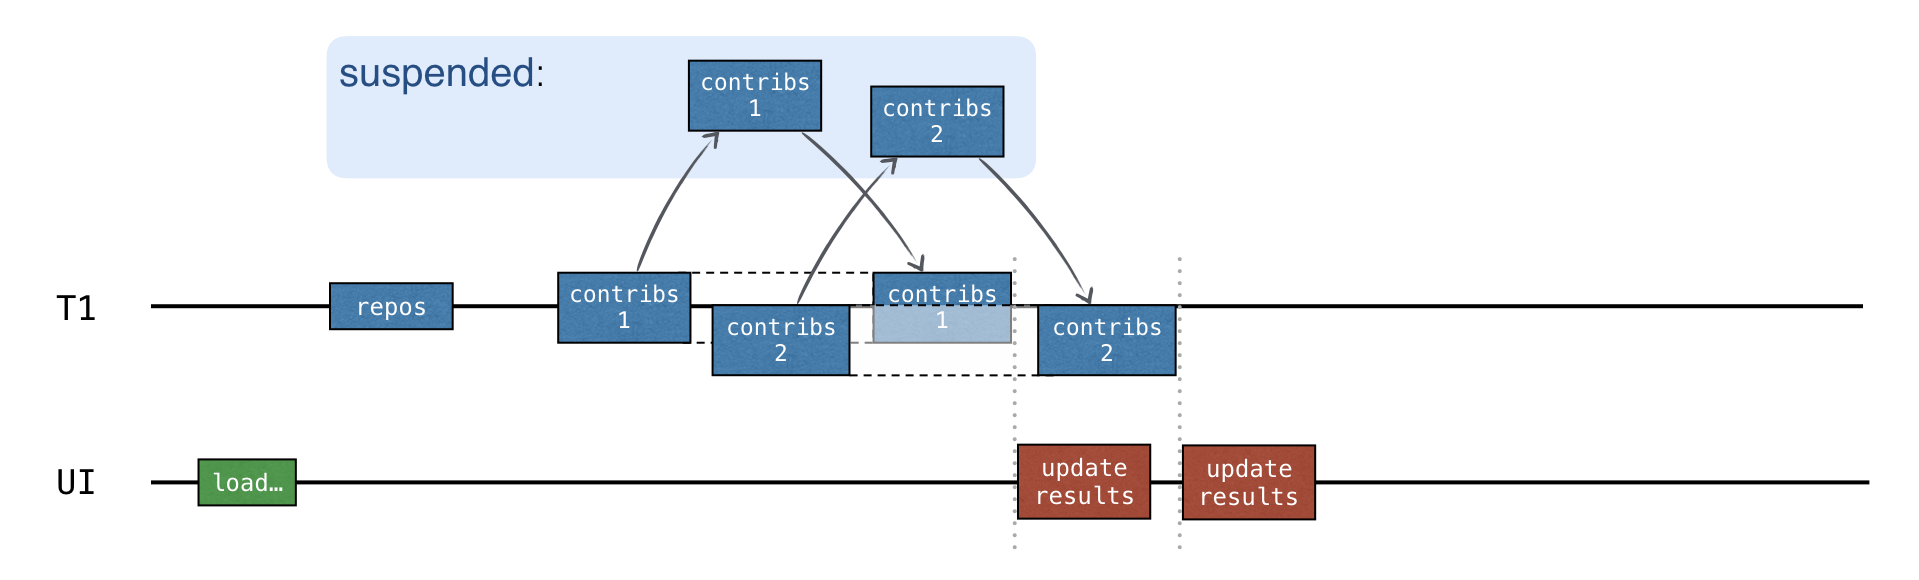
Для добавления конкурентности используйте каналы.
Каналы
Написание кода с общим изменяемым состоянием довольно сложно и подвержено ошибкам (как в решении, использующем обратные вызовы). Более простой способ — передавать информацию посредством связи, а не с помощью общего изменяемого состояния. Корутины могут обмениваться информацией через каналы.
Каналы — это примитивы связи, которые позволяют передавать данные между корутинами. Одна корутина может отправить некоторую информацию в канал, в то время как другая может получить эту информацию из него:
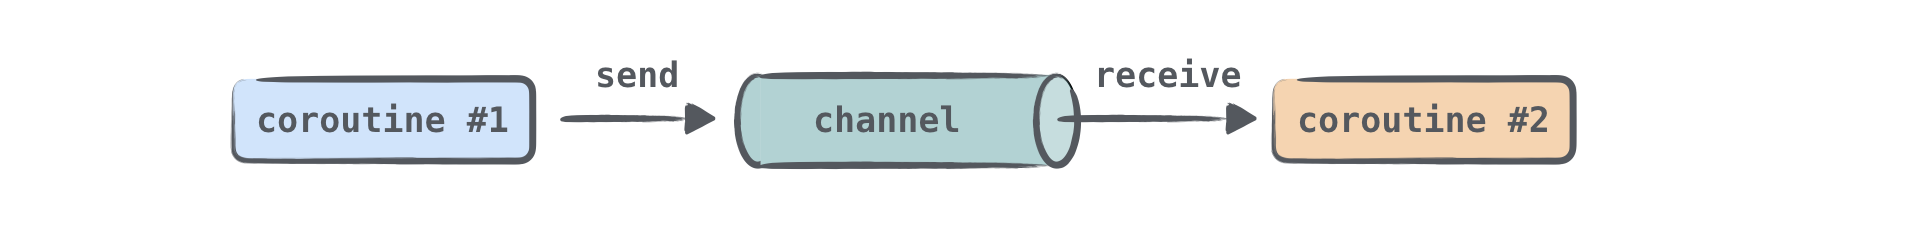
Корутина, которая отправляет (производит) информацию, часто называется производителем, а корутина, которая получает (потребляет) информацию, называется потребителем. Одна или несколько корутин могут отправлять информацию в один и тот же канал, и одна или несколько корутин могут получать данные из него:
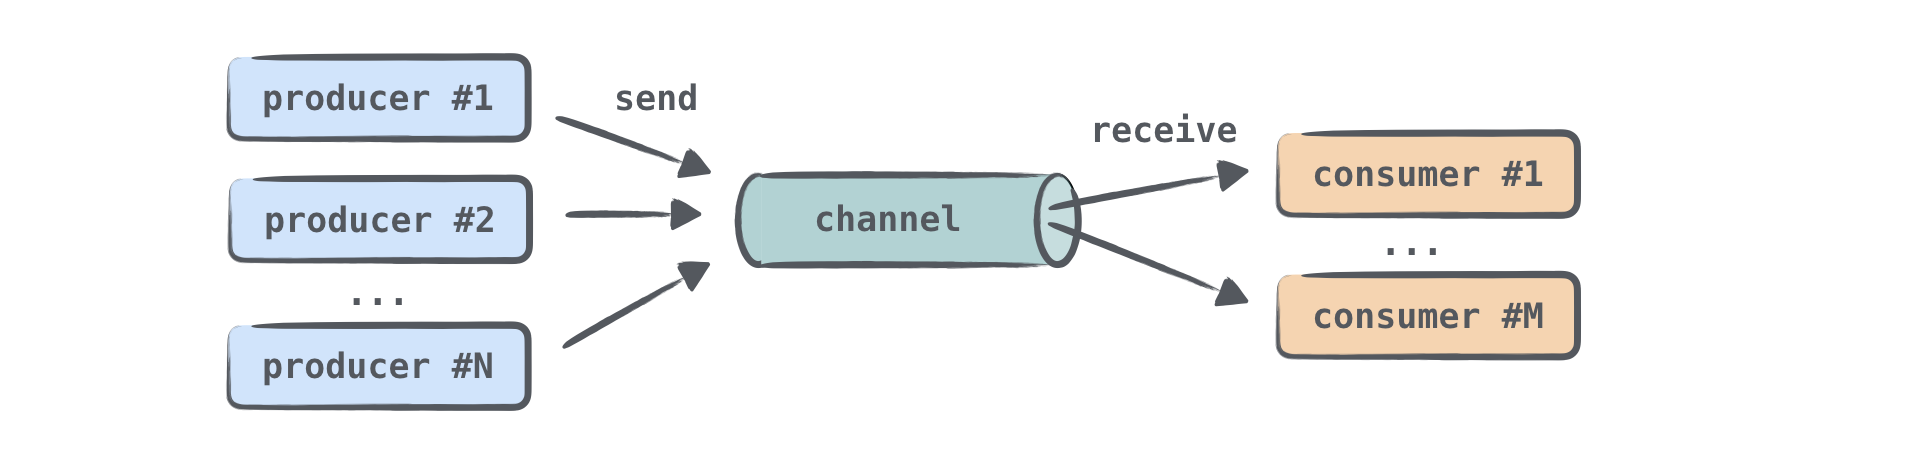
Когда множество корутин получают информацию из одного и того же канала, каждый элемент обрабатывается только один раз одной из корутин-потребителей. После обработки элемента он немедленно удаляется из канала.
Можно представить канал как похожий на коллекцию элементов, или, точнее, очередь, в которой элементы добавляются с одного конца и получаются с другого. Однако есть важное различие: в отличие от коллекций, даже в их синхронизированных версиях, канал может приостановить send() и receive() операции. Это происходит, когда канал пустой или полный. Канал может быть полным, если размер канала имеет верхнюю границу.
Channel представлен тремя различными интерфейсами: SendChannel, ReceiveChannel, и Channel, причём последний расширяет два первых. Обычно вы создаёте канал и передаёте его производителям в качестве SendChannel экземпляра, чтобы только они могли отправлять информацию в канал. Вы передаёте канал потребителям в качестве ReceiveChannel экземпляра, чтобы только они могли получать из него информацию. Оба send и receive метода объявлены как suspend.
interface SendChannel<in E> {
    suspend fun send(element: E)
    fun close(): Boolean
}

interface ReceiveChannel<out E> {
    suspend fun receive(): E
}

interface Channel<E> : SendChannel<E>, ReceiveChannel<E>
Производитель может закрыть канал, чтобы указать, что больше элементов не поступает.
В библиотеке определены несколько типов каналов. Они различаются тем, сколько элементов они могут хранить внутри и приостанавливается ли вызов send() или нет. Для всех типов каналов вызов receive() ведет себя аналогично: он получает элемент, если канал не пустой; в противном случае он приостанавливается.
- Неограниченный канал
-
Неограниченный канал — это аналог очереди: производители могут отправлять элементы в этот канал, и он будет неограниченно расти. Вызов
send()никогда не будет приостановлен. Если программа исчерпает память, произойдётOutOfMemoryException. Разница между неограниченным каналом и очередью заключается в том, что когда потребитель пытается получить из пустого канала, он приостанавливается до тех пор, пока не будут отправлены новые элементы.
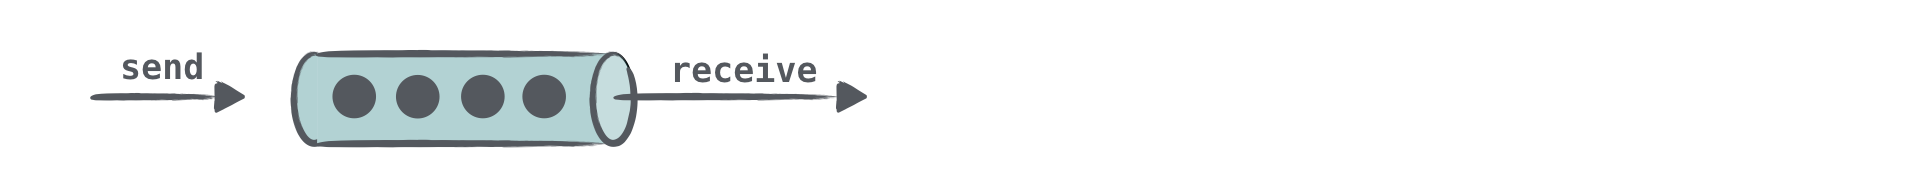
- Буферизованный канал
-
Размер буферизованного канала ограничен указанным числом. Производители могут отправлять элементы в этот канал до тех пор, пока не будет достигнуто ограничение по размеру. Все элементы хранятся внутри. Когда канал полон, следующий вызов `send` приостанавливается до тех пор, пока не станет доступно больше свободного места.
- Канал rendezvous
-
Канал «Rendezvous» — это канал без буфера, такой же, как буферизованный канал с размером ноль. Одна из функций (
send()илиreceive()) всегда приостанавливается до тех пор, пока не будет вызвана другая.Если вызвана функция
send(), и нет приостановленного вызоваreceiveготового обработать элемент, тоsend()приостанавливается. Аналогично, если вызвана функцияreceive, и канал пуст или, другими словами, нет приостановленного вызоваsend()готового отправить элемент, то вызовreceive()приостанавливается.Название «rendezvous» («встреча в согласованное время и месте») относится к тому факту, что
send()иreceive()должны «встретиться вовремя».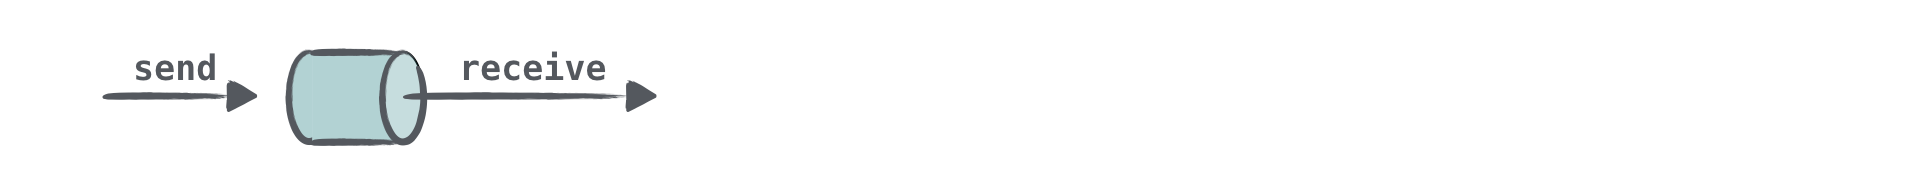
- Слияние каналов
-
Новый элемент, отправленный в канал слияния, перезапишет ранее отправленный элемент, поэтому получатель всегда получит только последний элемент. Вызов
send()никогда не приостанавливается.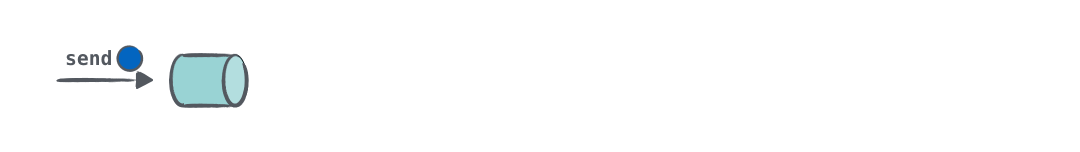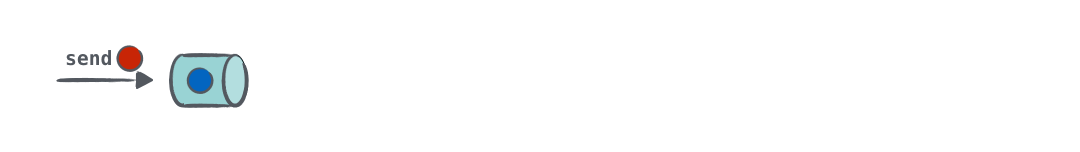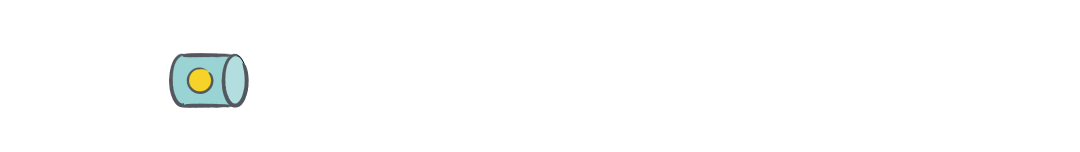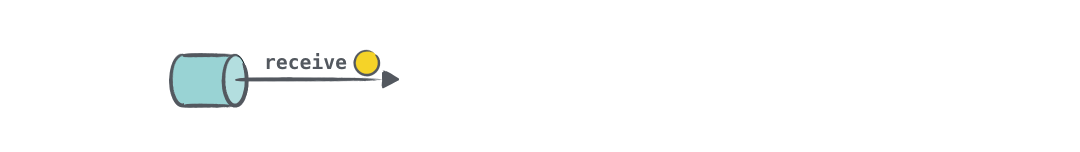
При создании канала укажите его тип или размер буфера (если вам нужен буферизованный канал):
val rendezvousChannel = Channel<String>()
val bufferedChannel = Channel<String>(10)
val conflatedChannel = Channel<String>(CONFLATED)
val unlimitedChannel = Channel<String>(UNLIMITED)
По умолчанию создаётся канал «Rendezvous».
В следующем задании вы создадите канал «Rendezvous», две корутины-производителя и одну корутину-потребителя:
import kotlinx.coroutines.channels.Channel
import kotlinx.coroutines.*

fun main() = runBlocking<Unit> {
    val channel = Channel<String>()
    launch {
        channel.send("A1")
        channel.send("A2")
        log("A done")
    }
    launch {
        channel.send("B1")
        log("B done")
    }
    launch {
        repeat(3) {
            val x = channel.receive()
            log(x)
        }
    }
}

fun log(message: Any?) {
    println("[${Thread.currentThread().name}] $message")
}
Задание 7
В src/tasks/Request7Channels.kt, реализуйте функцию loadContributorsChannels(), которая запрашивает всех участников GitHub одновременно и показывает промежуточную информацию о прогрессе.
Используйте предыдущие функции, loadContributorsConcurrent() из Request5Concurrent.kt и loadContributorsProgress() из Request6Progress.kt.
Подсказка к заданию 7
Разные корутины, которые одновременно получают списки участников для разных репозиториев, могут отправлять все полученные результаты в один и тот же канал:
val channel = Channel<List<User>>()
for (repo in repos) {
    launch {
        val users = TODO()
        // ...
        channel.send(users)
    }
}
Затем элементы из этого канала можно получать по одному и обрабатывать:
repeat(repos.size) {
    val users = channel.receive()
    // ...
}
Поскольку вызовы receive() последовательны, дополнительная синхронизация не требуется.
Решение задачи 7
Как и в функции loadContributorsProgress(), вы можете создать переменную allUsers для хранения промежуточных состояний списка «все участники». Каждый новый список, полученный из канала, добавляется в список всех пользователей. Результат агрегируется и обновляется с помощью обратного вызова updateResults.
suspend fun loadContributorsChannels(
    service: GitHubService,
    req: RequestData,
    updateResults: suspend (List<User>, completed: Boolean) -> Unit
) = coroutineScope {

    val repos = service
        .getOrgRepos(req.org)
        .also { logRepos(req, it) }
        .bodyList()

    val channel = Channel<List<User>>()
    for (repo in repos) {
        launch {
            val users = service.getRepoContributors(req.org, repo.name)
                .also { logUsers(repo, it) }
                .bodyList()
            channel.send(users)
        }
    }
    var allUsers = emptyList<User>()
    repeat(repos.size) {
        val users = channel.receive()
        allUsers = (allUsers + users).aggregate()
        updateResults(allUsers, it == repos.lastIndex)
    }
}
Результаты для разных репозиториев добавляются в канал, как только они готовы. Сначала, когда все запросы отправлены, и данные не получены, вызов
receive()приостанавливается. В этом случае вся корутина «загрузка участников» приостанавливается.Затем, когда список пользователей отправляется в канал, корутина «загрузка участников» возобновляется, вызов
receive()возвращает этот список, и результаты сразу обновляются.
Теперь вы можете запустить программу и выбрать опцию КАНАЛЫ для загрузки участников и просмотра результата.
Хотя ни корутины, ни каналы полностью не устраняют сложности, возникающие при одновременной работе, они упрощают жизнь, когда нужно понять, что происходит.
Тестирование сопроцедур
Теперь давайте протестируем все решения, чтобы убедиться, что решение с конкурентными сопроцедурами быстрее, чем решение с функциями suspend, и что решение с каналами быстрее, чем простое решение "прогресса".
В следующем задании вы сравните общее время выполнения решений. Вы будете имитировать сервис GitHub и заставлять этот сервис возвращать результаты после заданных таймаутов:
repos request - returns an answer within 1000 ms delay
repo-1 - 1000 ms delay
repo-2 - 1200 ms delay
repo-3 - 800 ms delay
Последовательное решение с функциями suspend должно занимать около 4000 мс (4000 = 1000 + (1000 + 1200 + 800)). Конкурентное решение должно занимать около 2200 мс (2200 = 1000 + max(1000, 1200, 800)).
Для решений, отображающих прогресс, вы также можете проверить промежуточные результаты со временем.
Соответствующие тестовые данные определены в test/contributors/testData.kt, а файлы Request4SuspendKtTest, Request7ChannelsKtTest и так далее содержат простые тесты, использующие вызовы имитируемого сервиса.
Однако здесь есть две проблемы:
Эти тесты занимают слишком много времени. Каждый тест занимает около 2-4 секунд, и каждый раз вам нужно ждать результатов. Это не очень эффективно.
Вы не можете полагаться на точное время выполнения решения, потому что оно все равно занимает дополнительное время для подготовки и запуска кода. Вы могли бы добавить константу, но тогда время будет отличаться от машины к машине. Задержки имитируемого сервиса должны быть больше этой константы, чтобы вы могли увидеть разницу. Если константа составляет 0,5 секунды, то задержки в 0,1 секунды будут недостаточными.
Лучший способ — использовать специальные фреймворки для тестирования времени, выполняя тот же код несколько раз (что увеличивает общее время еще больше), но это сложно изучить и настроить.
Чтобы решить эти проблемы и убедиться, что решения с предоставленными задержками в тестах ведут себя так, как ожидается, то есть одно быстрее другого, используйте виртуальное время с помощью специального диспетчера тестов. Этот диспетчер отслеживает виртуальное время, прошедшее с начала, и выполняет все немедленно в реальном времени. Когда вы запускаете сопроцедуры на этом диспетчере, delay вернется немедленно и продвинет виртуальное время.
Тесты, использующие этот механизм, работают быстро, но вы по-прежнему можете проверить, что происходит в различные моменты виртуального времени. Общее время выполнения резко уменьшается:
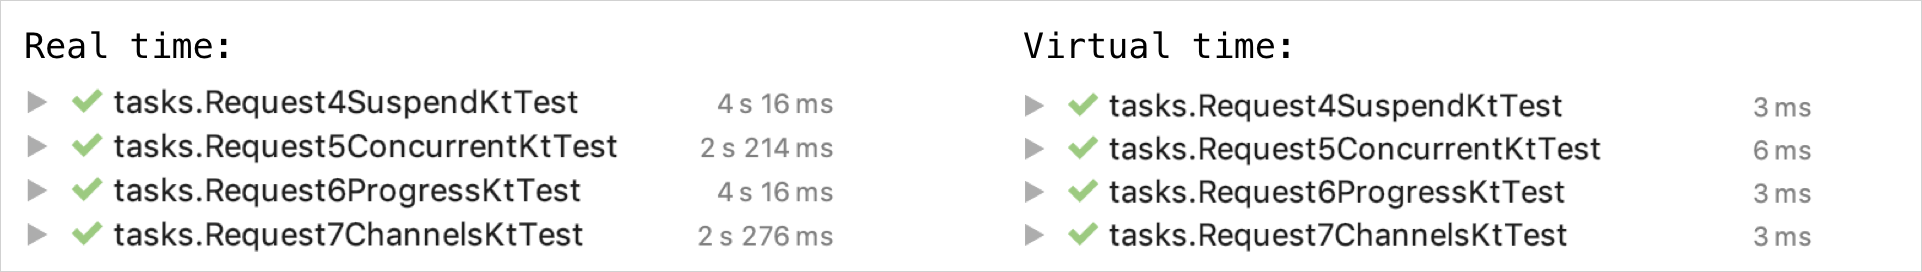
Чтобы использовать виртуальное время, замените вызов runBlocking на runTest. runTest принимает лямбда-расширение для TestScope в качестве аргумента. Когда вы вызываете delay в функции suspend внутри этого специального контекста, delay увеличит виртуальное время вместо задержки в реальном времени:
@Test
fun testDelayInSuspend() = runTest {
    val realStartTime = System.currentTimeMillis()
    val virtualStartTime = currentTime

    foo()
    println("${System.currentTimeMillis() - realStartTime} ms") // ~ 6 ms
    println("${currentTime - virtualStartTime} ms")             // 1000 ms
}

suspend fun foo() {
    delay(1000)    // auto-advances without delay
    println("foo") // executes eagerly when foo() is called
}
Вы можете проверить текущее виртуальное время, используя свойство currentTime объекта TestScope.
Фактическое время выполнения в этом примере составляет несколько миллисекунд, в то время как виртуальное время равно аргументу задержки, который составляет 1000 миллисекунд.
Чтобы получить полный эффект "виртуального" delay в дочерних сопроцедурах, запустите все дочерние сопроцедуры с TestDispatcher. В противном случае это не сработает. Этот диспетчер автоматически наследуется от других TestScope, если вы не укажете другой диспетчер:
@Test
fun testDelayInLaunch() = runTest {
    val realStartTime = System.currentTimeMillis()
    val virtualStartTime = currentTime

    bar()

    println("${System.currentTimeMillis() - realStartTime} ms") // ~ 11 ms
    println("${currentTime - virtualStartTime} ms")             // 1000 ms
}

suspend fun bar() = coroutineScope {
    launch {
        delay(1000)    // auto-advances without delay
        println("bar") // executes eagerly when bar() is called
    }
}
Если launch вызывается с контекстом Dispatchers.Default в приведённом выше примере, тест завершится неудачей. Вы получите исключение, сообщаящее, что задача ещё не завершена.
Вы можете протестировать функцию loadContributorsConcurrent() таким образом только в том случае, если она запускает дочерние сопроцедуры с унаследованным контекстом, не изменяя его с помощью диспетчера Dispatchers.Default.
Вы можете указать элементы контекста, такие как диспетчер, при вызове функции, а не при её определении, что обеспечивает большую гибкость и упрощает тестирование.
По умолчанию компилятор показывает предупреждения, если вы используете экспериментальный API тестирования. Чтобы подавить эти предупреждения, аннотируйте функцию теста или весь класс, содержащий тесты, с @OptIn(ExperimentalCoroutinesApi::class). Добавьте аргумент компилятора, указывающий компилятору, что вы используете экспериментальный API:
compileTestKotlin {
    kotlinOptions {
        freeCompilerArgs += "-Xuse-experimental=kotlin.Experimental"
    }
}
В проекте, соответствующем этому руководству, аргумент компилятора уже добавлен в скрипт Gradle.
Задание 8
Переработайте следующие тесты в tests/tasks/ для использования виртуального времени вместо реального времени:
Request4SuspendKtTest.kt
Request5ConcurrentKtTest.kt
Request6ProgressKtTest.kt
Request7ChannelsKtTest.kt
Сравните общее время выполнения до и после применения вашей переработки.
Подсказка для задания 8
-
Замените вызов
runBlockingнаrunTest, аSystem.currentTimeMillis()наcurrentTime:@Test fun test() = runTest { val startTime = currentTime // action val totalTime = currentTime - startTime // testing result } Разблокируйте утверждения, которые проверяют точное виртуальное время.
Не забудьте добавить
@UseExperimental(ExperimentalCoroutinesApi::class).
Решение для задания 8
Вот решения для конкурентных и канальных случаев:
fun testConcurrent() = runTest {
    val startTime = currentTime
    val result = loadContributorsConcurrent(MockGithubService, testRequestData)
    Assert.assertEquals("Wrong result for 'loadContributorsConcurrent'", expectedConcurrentResults.users, result)
    val totalTime = currentTime - startTime

    Assert.assertEquals(
        "The calls run concurrently, so the total virtual time should be 2200 ms: " +
                "1000 for repos request plus max(1000, 1200, 800) = 1200 for concurrent contributors requests)",
        expectedConcurrentResults.timeFromStart, totalTime
    )
}
Сначала проверьте, что результаты доступны ровно в ожидаемое виртуальное время, а затем проверьте сами результаты:
fun testChannels() = runTest {
    val startTime = currentTime
    var index = 0
    loadContributorsChannels(MockGithubService, testRequestData) { users, _ ->
        val expected = concurrentProgressResults[index++]
        val time = currentTime - startTime
        Assert.assertEquals(
            "Expected intermediate results after ${expected.timeFromStart} ms:",
            expected.timeFromStart, time
        )
        Assert.assertEquals("Wrong intermediate results after $time:", expected.users, users)
    }
}
Первый промежуточный результат для последней версии с каналами становится доступным раньше, чем версия с прогрессом, и вы можете увидеть разницу в тестах, использующих виртуальное время.
Что дальше
Посмотрите семинар Асинхронное программирование с Kotlin на KotlinConf.
Узнайте больше о работе с виртуальным временем и экспериментальным пакетом тестирования.
© 2010–2023 JetBrains s.r.o. and Kotlin Programming Language contributors
Licensed under the Apache License, Version 2.0.
https://kotlinlang.org/docs/coroutines-and-channels.html


