Kotlin для научных исследований данных
От создания конвейеров данных до развертывания моделей машинного обучения в производстве, Kotlin может быть отличным выбором для работы с данными:
Kotlin лаконичен, читаем и легко изучаем.
Статическая типизация и безопасность при работе с нулевыми значениями помогают создавать надёжный, поддерживаемый код, который легко отлаживать.
Как язык JVM, Kotlin обеспечивает высокую производительность и возможность использования целого экосистемы проверенных и надёжных библиотек Java.
Интерактивные редакторы
Записные книжки, такие как Jupyter Notebook, Datalore и Apache Zeppelin, предоставляют удобные инструменты для визуализации данных и исследовательской работы. Kotlin интегрируется с этими инструментами, помогая вам исследовать данные, делиться результатами с коллегами или развивать навыки в области научных исследований данных и машинного обучения.
Записные книжки Kotlin
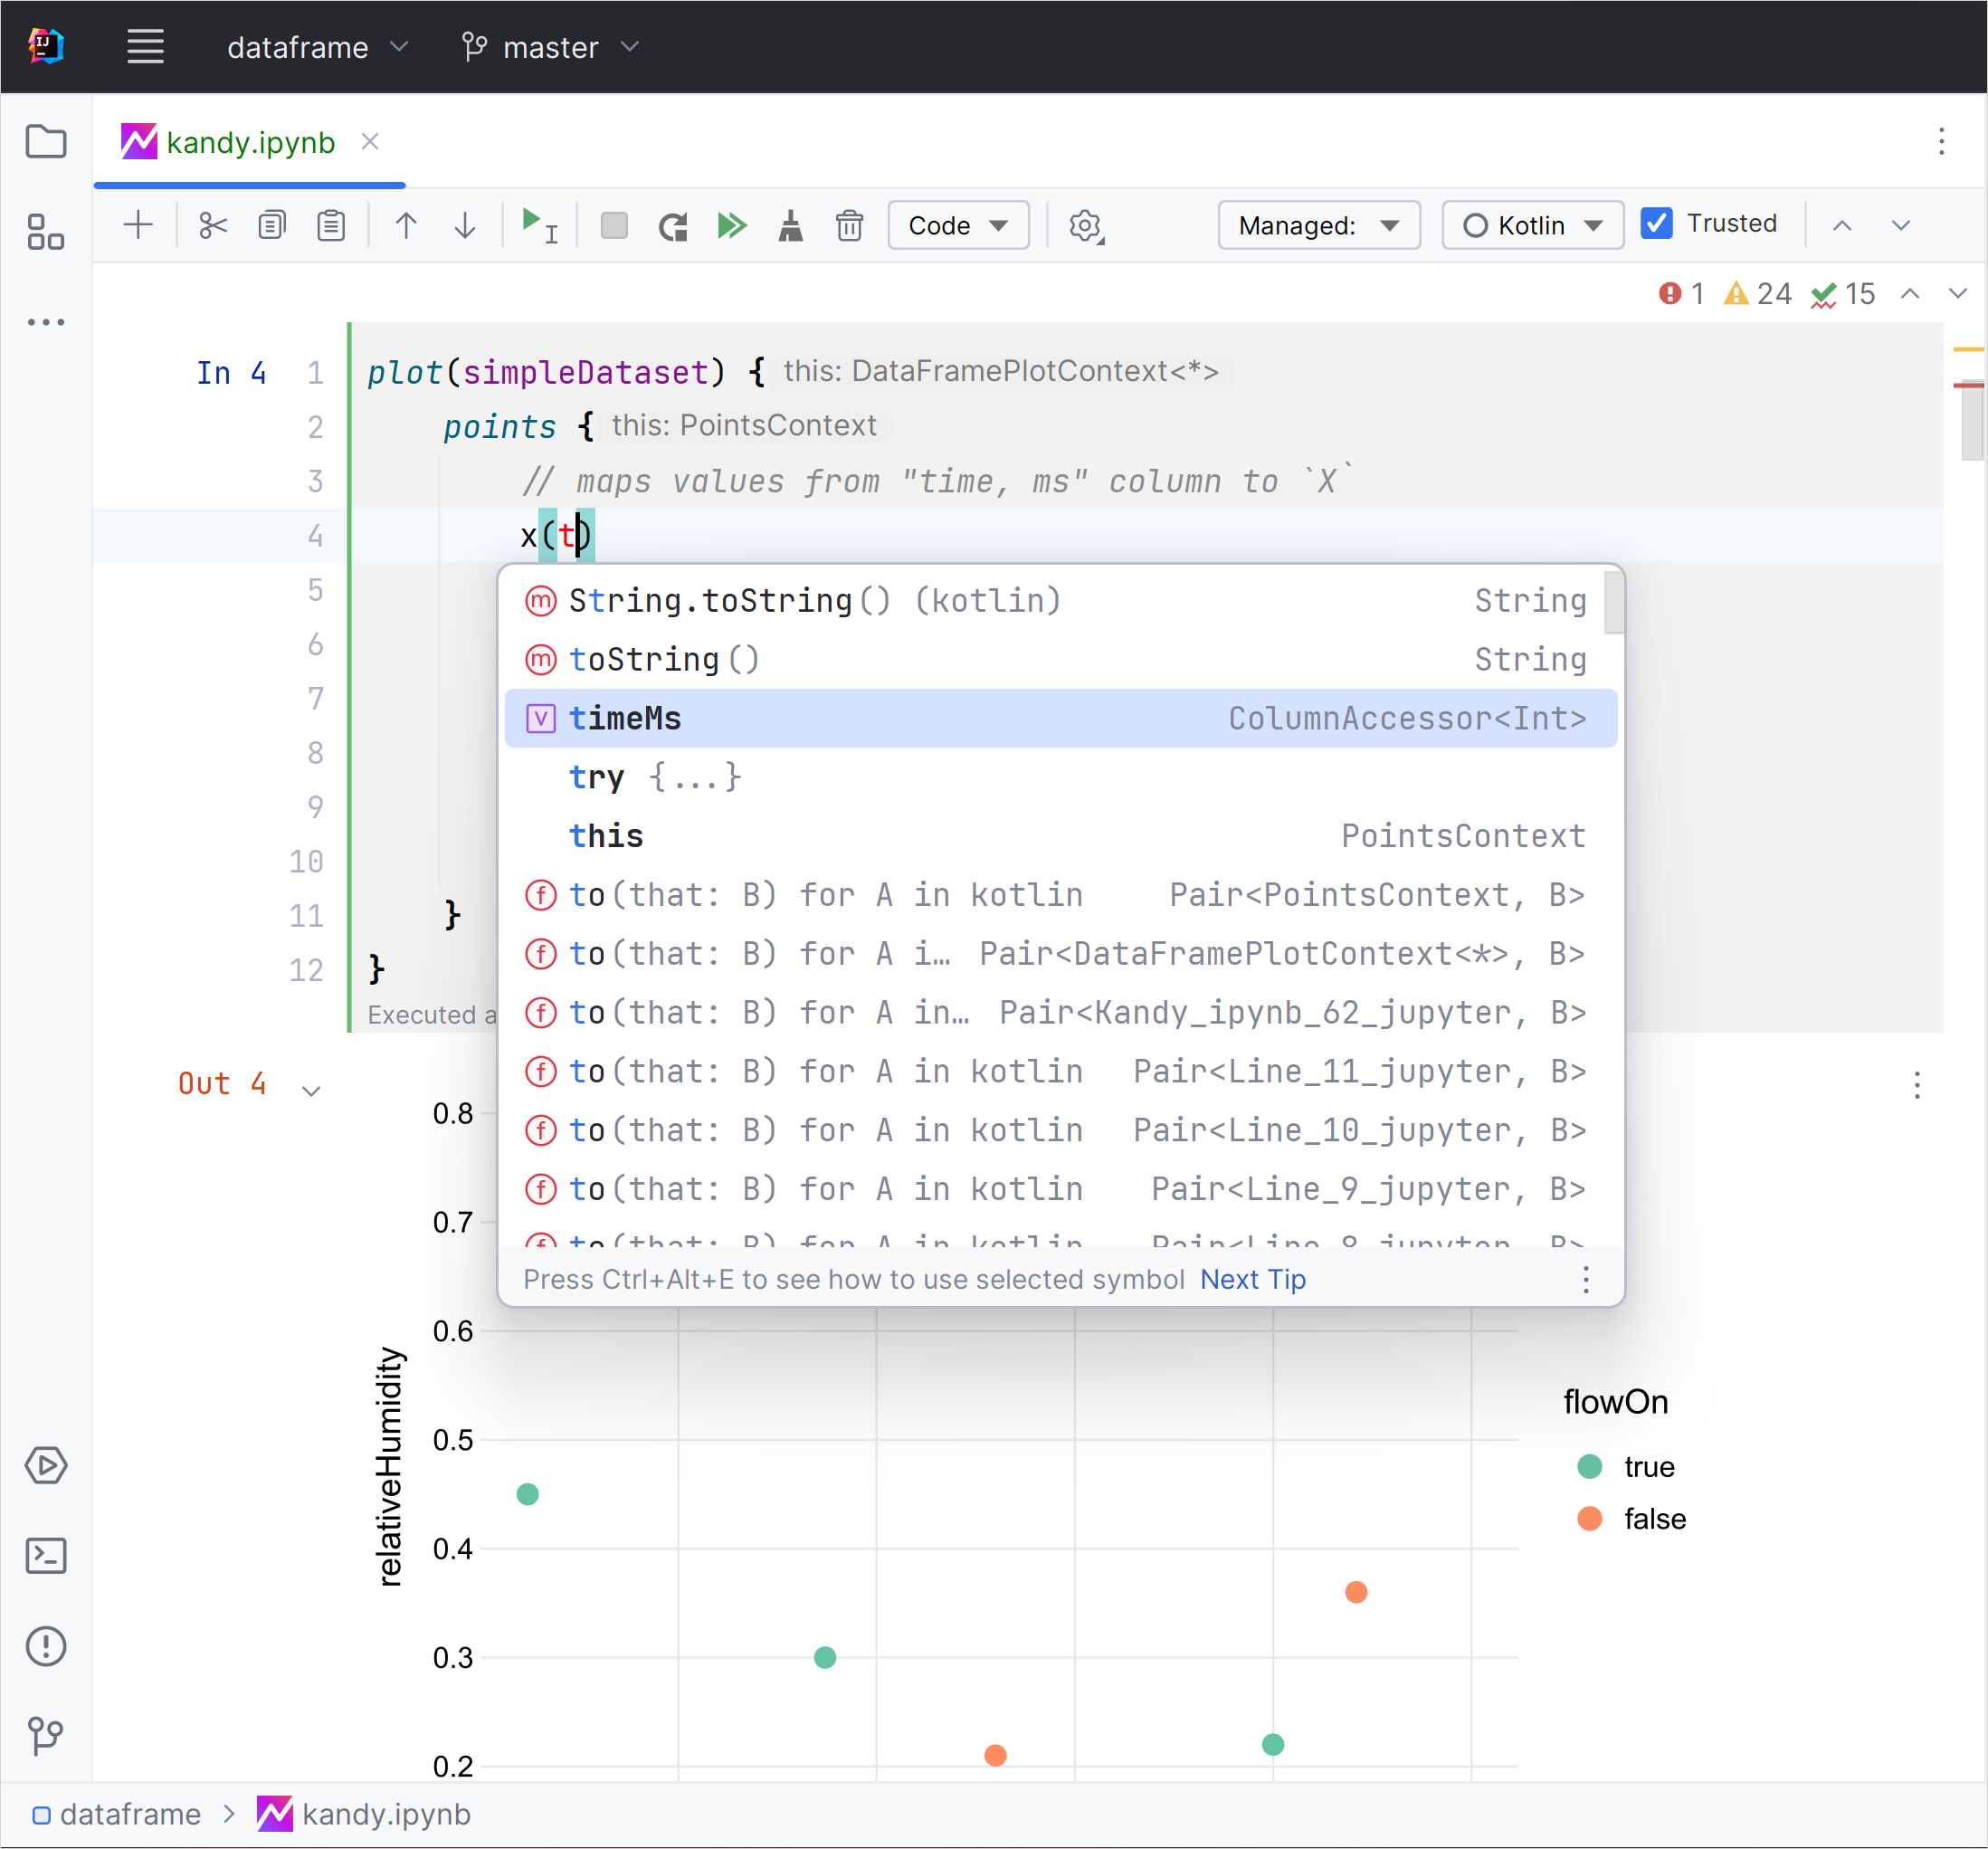
Записная книжка Kotlin — это плагин для IntelliJ IDEA, который позволяет создавать записные книжки на Kotlin. Он использует ядро Kotlin для выполнения ячеек и использует мощную поддержку Kotlin IDE для предоставления мгновенных подсказок по коду. Сейчас это предпочтительный способ работы с записными книжками Kotlin. Обязательно ознакомьтесь с нашей статьёй в блоге об этом.
Ядро Jupyter для Kotlin
Jupyter Notebook — это открытая веб-приложение, которое позволяет создавать и делиться документами (также известными как «записные книжки»), содержащими код, визуализации и текст Markdown. Kotlin-jupyter — это открытый проект, который добавляет поддержку Kotlin в Jupyter Notebook.

Ознакомьтесь с репозиторием GitHub ядра Kotlin для инструкций по установке, документации и примерах.
Записные книжки Kotlin в Datalore
В Datalore вы можете использовать Kotlin в браузере прямо из коробки, без необходимости установки. Вы также можете сотрудничать над записными книжками Kotlin в реальном времени, получать интеллектуальную помощь при написании кода и делиться результатами в виде интерактивных или статических отчётов. Ознакомьтесь с примерным отчётом.

Зарегистрируйтесь и используйте Kotlin с бесплатной учётной записью Datalore Community.
Интерпретатор Zeppelin для Kotlin
Apache Zeppelin — это популярное веб-решение для интерактивного анализа данных. Оно обеспечивает отличную поддержку системы кластеризации Apache Spark, что особенно полезно для инженерии данных. Начиная с версии 0.9.0, Apache Zeppelin поставляется с интегрированным интерпретатором Kotlin.

Библиотеки
Экосистема библиотек для задач, связанных с данными, созданная сообществом Kotlin, быстро расширяется. Вот некоторые библиотеки, которые могут быть вам полезны:
Библиотеки Kotlin
Multik: многомерные массивы в Kotlin. Библиотека предоставляет интуитивно понятный, безопасный в отношении типов и размерностей API для математических операций над многомерными массивами. Multik предлагает взаимозаменяемые JVM и native вычислительные движки, а также их комбинацию для оптимальной производительности.
KotlinDL — это API глубокого обучения высокого уровня, написанный на Kotlin и вдохновленный Keras. Он предоставляет простые API для обучения моделей глубокого обучения с нуля, импорта существующих моделей Keras для инференса и использования трансферного обучения для настройки существующих предварительно обученных моделей под ваши задачи.
Kotlin DataFrame — это библиотека для обработки структурированных данных. Она стремится примирить статическую типизацию Kotlin с динамической природой данных, используя как весь потенциал языка Kotlin, так и возможности, предоставляемые неявным выполнением кода в Jupyter notebooks и REPL.
Kotlin для Apache Spark добавляет недостающий уровень совместимости между Kotlin и Apache Spark. Он позволяет разработчикам Kotlin использовать такие привычные языковые функции, как классы данных и лямбда-выражения, в качестве простых выражений в фигурных скобках или ссылок на методы.
kotlin-statistics — это библиотека, предоставляющая расширяющие функции для исследовательской и производственной статистики. Она поддерживает базовые числовые функции для списков/последовательностей/массивов (от
sumдоskewness), операторы среза (такие какcountBy,simpleRegressionBy), операции по группировке, дискретную выборку PDF, классификатор наивного Байеса, кластеризацию, линейную регрессию и многое другое.kmath — это экспериментальная библиотека, изначально вдохновлённая NumPy, но эволюционировавшая в более гибкие абстракции. Она реализует математические операции, объединённые в алгебраические структуры над типами Kotlin, определяет API для линейных структур, выражений, гистограмм, потоковых операций, предоставляет взаимозаменяемые оболочки над существующими Java и Kotlin-библиотеками, включая ND4J, Commons Math, Multik и другие.
krangl — это библиотека, вдохновлённая R's dplyr и Python's pandas. Эта библиотека предоставляет функциональность для манипулирования данными с помощью функционального API; она также включает функции для фильтрации, преобразования, агрегирования и изменения формы табличных данных.
lets-plot — это библиотека для построения графиков статистических данных, написанная на Kotlin. Lets-Plot многоплатформенная и может использоваться не только с JVM, но и с JS и Python.
kravis — ещё одна библиотека для визуализации табличных данных, вдохновлённая R's ggplot.
londogard-nlp-toolkit — библиотека, предоставляющая инструменты при работе с обработкой естественного языка, такие как вложения слов/суффиксов/предложений, частоты слов, стоп-слова, стемминг и многое другое.
Библиотеки Java
Поскольку Kotlin обеспечивает первоклассную интеграцию с Java, вы также можете использовать Java-библиотеки для науки о данных в вашем Kotlin-коде. Вот несколько примеров таких библиотек:
DeepLearning4J — библиотека глубокого обучения для Java
ND4J — эффективная библиотека для работы с матрицами для JVM
Dex — инструмент визуализации данных на основе Java
-
Smile — комплексная система машинного обучения, обработки естественного языка, линейной алгебры, графов, интерполяции и визуализации. Помимо Java API, Smile также предоставляет функциональный Kotlin API, а также API для Scala и Clojure.
Smile-NLP-kt — Kotlin-переработка Scala-имплиситов для части обработки естественного языка Smile в формате расширяющих функций и интерфейсов.
Apache Commons Math — общая математическая, статистическая и библиотека машинного обучения для Java
NM Dev — математическая Java-библиотека, охватывающая всю классическую математику.
OptaPlanner — утилита-решатель для оптимизационных задач планирования.
Charts — научная JavaFX-библиотека для построения графиков, находится в разработке.
Apache OpenNLP — инструмент машинного обучения для обработки текстов естественного языка.
CoreNLP — набор инструментов для обработки естественного языка.
Apache Mahout — распределённая платформа для регрессии, кластеризации и рекомендаций.
Weka — набор алгоритмов машинного обучения для задач по анализу данных.
Tablesaw — Java-dataframe. Включает библиотеку визуализации на основе Plot.ly
Если этот список не удовлетворяет вашим потребностям, вы можете найти больше вариантов в репозитории GitHub Kotlin Machine Learning Demos с примерами от Thomas Nield.
© 2010–2023 JetBrains s.r.o. and Kotlin Programming Language contributors
Licensed under the Apache License, Version 2.0.
https://kotlinlang.org/docs/data-science-overview.html


