Корутины и каналы − руководство
В этом руководстве вы узнаете, как использовать корутины в IntelliJ IDEA для выполнения сетевых запросов без блокировки потока или использования обратных вызовов.
Вы узнаете:
Зачем и как использовать приостанавливаемые функции для выполнения сетевых запросов.
Как отправлять запросы параллельно с помощью корутин.
Как обмениваться информацией между разными корутинами с помощью каналов.
Для сетевых запросов вам понадобится библиотека Retrofit, но подход, описанный в этом руководстве, аналогичным образом работает и с другими библиотеками, поддерживающими корутины.
Перед началом
Скачайте и установите последнюю версию IntelliJ IDEA.
-
Клонируйте шаблон проекта, выбрав Получить из VCS на экране приветствия или пункт Файл | Создать | Проект из системы контроля версий.
Также можно клонировать проект из командной строки:
git clone https://github.com/kotlin-hands-on/intro-coroutines
Создайте токен разработчика GitHub
В проекте вы будете использовать API GitHub. Для доступа укажите имя учетной записи GitHub и пароль или токен. Если у вас включена двухфакторная аутентификация, достаточно будет токена.
Создайте новый токен GitHub, чтобы использовать API GitHub с помощью своей учетной записи:
-
Укажите название токена, например
coroutines-tutorial: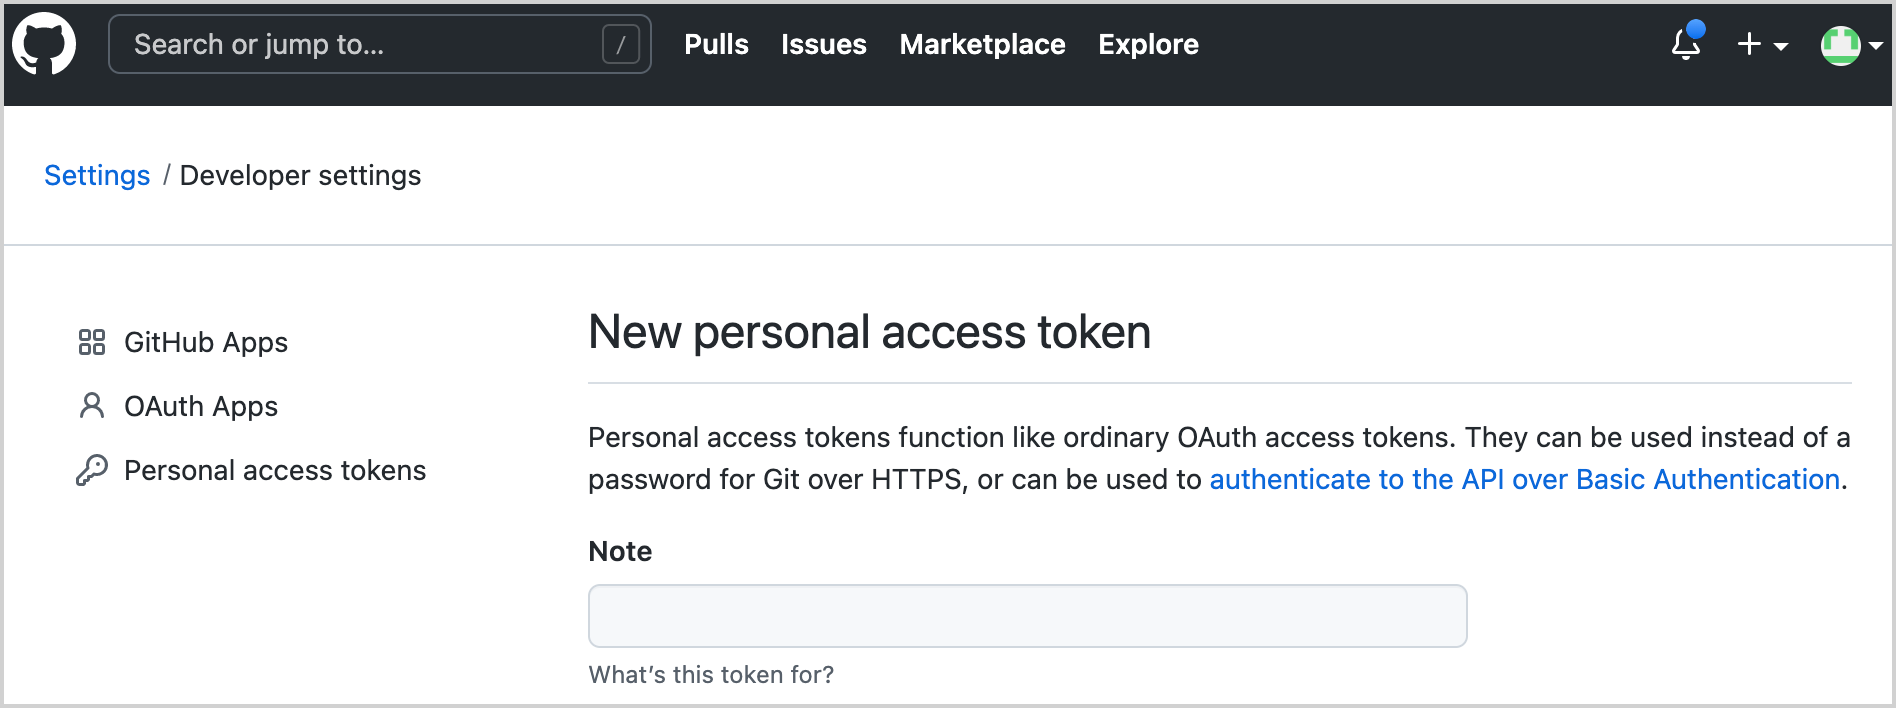
Не выбирайте никакие разрешения. Нажмите Создать токен внизу страницы.
Скопируйте созданный токен.
Запустите код
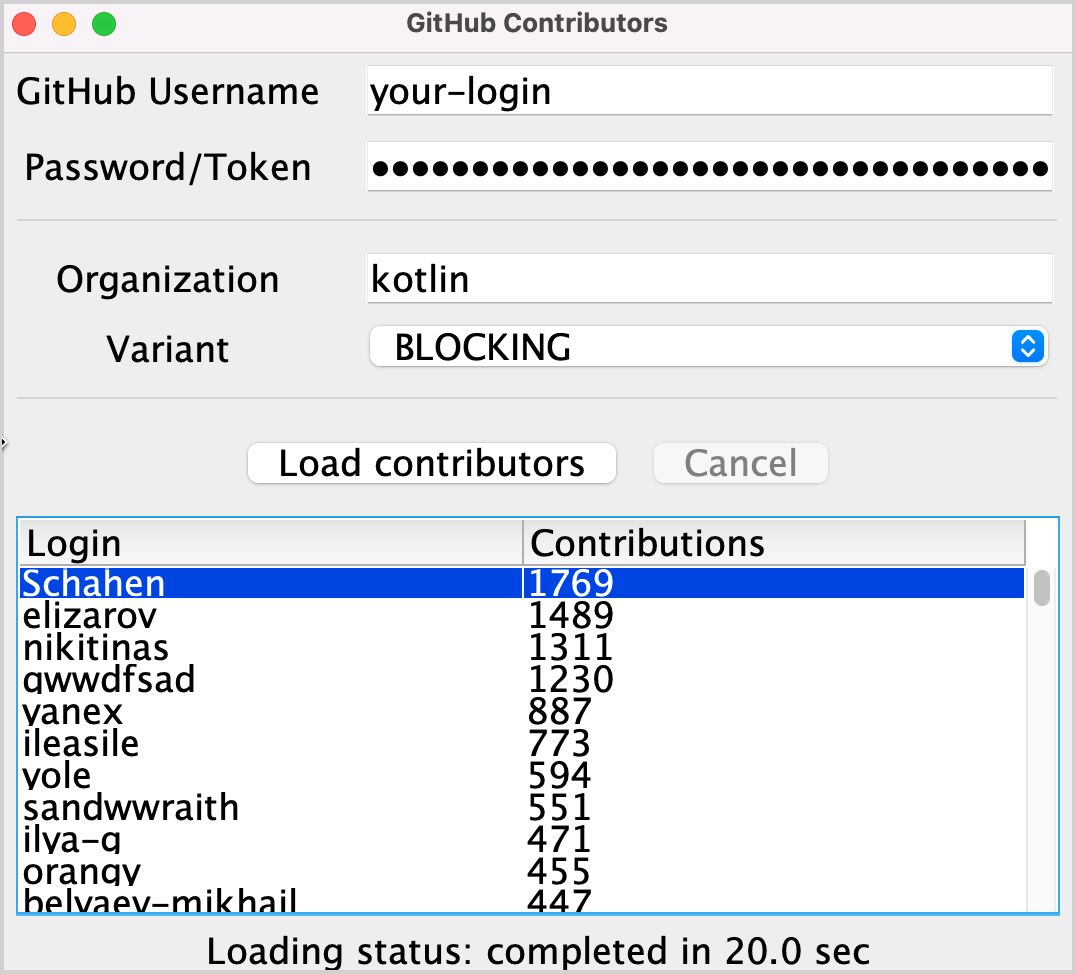
Программа загружает участников всех репозиториев указанной организации (по умолчанию — «kotlin»). Позже вы добавите логику сортировки пользователей по количеству их вкладов.
-
Откройте файл
src/contributors/main.ktи запустите функциюmain(). Появится следующее окно:
Если шрифт слишком мелкий, измените его размер, изменив значение
setDefaultFontSize(18f)в функцииmain(). Укажите имя пользователя GitHub и токен (или пароль) в соответствующих полях.
Убедитесь, что в раскрывающемся списке Вариант выбран пункт БЛОКИРОВКА.
Нажмите Загрузить участников. Интерфейс на некоторое время зависнет, а затем отобразит список участников.
Откройте вывод программы и убедитесь, что данные загружены. Список участников записывается в журнал после каждого успешного запроса.
Эту логику можно реализовать разными способами: с помощью блокирующих запросов или обратных вызовов. Вы сравните эти решения с вариантом, в котором используются корутины, и узнаете, как с помощью каналов можно обмениваться информацией между разными корутинами.
Блокирующие запросы
Для выполнения HTTP-запросов к GitHub вы будете использовать библиотеку Retrofit. Она позволяет запрашивать список репозиториев указанной организации и список участников каждого репозитория:
interface GitHubService {
    @GET("orgs/{org}/repos?per_page=100")
    fun getOrgReposCall(
        @Path("org") org: String
    ): Call<List<Repo>>

    @GET("repos/{owner}/{repo}/contributors?per_page=100")
    fun getRepoContributorsCall(
        @Path("owner") owner: String,
        @Path("repo") repo: String
    ): Call<List<User>>
}
Этот API используется функцией loadContributorsBlocking() для получения списка участников указанной организации.
-
Откройте
src/tasks/Request1Blocking.kt, чтобы посмотреть реализацию:fun loadContributorsBlocking( service: GitHubService, req: RequestData ): List<User> { val repos = service .getOrgReposCall(req.org) // #1 .execute() // #2 .also { logRepos(req, it) } // #3 .body() ?: emptyList() // #4 return repos.flatMap { repo -> service .getRepoContributorsCall(req.org, repo.name) // #1 .execute() // #2 .also { logUsers(repo, it) } // #3 .bodyList() // #4 }.aggregate() }Сначала вы получаете список репозиториев указанной организации и сохраняете его в списке
repos. Затем для каждого репозитория запрашивается список участников, после чего все списки объединяются в один итоговый список участников.getOrgReposCall()иgetRepoContributorsCall()возвращают экземпляр класса*Call(#1). На этом этапе запрос еще не отправляется.Затем вызывается
*Call.execute()для выполнения запроса (#2).execute()— это синхронный вызов, блокирующий исходный поток.После получения ответа результат записывается в журнал вызовом соответствующих функций
logRepos()иlogUsers()(#3). Если HTTP-ответ содержит ошибку, здесь будет записано сообщение об ошибке.Наконец, получите тело ответа, содержащее нужные данные. В этом руководстве в случае ошибки будет использоваться пустой список, а соответствующая ошибка будет записана в журнал (
#4).
-
Чтобы не повторять
.body() ?: emptyList(), объявлена функция-расширениеbodyList():fun <T> Response<List<T>>.bodyList(): List<T> { return body() ?: emptyList() } -
Запустите программу еще раз и посмотрите на системный вывод в IntelliJ IDEA. Он должен выглядеть примерно так:
1770 [AWT-EventQueue-0] INFO  Contributors - kotlin: loaded 40 repos
2025 [AWT-EventQueue-0] INFO  Contributors - kotlin-examples: loaded 23 contributors
2229 [AWT-EventQueue-0] INFO  Contributors - kotlin-koans: loaded 45 contributors
...
Первый элемент каждой строки — количество миллисекунд, прошедших с начала работы программы, затем в квадратных скобках указано имя потока. Так можно увидеть, из какого потока вызывается запрос на загрузку.
Последний элемент каждой строки — фактическое сообщение: сколько репозиториев или участников было загружено.
Этот вывод журнала показывает, что все результаты были записаны из главного потока. При запуске кода с вариантом БЛОКИРОВКА окно зависает и не реагирует на ввод до завершения загрузки. Все запросы выполняются в том же потоке, из которого вызывается
loadContributorsBlocking(), то есть в основном потоке пользовательского интерфейса (в Swing это поток обработки событий AWT). Этот главный поток блокируется, поэтому интерфейс зависает:
После загрузки списка участников результат обновляется.
-
В
src/contributors/Contributors.ktнайдите функциюloadContributors(), отвечающую за выбор способа загрузки участников, и посмотрите, как вызываетсяloadContributorsBlocking():when (getSelectedVariant()) { BLOCKING -> { // Blocking UI thread val users = loadContributorsBlocking(service, req) updateResults(users, startTime) } }Вызов
updateResults()следует непосредственно за вызовомloadContributorsBlocking().updateResults()обновляет интерфейс, поэтому его всегда нужно вызывать из потока пользовательского интерфейса.Поскольку
loadContributorsBlocking()тоже вызывается из потока пользовательского интерфейса, этот поток блокируется, и интерфейс зависает.
Задание 1
Первое задание поможет вам познакомиться с предметной областью. Сейчас имя каждого участника повторяется несколько раз — по одному разу для каждого проекта, в котором он участвовал. Реализуйте функцию aggregate(), объединяющую пользователей так, чтобы каждый участник добавлялся только один раз. Свойство User.contributions должно содержать общее количество вкладов пользователя во все проекты. Полученный список должен быть отсортирован по убыванию количества вкладов.
Откройте src/tasks/Aggregation.kt и реализуйте функцию List<User>.aggregate(). Пользователи должны быть отсортированы по общему количеству их вкладов.
В соответствующем тестовом файле test/tasks/AggregationKtTest.kt приведен пример ожидаемого результата.
После выполнения задания итоговый список для организации «kotlin» должен выглядеть примерно так:
Решение задания 1
Чтобы сгруппировать пользователей по логину, используйте
groupBy(). Эта функция возвращает карту, в которой каждому логину соответствуют все его вхождения в разных репозиториях.Для каждой записи карты подсчитайте общее количество вкладов пользователя и создайте новый экземпляр класса
Userс указанным именем и общим количеством вкладов.-
Отсортируйте полученный список по убыванию:
fun List<User>.aggregate(): List<User> =
    groupBy { it.login }
        .map { (login, group) -> User(login, group.sumOf { it.contributions }) }
        .sortedByDescending { it.contributions }
Вместо groupBy() можно использовать функцию groupingBy().
Обратные вызовы
Предыдущее решение работает, но блокирует поток и поэтому приводит к зависанию интерфейса. Традиционный способ избежать этого — использовать обратные вызовы.
Вместо вызова кода, который должен выполниться сразу после завершения операции, можно вынести его в отдельный обратный вызов, часто представляющий собой лямбда-выражение, и передать эту лямбду вызывающему коду, чтобы тот вызвал ее позже.
Чтобы интерфейс оставался отзывчивым, можно либо перенести все вычисления в отдельный поток, либо перейти на API Retrofit, использующий обратные вызовы вместо блокирующих вызовов.
Используйте фоновый поток
-
Откройте
src/tasks/Request2Background.ktи посмотрите его реализацию. Сначала все вычисления переносятся в другой поток. Функцияthread()запускает новый поток:thread { loadContributorsBlocking(service, req) }Теперь, когда вся загрузка перенесена в отдельный поток, главный поток свободен и может выполнять другие задачи:

-
Сигнатура функции
loadContributorsBackground()изменится. Последним аргументом она принимает обратный вызовupdateResults(), который вызывается после завершения всей загрузки:fun loadContributorsBackground( service: GitHubService, req: RequestData, updateResults: (List<User>) -> Unit ) -
Теперь, когда вызывается
loadContributorsBackground(), вызовupdateResults()выполняется внутри обратного вызова, а не сразу после него, как раньше:loadContributorsBackground(service, req) { users -> SwingUtilities.invokeLater { updateResults(users, startTime) } }Вызвав
SwingUtilities.invokeLater, вы гарантируете, что вызовupdateResults(), обновляющий результаты, произойдет в главном потоке пользовательского интерфейса (потоке обработки событий AWT).
Однако если попытаться загрузить участников с вариантом BACKGROUND, список обновится, но в интерфейсе ничего не изменится.
Задание 2
Исправьте функцию loadContributorsBackground() в src/tasks/Request2Background.kt, чтобы итоговый список отображался в интерфейсе.
Решение задания 2
Если попробовать загрузить участников, в журнале будет видно, что они загружены, но результат не отображается. Чтобы исправить это, вызовите updateResults() для полученного списка пользователей:
thread {
    updateResults(loadContributorsBlocking(service, req))
}
Не забудьте явно вызвать логику, переданную в обратном вызове. Иначе ничего не произойдет.
Используйте API обратных вызовов Retrofit
В предыдущем решении вся логика загрузки перенесена в фоновый поток, но это все еще не самый эффективный способ использования ресурсов. Все запросы на загрузку выполняются последовательно, а поток блокируется в ожидании результата, хотя в это время он мог бы заниматься другими задачами. В частности, поток мог бы начать выполнять следующий запрос, чтобы быстрее получить полный результат.
Обработку данных для каждого репозитория следует разделить на две части: загрузку и обработку полученного ответа. Вторую часть — обработку — нужно вынести в обратный вызов.
Тогда загрузку каждого репозитория можно начинать до получения результата для предыдущего репозитория (и вызова соответствующего обратного вызова):
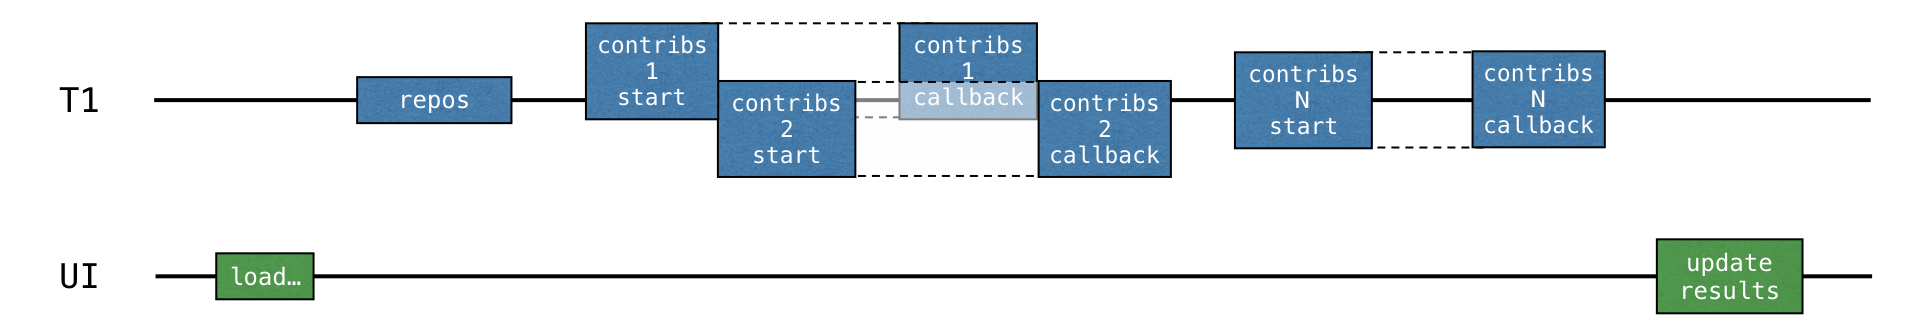
Для этого можно использовать API обратных вызовов Retrofit. Функция Call.enqueue() начинает HTTP-запрос и принимает обратный вызов в качестве аргумента. В этом обратном вызове нужно указать, что следует делать после каждого запроса.
Откройте src/tasks/Request3Callbacks.kt и посмотрите реализацию loadContributorsCallbacks(), использующую этот API:
fun loadContributorsCallbacks(
    service: GitHubService, req: RequestData,
    updateResults: (List<User>) -> Unit
) {
    service.getOrgReposCall(req.org).onResponse { responseRepos ->  // #1
        logRepos(req, responseRepos)
        val repos = responseRepos.bodyList()

        val allUsers = mutableListOf<User>()
        for (repo in repos) {
            service.getRepoContributorsCall(req.org, repo.name)
                .onResponse { responseUsers ->  // #2
                    logUsers(repo, responseUsers)
                    val users = responseUsers.bodyList()
                    allUsers += users
                }
            }
        }
        // TODO: Why doesn't this code work? How to fix that?
        updateResults(allUsers.aggregate())
    }
Для удобства в этом фрагменте кода используется функция-расширение
onResponse(), объявленная в том же файле. Она принимает лямбда-выражение вместо объектного выражения.Логика обработки ответов вынесена в обратные вызовы: соответствующие лямбда-выражения начинаются на строках
#1и#2.
Однако предложенное решение не работает. Если запустить программу и загрузить участников, выбрав вариант ОБРАТНЫЕ ВЫЗОВЫ, вы увидите, что ничего не отображается. При этом тест из Request3CallbacksKtTest сразу сообщает об успешном прохождении.
Подумайте, почему данный код работает не так, как ожидалось, и попробуйте исправить его или ознакомьтесь с решениями ниже.
Задание 3 (необязательно)
Перепишите код в файле src/tasks/Request3Callbacks.kt, чтобы отображался загруженный список участников.
Первая попытка решения задания 3
В текущем решении одновременно запускается множество запросов, что сокращает общее время загрузки. Однако результат не загружается. Причина в том, что обратный вызов updateResults() вызывается сразу после запуска всех запросов на загрузку, до того как список allUsers будет заполнен данными.
Можно попробовать исправить это следующим образом:
val allUsers = mutableListOf<User>()
for ((index, repo) in repos.withIndex()) {   // #1
    service.getRepoContributorsCall(req.org, repo.name)
        .onResponse { responseUsers ->
            logUsers(repo, responseUsers)
            val users = responseUsers.bodyList()
            allUsers += users
            if (index == repos.lastIndex) {    // #2
                updateResults(allUsers.aggregate())
            }
        }
}
Сначала переберите список репозиториев с индексом (
#1).Затем в каждом обратном вызове проверьте, является ли текущая итерация последней (
#2).Если это так, обновите результат.
Однако и этот код не решает задачу. Попробуйте самостоятельно найти причину или ознакомьтесь с решением ниже.
Вторая попытка решения задания 3
Поскольку запросы на загрузку запускаются параллельно, нет гарантии, что результат последнего запроса придет последним. Результаты могут приходить в любом порядке.
Поэтому, если использовать текущий индекс и lastIndex как условие завершения, можно потерять результаты некоторых репозиториев.
Если запрос для последнего репозитория завершится быстрее некоторых предыдущих запросов (что вполне вероятно), результаты более медленных запросов будут потеряны.
Исправить это можно, введя счетчик и проверяя, обработаны ли уже все репозитории:
val allUsers = Collections.synchronizedList(mutableListOf<User>())
val numberOfProcessed = AtomicInteger()
for (repo in repos) {
    service.getRepoContributorsCall(req.org, repo.name)
        .onResponse { responseUsers ->
            logUsers(repo, responseUsers)
            val users = responseUsers.bodyList()
            allUsers += users
            if (numberOfProcessed.incrementAndGet() == repos.size) {
                updateResults(allUsers.aggregate())
            }
        }
}
В этом коде используются синхронизированная версия списка и AtomicInteger(), поскольку в общем случае нельзя гарантировать, что разные обратные вызовы, обрабатывающие запросы getRepoContributors(), всегда будут вызываться из одного потока.
Третья попытка решения задания 3
Еще лучше использовать класс CountDownLatch. Он хранит счетчик, изначально равный количеству репозиториев. После обработки каждого репозитория значение счетчика уменьшается. Затем программа ожидает, пока счетчик не уменьшится до нуля, и только после этого обновляет результаты:
val countDownLatch = CountDownLatch(repos.size)
for (repo in repos) {
    service.getRepoContributorsCall(req.org, repo.name)
        .onResponse { responseUsers ->
            // processing repository
            countDownLatch.countDown()
        }
}
countDownLatch.await()
updateResults(allUsers.aggregate())
Затем результат обновляется из главного потока. Это проще, чем делегировать логику дочерним потокам.
Рассмотрев эти три попытки решения, вы видите, что писать корректный код с обратными вызовами непросто и легко допустить ошибку, особенно при работе с несколькими потоками и синхронизацией.
Приостанавливаемые функции
Ту же логику можно реализовать с помощью приостанавливаемых функций. Вместо возвращения Call<List<Repo>> объявите вызов API как приостанавливаемую функцию следующим образом:
interface GitHubService {
    @GET("orgs/{org}/repos?per_page=100")
    suspend fun getOrgRepos(
        @Path("org") org: String
    ): List<Repo>
}
getOrgRepos()объявлена как функцияsuspend. При использовании приостанавливаемой функции для выполнения запроса исходный поток не блокируется. Подробнее о том, как это работает, будет рассказано в следующих разделах.getOrgRepos()возвращает результат напрямую, а неCall. Если запрос завершится неудачно, будет выброшено исключение.
Также Retrofit позволяет возвращать результат, обернутый в Response. В этом случае возвращается тело ответа, а ошибки можно проверять вручную. В этом руководстве используются версии, возвращающие Response.
Добавьте следующие объявления в интерфейс GitHubService в src/contributors/GitHubService.kt:
interface GitHubService {
    // getOrgReposCall & getRepoContributorsCall declarations

    @GET("orgs/{org}/repos?per_page=100")
    suspend fun getOrgRepos(
        @Path("org") org: String
    ): Response<List<Repo>>

    @GET("repos/{owner}/{repo}/contributors?per_page=100")
    suspend fun getRepoContributors(
        @Path("owner") owner: String,
        @Path("repo") repo: String
    ): Response<List<User>>
}
Задание 4
Ваша задача — изменить код функции, загружающей участников, чтобы использовать две новые приостанавливаемые функции: getOrgRepos() и getRepoContributors(). Новая функция loadContributorsSuspend() помечена как suspend для использования нового API.
Скопируйте реализацию
loadContributorsBlocking(), объявленную вsrc/tasks/Request1Blocking.kt, вloadContributorsSuspend(), объявленную вsrc/tasks/Request4Suspend.kt.Измените код так, чтобы вместо функций, возвращающих
Call, использовались новые приостанавливаемые функции.Запустите программу, выбрав вариант ПРИОСТАНОВКА, и убедитесь, что интерфейс остается отзывчивым во время выполнения запросов к GitHub.
Решение задания 4
Замените .getOrgReposCall(req.org).execute() на .getOrgRepos(req.org) и выполните такую же замену для второго запроса «contributors»:
suspend fun loadContributorsSuspend(service: GitHubService, req: RequestData): List<User> {
    val repos = service
        .getOrgRepos(req.org)
        .also { logRepos(req, it) }
        .bodyList()

    return repos.flatMap { repo ->
        service.getRepoContributors(req.org, repo.name)
            .also { logUsers(repo, it) }
            .bodyList()
    }.aggregate()
}
loadContributorsSuspend()должна быть объявлена как функцияsuspend.Теперь больше не нужно вызывать
execute, которая раньше возвращалаResponse, поскольку теперь функции API возвращают непосредственноResponse. Обратите внимание, что эта особенность относится именно к библиотеке Retrofit. В других библиотеках API может отличаться, но сама концепция остается прежней.
Сопрограммы
Код с приостанавливаемыми функциями выглядит похоже на «блокирующую» версию. Главное отличие от блокирующей версии состоит в том, что вместо блокировки потока сопрограмма приостанавливается:
block -> suspend
thread -> coroutine
Запуск новой сопрограммы
Если посмотреть, как используется loadContributorsSuspend() в src/contributors/Contributors.kt, можно увидеть, что он вызывается внутри launch. launch — это библиотечная функция, принимающая лямбду в качестве аргумента:
launch {
    val users = loadContributorsSuspend(req)
    updateResults(users, startTime)
}
Здесь launch запускает новое вычисление, отвечающее за загрузку данных и отображение результатов. Это вычисление можно приостанавливать: при выполнении сетевых запросов оно приостанавливается и освобождает используемый поток. Когда сетевой запрос возвращает результат, вычисление возобновляется.
Такое приостанавливаемое вычисление называется сопрограммой. Таким образом, в данном случае launch запускает новую сопрограмму, отвечающую за загрузку данных и отображение результатов.
Сопрограммы выполняются поверх потоков и могут приостанавливаться. Когда сопрограмма приостанавливается, соответствующее вычисление ставится на паузу, снимается с потока и сохраняется в памяти. Тем временем поток может выполнять другие задачи:

Когда вычисление будет готово к продолжению, оно возвращается в поток (не обязательно в тот же самый).
В примере loadContributorsSuspend() каждый запрос «contributors» теперь ожидает результат с помощью механизма приостановки. Сначала отправляется новый запрос. Затем, пока ожидается ответ, приостанавливается вся сопрограмма «load contributors», запущенная функцией launch.
Сопрограмма возобновляется только после получения соответствующего ответа:
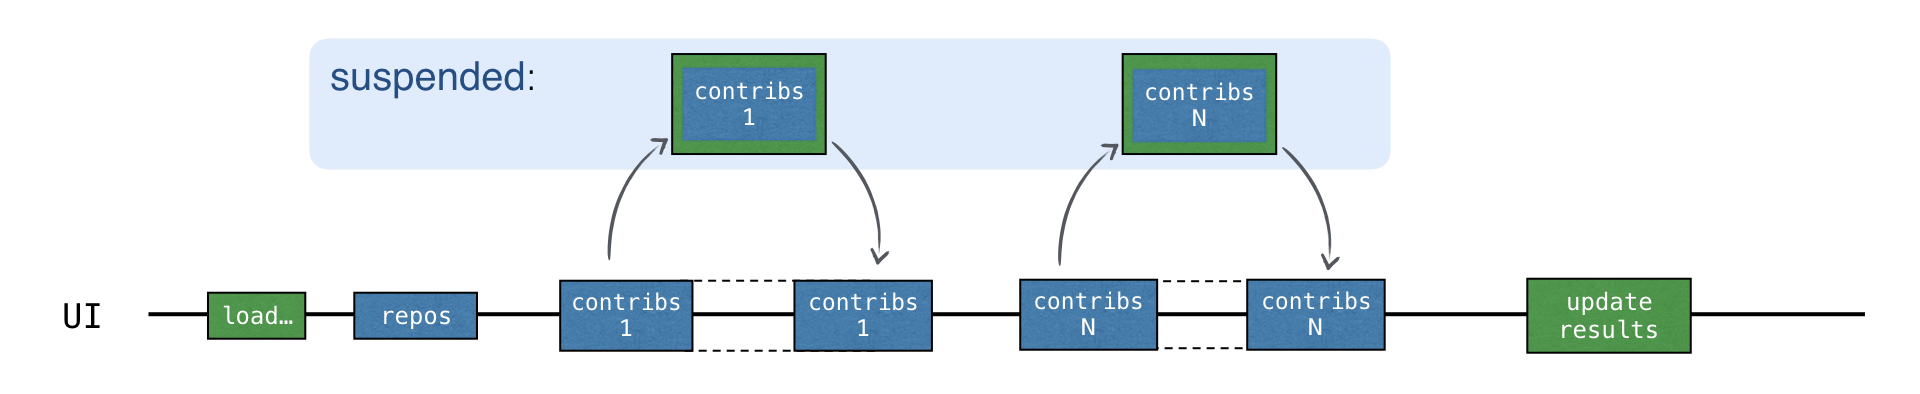
Пока ожидается получение ответа, поток может выполнять другие задачи. Интерфейс остаётся отзывчивым, хотя все запросы выполняются в основном потоке пользовательского интерфейса:
-
Запустите программу с параметром SUSPEND. В журнале видно, что все запросы отправляются из основного потока пользовательского интерфейса:
2538 [AWT-EventQueue-0 @coroutine#1] INFO  Contributors - kotlin: loaded 30 repos
2729 [AWT-EventQueue-0 @coroutine#1] INFO  Contributors - ts2kt: loaded 11 contributors
3029 [AWT-EventQueue-0 @coroutine#1] INFO  Contributors - kotlin-koans: loaded 45 contributors
...
11252 [AWT-EventQueue-0 @coroutine#1] INFO  Contributors - kotlin-coroutines-workshop: loaded 1 contributors
-
В журнале можно увидеть, в какой сопрограмме выполняется соответствующий код. Чтобы включить эту возможность, откройте Run | Edit configurations и добавьте параметр
-Dkotlinx.coroutines.debugвиртуальной машины: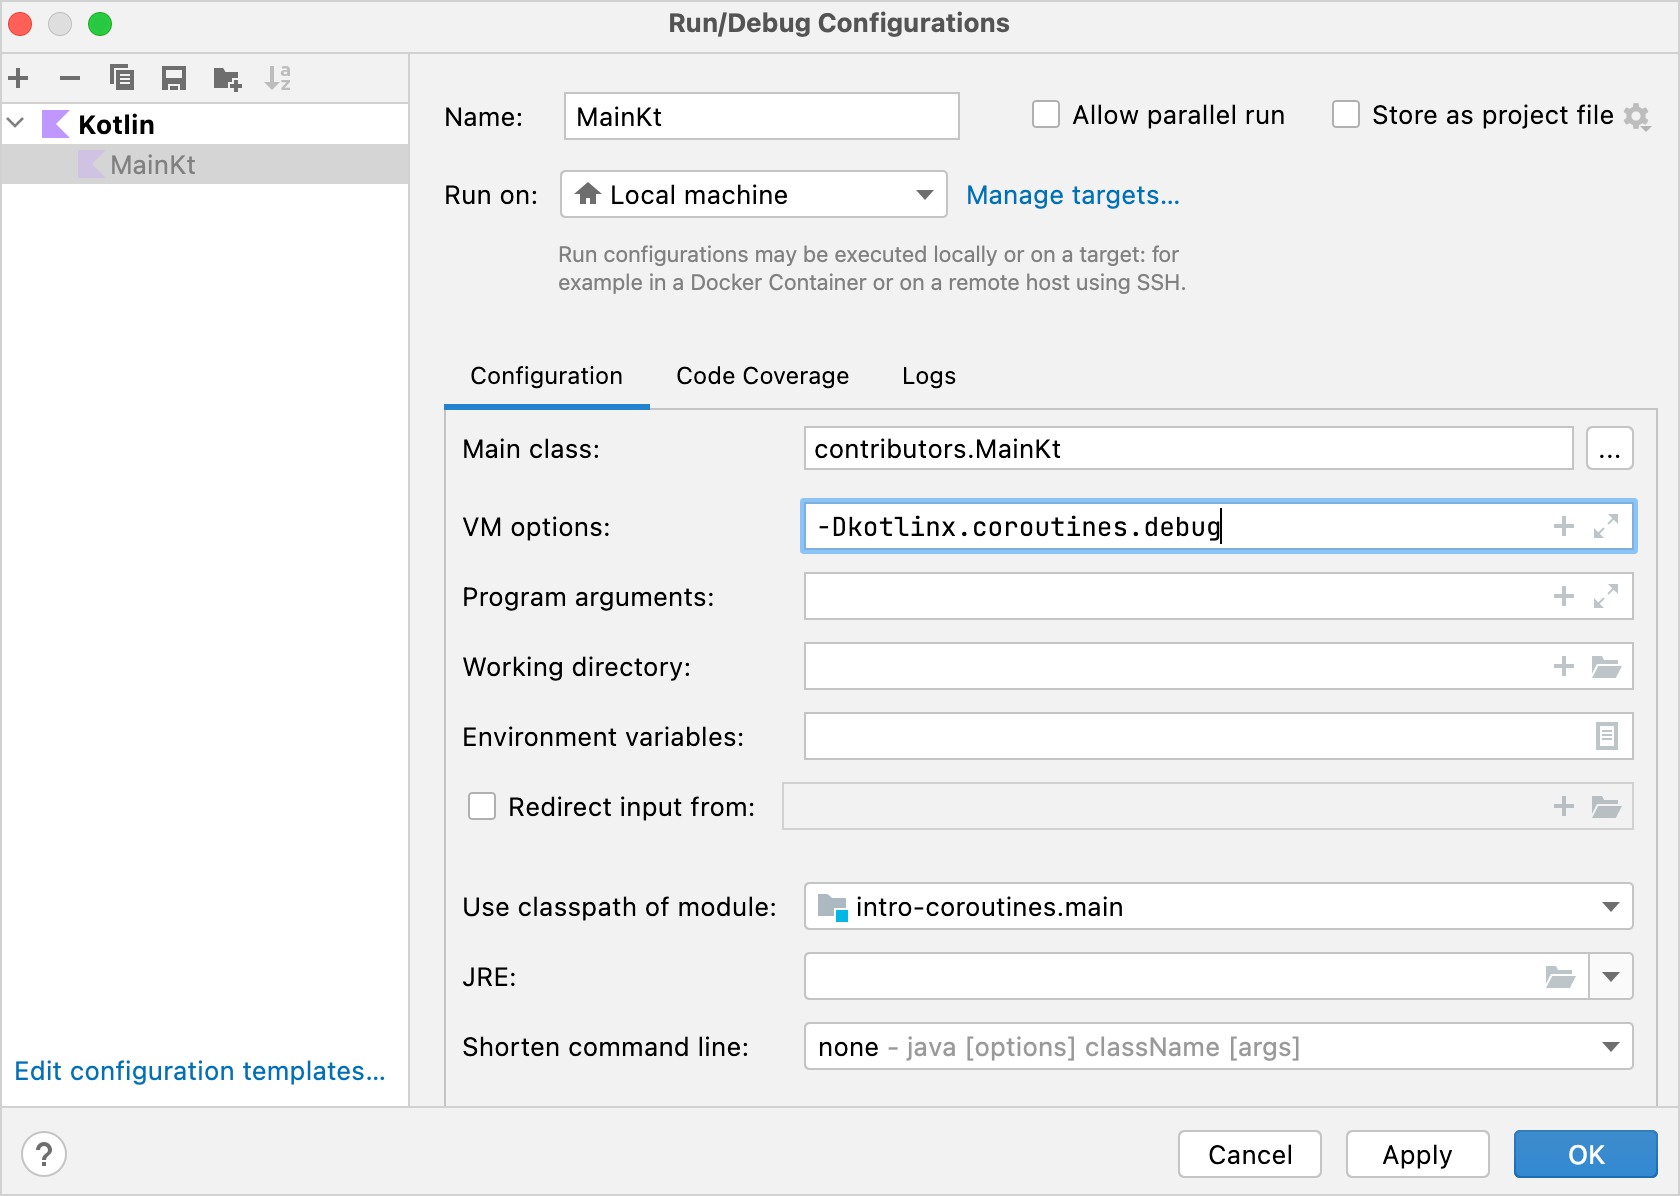
Если
main()запущен с этим параметром, имя сопрограммы будет добавлено к имени потока. Вы также можете изменить шаблон запуска всех файлов Kotlin и включить этот параметр по умолчанию.
Теперь весь код выполняется в одной сопрограмме — упомянутой выше сопрограмме «load contributors», обозначенной как @coroutine#1. Пока ожидается результат, не следует использовать поток повторно для отправки других запросов, поскольку код написан последовательно. Новый запрос отправляется только после получения предыдущего результата.
Приостанавливаемые функции справедливо используют поток и не блокируют его в ожидании. Однако это пока не обеспечивает параллельность.
Параллельное выполнение
Сопрограммы Kotlin требуют гораздо меньше ресурсов, чем потоки. Каждый раз, когда нужно асинхронно запустить новое вычисление, вместо этого можно создать новую сопрограмму.
Чтобы запустить новую сопрограмму, используйте один из основных строителей сопрограмм: launch, async или runBlocking. Различные библиотеки могут определять дополнительные строители сопрограмм.
async запускает новую сопрограмму и возвращает объект Deferred. Deferred представляет понятие, известное также под такими названиями, как Future или Promise. Он хранит вычисление, но откладывает получение окончательного результата; он обещает результат в некоторый момент в будущем.
Главное различие между async и launch состоит в том, что launch используется для запуска вычисления, от которого не ожидается конкретный результат. launch возвращает Job, представляющий сопрограмму. Можно дождаться её завершения, вызвав Job.join().
Deferred — это обобщённый тип, расширяющий Job. Вызов async может вернуть Deferred<Int> или Deferred<CustomType> — это зависит от того, что возвращает лямбда (результатом является последнее выражение внутри лямбды).
Чтобы получить результат сопрограммы, можно вызвать await() для экземпляра Deferred. Во время ожидания результата приостанавливается сопрограмма, из которой вызывается этот await():
import kotlinx.coroutines.*

fun main() = runBlocking {
    val deferred: Deferred<Int> = async {
        loadData()
    }
    println("waiting...")
    println(deferred.await())
}

suspend fun loadData(): Int {
    println("loading...")
    delay(1000L)
    println("loaded!")
    return 42
}
runBlocking служит связующим звеном между обычными и приостанавливаемыми функциями, а также между блокирующим и неблокирующим кодом. Она используется как адаптер для запуска основной сопрограммы верхнего уровня. В первую очередь она предназначена для использования в функциях main() и тестах.
Если имеется список отложенных объектов, можно вызвать awaitAll(), чтобы дождаться результатов всех объектов:
import kotlinx.coroutines.*

fun main() = runBlocking {
    val deferreds: List<Deferred<Int>> = (1..3).map {
        async {
            delay(1000L * it)
            println("Loading $it")
            it
        }
    }
    val sum = deferreds.awaitAll().sum()
    println("$sum")
}
Когда каждый запрос «contributors» запускается в новой сопрограмме, все запросы выполняются асинхронно. Новый запрос можно отправить, не дожидаясь получения результата предыдущего:
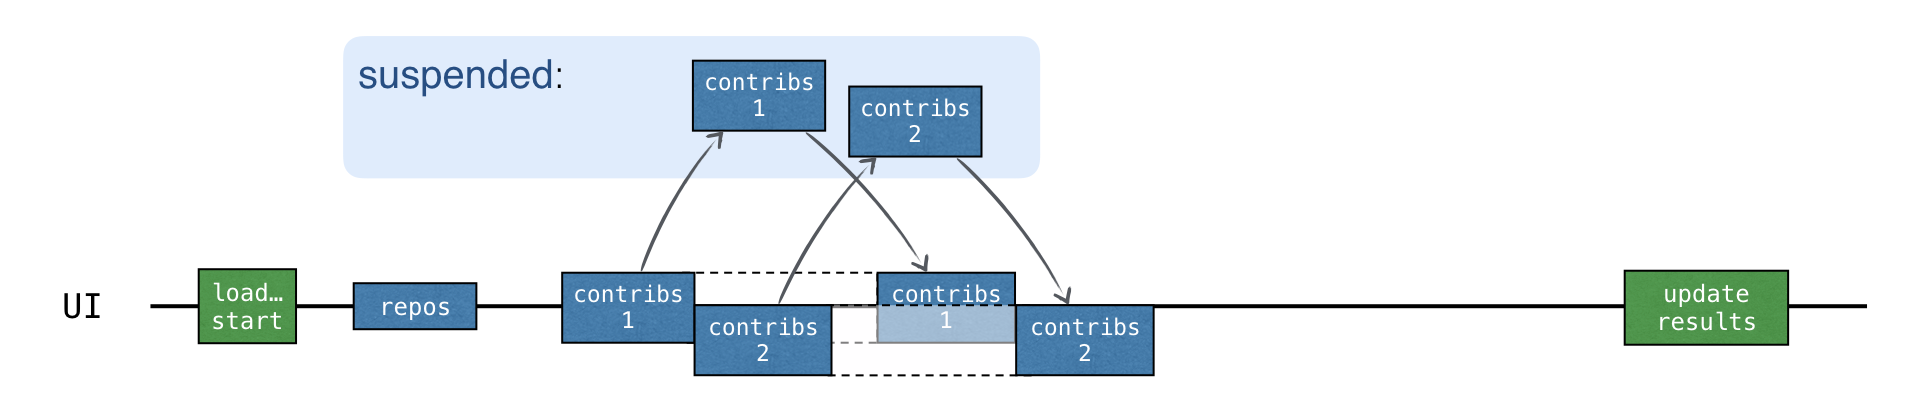
Общее время загрузки примерно такое же, как в версии CALLBACKS, но обратные вызовы не нужны. Кроме того, async явно показывает, какие части кода выполняются параллельно.
Задание 5
В файле Request5Concurrent.kt реализуйте функцию loadContributorsConcurrent(), используя предыдущую функцию loadContributorsSuspend().
Подсказка к заданию 5
Запустить новую сопрограмму можно только внутри области видимости сопрограммы. Скопируйте содержимое из loadContributorsSuspend() в вызов coroutineScope, чтобы там можно было вызывать функции async:
suspend fun loadContributorsConcurrent(
    service: GitHubService,
    req: RequestData
): List<User> = coroutineScope {
    // ...
}
Основывайте решение на следующей схеме:
val deferreds: List<Deferred<List<User>>> = repos.map { repo ->
    async {
        // load contributors for each repo
    }
}
deferreds.awaitAll() // List<List<User>>
Решение задания 5
Оберните каждый запрос «contributors» в async, чтобы создать столько сопрограмм, сколько имеется репозиториев. async возвращает Deferred<List<User>>. Это не проблема: создание новых сопрограмм не требует много ресурсов, поэтому их можно создавать столько, сколько нужно.
-
Теперь нельзя использовать
flatMap, поскольку результатmap— это список объектовDeferred, а не список списков.awaitAll()возвращаетList<List<User>>, поэтому вызовитеflatten().aggregate(), чтобы получить результат:suspend fun loadContributorsConcurrent( service: GitHubService, req: RequestData ): List<User> = coroutineScope { val repos = service .getOrgRepos(req.org) .also { logRepos(req, it) } .bodyList() val deferreds: List<Deferred<List<User>>> = repos.map { repo -> async { service.getRepoContributors(req.org, repo.name) .also { logUsers(repo, it) } .bodyList() } } deferreds.awaitAll().flatten().aggregate() } Запустите код и проверьте журнал. Все сопрограммы по-прежнему выполняются в основном потоке пользовательского интерфейса, поскольку многопоточность ещё не задействована, но преимущества параллельного выполнения сопрограмм уже заметны.
-
Чтобы изменить код и выполнять сопрограммы «contributors» в разных потоках из общего пула потоков, укажите
Dispatchers.Defaultв качестве аргумента контекста функцииasync:async(Dispatchers.Default) { }CoroutineDispatcherопределяет, в каком потоке или потоках должна выполняться соответствующая сопрограмма. Если не указать его в качестве аргумента,asyncбудет использовать диспетчер из внешней области видимости.Dispatchers.Defaultпредставляет собой общий пул потоков в JVM. Этот пул позволяет выполнять задачи параллельно. Он состоит из такого же количества потоков, сколько доступно ядер процессора, но даже при наличии всего одного ядра в нём будет два потока.
-
Измените код функции
loadContributorsConcurrent()так, чтобы новые сопрограммы запускались в разных потоках из общего пула потоков. Также добавьте дополнительную запись в журнал перед отправкой запроса:async(Dispatchers.Default) { log("starting loading for ${repo.name}") service.getRepoContributors(req.org, repo.name) .also { logUsers(repo, it) } .bodyList() } -
Запустите программу ещё раз. В журнале видно, что каждая сопрограмма может запуститься в одном потоке из пула, а возобновиться — в другом:
1946 [DefaultDispatcher-worker-2 @coroutine#4] INFO  Contributors - starting loading for kotlin-koans
1946 [DefaultDispatcher-worker-3 @coroutine#5] INFO  Contributors - starting loading for dokka
1946 [DefaultDispatcher-worker-1 @coroutine#3] INFO  Contributors - starting loading for ts2kt
...
2178 [DefaultDispatcher-worker-1 @coroutine#4] INFO  Contributors - kotlin-koans: loaded 45 contributors
2569 [DefaultDispatcher-worker-1 @coroutine#5] INFO  Contributors - dokka: loaded 36 contributors
2821 [DefaultDispatcher-worker-2 @coroutine#3] INFO  Contributors - ts2kt: loaded 11 contributors
Например, в этом фрагменте журнала
coroutine#4запускается в потокеworker-2, а продолжается в потокеworker-1.
В src/contributors/Contributors.kt проверьте реализацию параметра CONCURRENT:
-
Чтобы сопрограмма выполнялась только в основном потоке пользовательского интерфейса, укажите в качестве аргумента
Dispatchers.Main:launch(Dispatchers.Main) { updateResults() }Если основной поток занят в момент запуска в нём новой сопрограммы, она приостанавливается и ставится в очередь на выполнение в этом потоке. Сопрограмма возобновится, только когда поток освободится.
Рекомендуется использовать диспетчер из внешней области видимости, а не указывать его явно для каждой конечной точки. Если определить
loadContributorsConcurrent()без передачиDispatchers.Defaultв качестве аргумента, эту функцию можно будет вызвать в любом контексте: с диспетчеромDefault, в основном потоке пользовательского интерфейса или с пользовательским диспетчером.Как вы увидите далее, при вызове
loadContributorsConcurrent()из тестов можно использовать контекст сTestDispatcher, что упрощает тестирование. Это делает такое решение гораздо более гибким.
-
Чтобы указать диспетчер на стороне вызывающего кода, внесите в проект следующие изменения, при этом
loadContributorsConcurrentбудет запускать сопрограммы в унаследованном контексте:launch(Dispatchers.Default) { val users = loadContributorsConcurrent(service, req) withContext(Dispatchers.Main) { updateResults(users, startTime) } }updateResults()нужно вызывать в основном потоке пользовательского интерфейса, поэтому вызовите её в контекстеDispatchers.Main.withContext()выполняет переданный код в указанном контексте сопрограммы, приостанавливается до его завершения и возвращает результат. Это можно выразить иначе, но более многословно: запустить новую сопрограмму и явно дождаться её завершения (приостанавливая выполнение):launch(context) { ... }.join().
Запустите код и убедитесь, что сопрограммы выполняются в потоках из пула потоков.
Структурированная конкурентность
Область видимости сопрограммы отвечает за структуру и отношения «родитель — потомок» между разными сопрограммами. Новые сопрограммы обычно нужно запускать внутри области видимости.
Контекст сопрограммы хранит дополнительную техническую информацию, используемую для выполнения данной сопрограммы, например её пользовательское имя или диспетчер, указывающий, в каких потоках следует планировать её выполнение.
При запуске новой сопрограммы с помощью launch, async или runBlocking автоматически создаётся соответствующая область видимости. Все эти функции принимают в качестве аргумента лямбду с получателем, а CoroutineScope — это неявный тип получателя:
launch { /* this: CoroutineScope */ }
Новые сопрограммы можно запускать только внутри области видимости.
launchиasyncобъявлены как расширенияCoroutineScope, поэтому при их вызове всегда нужно передавать неявного или явного получателя.Сопрограмма, запускаемая с помощью
runBlocking, — единственное исключение, посколькуrunBlockingопределена как функция верхнего уровня. Но она блокирует текущий поток, поэтому в первую очередь предназначена для использования в функцияхmain()и тестах в качестве связующей функции.
Новая сопрограмма внутри runBlocking, launch или async автоматически запускается в соответствующей области видимости:
import kotlinx.coroutines.*

fun main() = runBlocking { /* this: CoroutineScope */
    launch { /* ... */ }
    // the same as:
    this.launch { /* ... */ }
}
При вызове launch внутри runBlocking она вызывается как расширение неявного получателя типа CoroutineScope. В качестве альтернативы можно явно написать this.launch.
Вложенную сопрограмму (в этом примере она запускается с помощью launch) можно считать дочерней по отношению к внешней сопрограмме (запущенной с помощью runBlocking). Эта связь «родитель — потомок» обеспечивается областями видимости: дочерняя сопрограмма запускается из области видимости, соответствующей родительской сопрограмме.
Создать новую область видимости, не запуская новую сопрограмму, можно с помощью функции coroutineScope. Чтобы структурированно запускать новые сопрограммы внутри функции suspend без доступа к внешней области видимости, можно создать новую область видимости сопрограммы, которая автоматически станет дочерней по отношению к внешней области видимости, из которой вызывается эта функция suspend. Хороший пример — loadContributorsConcurrent().
Также можно запустить новую сопрограмму из глобальной области видимости с помощью GlobalScope.async или GlobalScope.launch. В результате будет создана независимая сопрограмма верхнего уровня.
Механизм, лежащий в основе структуры сопрограмм, называется структурированной конкурентностью. По сравнению с глобальными областями видимости он даёт следующие преимущества:
Область видимости, как правило, отвечает за дочерние сопрограммы, время жизни которых ограничено временем жизни этой области видимости.
Область видимости может автоматически отменить дочерние сопрограммы, если что-то пошло не так или пользователь передумал и решил отменить операцию.
Область видимости автоматически дожидается завершения всех дочерних сопрограмм. Поэтому, если область видимости соответствует сопрограмме, родительская сопрограмма не завершится, пока не завершатся все запущенные в её области видимости сопрограммы.
При использовании GlobalScope.async отсутствует структура, связывающая несколько сопрограмм с областью видимости меньшего масштаба. Сопрограммы, запущенные из глобальной области видимости, независимы друг от друга: время их жизни ограничено только временем жизни всего приложения. Можно сохранить ссылку на сопрограмму, запущенную из глобальной области видимости, и дождаться её завершения или явно отменить её, но автоматически, как при структурированной конкурентности, этого не произойдёт.
Отмена загрузки участников
Создайте две версии функции, загружающей список участников. Сравните поведение обеих версий при попытке отменить родительскую сопрограмму. В первой версии для запуска всех дочерних сопрограмм будет использоваться coroutineScope, а во второй — GlobalScope.
-
В
Request5Concurrent.ktдобавьте задержку на 3 секунды в функциюloadContributorsConcurrent():suspend fun loadContributorsConcurrent( service: GitHubService, req: RequestData ): List<User> = coroutineScope { // ... async { log("starting loading for ${repo.name}") delay(3000) // load repo contributors } // ... }Задержка затрагивает все сопрограммы, отправляющие запросы, поэтому после их запуска, но до отправки запросов, будет достаточно времени, чтобы отменить загрузку.
Создайте вторую версию функции загрузки: скопируйте реализацию
loadContributorsConcurrent()вloadContributorsNotCancellable()вRequest5NotCancellable.kt, а затем удалите создание новогоcoroutineScope.-
Теперь вызовы
asyncне разрешаются, поэтому запускайте их с помощьюGlobalScope.async:suspend fun loadContributorsNotCancellable( service: GitHubService, req: RequestData ): List<User> { // #1 // ... GlobalScope.async { // #2 log("starting loading for ${repo.name}") // load repo contributors } // ... return deferreds.awaitAll().flatten().aggregate() // #3 }Теперь функция возвращает результат напрямую, а не в качестве последнего выражения внутри лямбды (строки
#1и#3).Все сопрограммы «contributors» запускаются внутри
GlobalScope, а не как дочерние сопрограммы в области видимости (строка#2).
Запустите программу и выберите параметр CONCURRENT, чтобы загрузить участников.
-
Дождитесь запуска всех сопрограмм «contributors», а затем нажмите Cancel. В журнале не появляются новые результаты, значит, все запросы действительно были отменены:
2896 [AWT-EventQueue-0 @coroutine#1] INFO  Contributors - kotlin: loaded 40 repos
2901 [DefaultDispatcher-worker-2 @coroutine#4] INFO  Contributors - starting loading for kotlin-koans
...
2909 [DefaultDispatcher-worker-5 @coroutine#36] INFO  Contributors - starting loading for mpp-example
/* click on 'cancel' */
/* no requests are sent */
-
Повторите шаг 5, но на этот раз выберите параметр
NOT_CANCELLABLE:2570 [AWT-EventQueue-0 @coroutine#1] INFO Contributors - kotlin: loaded 30 repos 2579 [DefaultDispatcher-worker-1 @coroutine#4] INFO Contributors - starting loading for kotlin-koans ... 2586 [DefaultDispatcher-worker-6 @coroutine#36] INFO Contributors - starting loading for mpp-example /* click on 'cancel' */ /* but all the requests are still sent: */ 6402 [DefaultDispatcher-worker-5 @coroutine#4] INFO Contributors - kotlin-koans: loaded 45 contributors ... 9555 [DefaultDispatcher-worker-8 @coroutine#36] INFO Contributors - mpp-example: loaded 8 contributors
В этом случае сопрограммы не отменяются, и все запросы по-прежнему отправляются.
-
Проверьте, как запускается отмена в программе «contributors». При нажатии кнопки Cancel основная сопрограмма «loading» отменяется явно, а дочерние сопрограммы отменяются автоматически:
interface Contributors {

    fun loadContributors() {
        // ...
        when (getSelectedVariant()) {
            CONCURRENT -> {
                launch {
                    val users = loadContributorsConcurrent(service, req)
                    updateResults(users, startTime)
                }.setUpCancellation()      // #1
            }
        }
    }

    private fun Job.setUpCancellation() {
        val loadingJob = this              // #2

        // cancel the loading job if the 'cancel' button was clicked:
        val listener = ActionListener {
            loadingJob.cancel()            // #3
            updateLoadingStatus(CANCELED)
        }
        // add a listener to the 'cancel' button:
        addCancelListener(listener)

        // update the status and remove the listener
        // after the loading job is completed
    }
}
Функция launch возвращает экземпляр Job. Job хранит ссылку на «сопрограмму загрузки», которая загружает все данные и обновляет результаты. Для неё можно вызвать функцию-расширение setUpCancellation() (строка #1), передав экземпляр Job в качестве получателя.
Другой способ выразить это — написать явно:
val job = launch { }
job.setUpCancellation()
Для удобства чтения можно обратиться к получателю функции
setUpCancellation()внутри функции через новую переменнуюloadingJob(строка#2).Затем можно добавить обработчик для кнопки Cancel, чтобы при её нажатии отменялась
loadingJob(строка#3).
При структурированной конкурентности достаточно отменить родительскую сопрограмму — отмена автоматически распространится на все дочерние сопрограммы.
Использование контекста внешней области видимости
При запуске новых сопрограмм внутри заданной области видимости гораздо проще обеспечить выполнение их всех в одном контексте. При необходимости заменить контекст это также сделать гораздо проще.
Теперь разберём, как работает использование диспетчера из внешней области видимости. Новая область видимости, созданная с помощью coroutineScope или строителей сопрограмм, всегда наследует контекст внешней области видимости. В данном случае внешняя область видимости — это область, из которой была вызвана функция suspend loadContributorsConcurrent():
launch(Dispatchers.Default) {  // outer scope
    val users = loadContributorsConcurrent(service, req)
    // ...
}
Все вложенные сопрограммы автоматически запускаются в унаследованном контексте. Диспетчер является частью этого контекста. Поэтому все сопрограммы, запущенные с помощью async, запускаются в контексте диспетчера по умолчанию:
suspend fun loadContributorsConcurrent(
    service: GitHubService, req: RequestData
): List<User> = coroutineScope {
    // this scope inherits the context from the outer scope
    // ...
    async {   // nested coroutine started with the inherited context
        // ...
    }
    // ...
}
При структурированной конкурентности основные элементы контекста (например, диспетчер) можно указать один раз при создании сопрограммы верхнего уровня. Все вложенные сопрограммы наследуют этот контекст и изменяют его только при необходимости.
Отображение прогресса
Несмотря на то что данные некоторых репозиториев загружаются довольно быстро, пользователь видит итоговый список только после загрузки всех данных. До этого момента индикатор загрузки показывает процесс, но не отображает сведения о текущем состоянии или о том, какие участники уже загружены.
Можно раньше показывать промежуточные результаты и отображать всех участников по мере загрузки данных для каждого репозитория:

Чтобы реализовать эту функциональность, в src/tasks/Request6Progress.kt нужно передать логику обновления пользовательского интерфейса в качестве обратного вызова, чтобы она вызывалась при каждом промежуточном состоянии:
suspend fun loadContributorsProgress(
    service: GitHubService,
    req: RequestData,
    updateResults: suspend (List<User>, completed: Boolean) -> Unit
) {
    // loading the data
    // calling `updateResults()` on intermediate states
}
В месте вызова в Contributors.kt обратный вызов передаётся для обновления результатов из потока Main при выборе параметра PROGRESS:
launch(Dispatchers.Default) {
    loadContributorsProgress(service, req) { users, completed ->
        withContext(Dispatchers.Main) {
            updateResults(users, startTime, completed)
        }
    }
}
Параметр
updateResults()объявлен какsuspendвloadContributorsProgress(). Это необходимо для вызоваwithContext, являющейся функциейsuspendвнутри соответствующего аргумента-лямбды.Обратный вызов
updateResults()принимает дополнительный логический параметр, указывающий, завершилась ли загрузка и являются ли результаты окончательными.
Задание 6
В файле Request6Progress.kt реализуйте функцию loadContributorsProgress(), отображающую промежуточный прогресс. Возьмите за основу функцию loadContributorsSuspend() из Request4Suspend.kt.
Используйте простую версию без параллельного выполнения; оно будет добавлено в следующем разделе.
Промежуточный список участников должен отображаться в агрегированном виде, а не просто как список пользователей, загруженных для каждого репозитория.
Общее количество вкладов каждого пользователя должно увеличиваться при загрузке данных для каждого нового репозитория.
Решение задания 6
Чтобы хранить промежуточный список загруженных участников в агрегированном виде, объявите переменную allUsers для хранения списка пользователей, а затем обновляйте её после загрузки участников каждого нового репозитория:
suspend fun loadContributorsProgress(
    service: GitHubService,
    req: RequestData,
    updateResults: suspend (List<User>, completed: Boolean) -> Unit
) {
    val repos = service
        .getOrgRepos(req.org)
        .also { logRepos(req, it) }
        .bodyList()

    var allUsers = emptyList<User>()
    for ((index, repo) in repos.withIndex()) {
        val users = service.getRepoContributors(req.org, repo.name)
            .also { logUsers(repo, it) }
            .bodyList()

        allUsers = (allUsers + users).aggregate()
        updateResults(allUsers, index == repos.lastIndex)
    }
}
Последовательное и параллельное выполнение
Обратный вызов updateResults() вызывается после завершения каждого запроса:
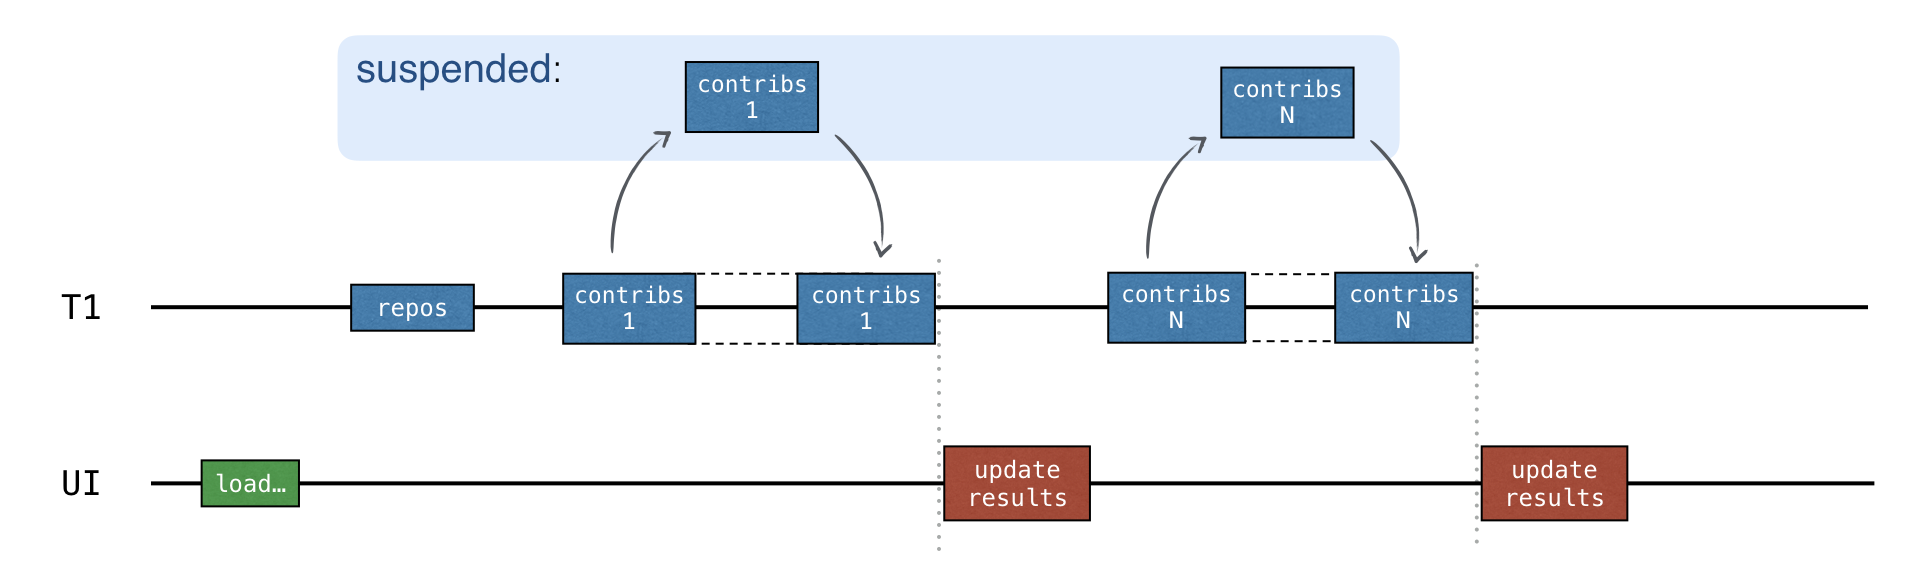
В этом коде нет параллельного выполнения. Он выполняется последовательно, поэтому синхронизация не нужна.
Лучше отправлять запросы параллельно и обновлять промежуточные результаты после получения ответа для каждого репозитория:
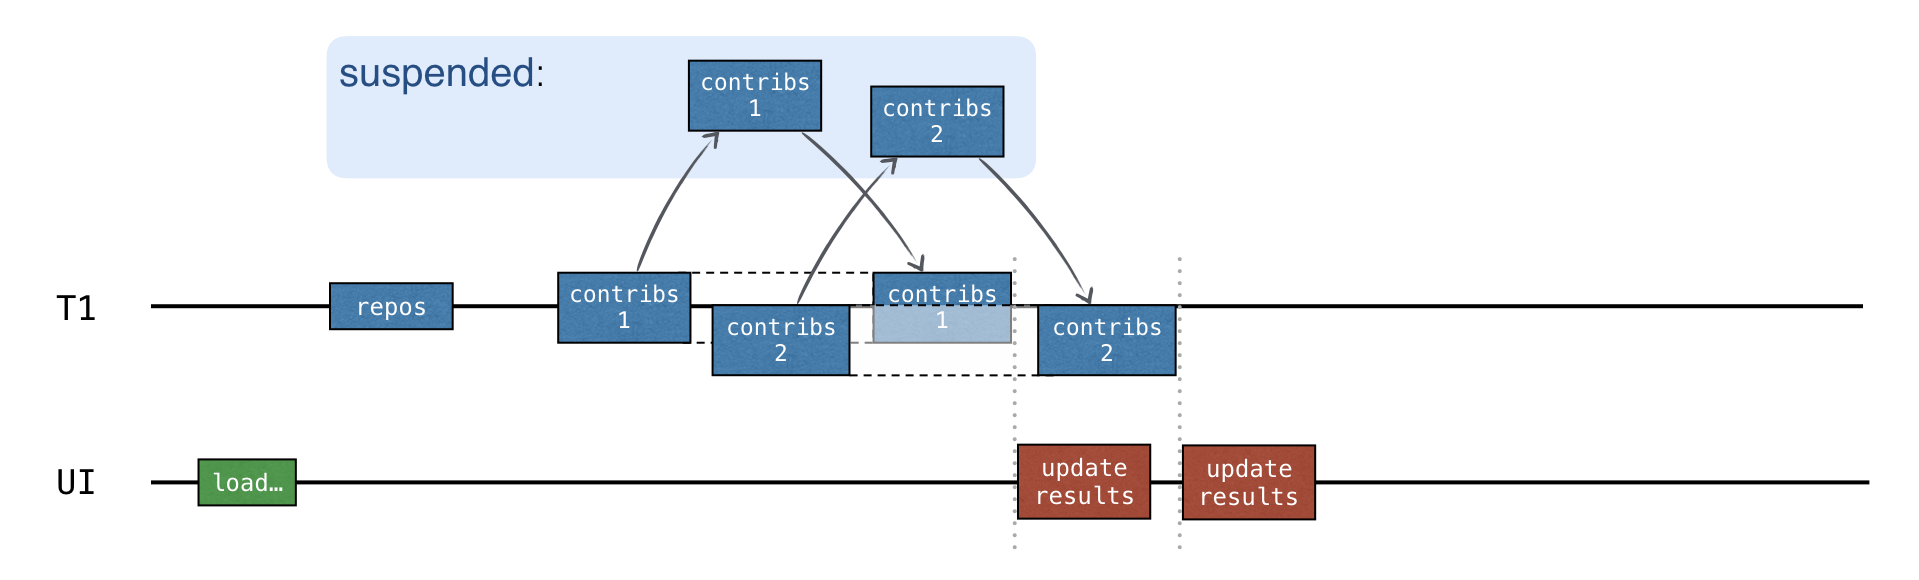
Чтобы добавить параллельное выполнение, используйте каналы.
Каналы
Писать код с общим изменяемым состоянием довольно сложно и чревато ошибками (как в решении с использованием обратных вызовов). Более простой способ — обмениваться информацией, а не использовать общее изменяемое состояние. Корутины могут обмениваться данными друг с другом с помощью каналов.
Каналы — это примитивы для обмена данными, которые позволяют передавать данные между корутинами. Одна корутина может отправить некоторую информацию в канал, а другая — получить её из него:

Корутину, которая отправляет (производит) информацию, часто называют производителем, а корутину, которая получает (потребляет) информацию, — потребителем. Одна или несколько корутин могут отправлять информацию в один и тот же канал, а одна или несколько корутин — получать из него данные:

Если информацию из одного и того же канала получают несколько корутин, каждый элемент обрабатывается только один раз одной из них. После обработки элемент сразу удаляется из канала.
Канал можно представить как коллекцию элементов, точнее, как очередь, в которую элементы добавляются с одного конца, а извлекаются с другого. Однако есть важное отличие: в отличие от коллекций, даже их синхронизированных версий, канал может приостанавливать send() и receive() операции. Это происходит, когда канал пуст или заполнен. Канал может быть заполнен, если его размер ограничен сверху.
Channel представлен тремя различными интерфейсами: SendChannel, ReceiveChannel и Channel, причём последний расширяет первые два. Обычно вы создаёте канал и передаёте его производителям как экземпляр SendChannel, чтобы только они могли отправлять информацию в канал. Потребителям вы передаёте канал как экземпляр ReceiveChannel, чтобы только они могли получать из него данные. Методы send и receive объявлены как suspend:
interface SendChannel<in E> {
    suspend fun send(element: E)
    fun close(): Boolean
}

interface ReceiveChannel<out E> {
    suspend fun receive(): E
}

interface Channel<E> : SendChannel<E>, ReceiveChannel<E>
Производитель может закрыть канал, чтобы сообщить, что новых элементов больше не будет.
В библиотеке определено несколько типов каналов. Они различаются количеством элементов, которые могут хранить внутри себя, а также тем, может ли вызов send() быть приостановлен. Для всех типов каналов вызов receive() работает одинаково: он получает элемент, если канал не пуст, иначе приостанавливается.
- Канал без ограничений
-
Канал без ограничений — наиболее близкий аналог очереди: производители могут отправлять в него элементы, и он будет расти бесконечно. Вызов
send()никогда не будет приостановлен. Если в программе закончится память, вы получитеOutOfMemoryException. Отличие канала без ограничений от очереди заключается в том, что когда потребитель пытается получить элемент из пустого канала, он приостанавливается, пока не будут отправлены новые элементы.
- Буферизованный канал
-
Размер буферизованного канала ограничен заданным числом. Производители могут отправлять в этот канал элементы, пока не будет достигнут предел размера. Все элементы хранятся внутри канала. Когда канал заполнен, следующий вызов
send()приостанавливается, пока не освободится место.
- Канал «Рандеву»
-
Канал «Рандеву» — это канал без буфера, то же самое, что буферизованный канал нулевого размера. Одна из функций (
send()илиreceive()) всегда приостанавливается, пока не будет вызвана другая.Если вызывается функция
send(), а приостановленного вызоваreceive(), готового обработать элемент, нет, тоsend()приостанавливается. Аналогично, если вызывается функцияreceive(), а канал пуст или, другими словами, нет приостановленного вызоваsend(), готового отправить элемент, вызовreceive()приостанавливается.Название «рандеву» («встреча в условленное время и в условленном месте») указывает на то, что
send()иreceive()должны «встретиться вовремя».
- Канал с объединением
-
Новый элемент, отправленный в канал с объединением, перезапишет ранее отправленный элемент, поэтому получатель всегда будет получать только последний элемент. Вызов
send()никогда не приостанавливается.

При создании канала укажите его тип или размер буфера (если нужен буферизованный канал):
val rendezvousChannel = Channel<String>()
val bufferedChannel = Channel<String>(10)
val conflatedChannel = Channel<String>(CONFLATED)
val unlimitedChannel = Channel<String>(UNLIMITED)
По умолчанию создаётся канал «Рандеву».
В следующем задании вы создадите канал «Рандеву», две корутины-производителя и корутину-потребителя:
import kotlinx.coroutines.channels.Channel
import kotlinx.coroutines.*

fun main() = runBlocking<Unit> {
    val channel = Channel<String>()
    launch {
        channel.send("A1")
        channel.send("A2")
        log("A done")
    }
    launch {
        channel.send("B1")
        log("B done")
    }
    launch {
        repeat(3) {
            val x = channel.receive()
            log(x)
        }
    }
}

fun log(message: Any?) {
    println("[${Thread.currentThread().name}] $message")
}
Задание 7
В src/tasks/Request7Channels.kt реализуйте функцию loadContributorsChannels(), которая одновременно запрашивает всех участников GitHub и показывает промежуточный ход выполнения.
Используйте предыдущие функции: loadContributorsConcurrent() из Request5Concurrent.kt и loadContributorsProgress() из Request6Progress.kt.
Подсказка к заданию 7
Разные корутины, одновременно получающие списки участников для разных репозиториев, могут отправлять все полученные результаты в один и тот же канал:
val channel = Channel<List<User>>()
for (repo in repos) {
    launch {
        val users = TODO()
        // ...
        channel.send(users)
    }
}
Затем элементы из этого канала можно получать по одному и обрабатывать:
repeat(repos.size) {
    val users = channel.receive()
    // ...
}
Поскольку вызовы receive() выполняются последовательно, дополнительная синхронизация не требуется.
Решение задания 7
Как и для функции loadContributorsProgress(), можно создать переменную allUsers для хранения промежуточных состояний списка «все участники». Каждый новый список, полученный из канала, добавляется к списку всех пользователей. Результат агрегируется, а состояние обновляется с помощью обратного вызова updateResults:
suspend fun loadContributorsChannels(
    service: GitHubService,
    req: RequestData,
    updateResults: suspend (List<User>, completed: Boolean) -> Unit
) = coroutineScope {

    val repos = service
        .getOrgRepos(req.org)
        .also { logRepos(req, it) }
        .bodyList()

    val channel = Channel<List<User>>()
    for (repo in repos) {
        launch {
            val users = service.getRepoContributors(req.org, repo.name)
                .also { logUsers(repo, it) }
                .bodyList()
            channel.send(users)
        }
    }
    var allUsers = emptyList<User>()
    repeat(repos.size) {
        val users = channel.receive()
        allUsers = (allUsers + users).aggregate()
        updateResults(allUsers, it == repos.lastIndex)
    }
}
Результаты для разных репозиториев добавляются в канал, как только становятся доступны. Сначала, когда все запросы отправлены, а данные ещё не получены, вызов
receive()приостанавливается. В этом случае приостанавливается вся корутина «загрузки участников».Затем, когда список пользователей отправляется в канал, корутина «загрузки участников» возобновляется, вызов
receive()возвращает этот список, и результаты сразу же обновляются.
Теперь можно запустить программу и выбрать пункт КАНАЛЫ, чтобы загрузить участников и увидеть результат.
Хотя ни корутины, ни каналы не устраняют полностью сложности, связанные с параллельным выполнением, они упрощают понимание происходящего.
Тестирование корутин
Теперь протестируем все решения, чтобы убедиться, что решение с параллельными корутинами работает быстрее решения с функциями suspend, а решение с каналами — быстрее простого варианта с отображением «хода выполнения».
В следующем задании вы сравните общее время выполнения решений. Вы создадите имитацию сервиса GitHub, который будет возвращать результаты по истечении заданных интервалов времени:
repos request - returns an answer within 1000 ms delay
repo-1 - 1000 ms delay
repo-2 - 1200 ms delay
repo-3 - 800 ms delay
Последовательное решение с функциями suspend должно выполняться около 4000 мс (4000 = 1000 + (1000 + 1200 + 800)). Параллельное решение должно выполняться около 2200 мс (2200 = 1000 + max(1000, 1200, 800)).
Для решений, отображающих ход выполнения, можно также проверить промежуточные результаты с отметками времени.
Соответствующие тестовые данные определены в test/contributors/testData.kt, а файлы Request4SuspendKtTest, Request7ChannelsKtTest и так далее содержат простые тесты, использующие вызовы имитации сервиса.
Однако здесь есть две проблемы:
Эти тесты выполняются слишком долго. Каждый тест занимает около 2–4 секунд, и каждый раз приходится ждать результатов. Это не очень эффективно.
Нельзя полагаться на точное время выполнения решения, поскольку требуется дополнительное время на подготовку и выполнение кода. Можно добавить постоянную задержку, но тогда время будет отличаться на разных машинах. Задержки имитации сервиса должны быть больше этой постоянной, чтобы разница была заметна. Если постоянная задержка составляет 0,5 секунды, задержки в 0,1 секунды будет недостаточно.
Лучше было бы использовать специальные платформы для проверки времени выполнения одного и того же кода несколько раз (что ещё больше увеличивает общее время), но их изучение и настройка — сложная задача.
Чтобы решить эти проблемы и убедиться, что решения с заданными задержками ведут себя ожидаемым образом и одно работает быстрее другого, используйте виртуальное время со специальным диспетчером тестирования. Этот диспетчер отслеживает виртуальное время, прошедшее с момента запуска, и выполняет всё сразу в реальном времени. Когда вы запускаете корутины с этим диспетчером, вызов delay немедленно возвращает управление и продвигает виртуальное время.
Тесты с использованием этого механизма выполняются быстро, но при этом позволяют проверить, что происходит в разные моменты виртуального времени. Общее время выполнения значительно сокращается:
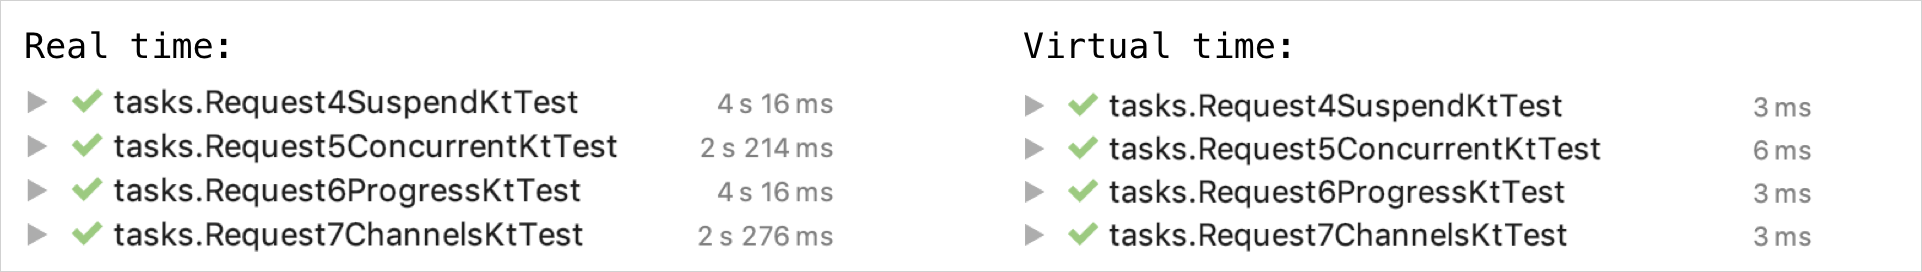
Чтобы использовать виртуальное время, замените вызов runBlocking на runTest. runTest принимает в качестве аргумента лямбду-расширение для TestScope. Если вызвать delay внутри функции suspend в этой специальной области видимости, delay увеличит виртуальное время вместо задержки в реальном времени:
@Test
fun testDelayInSuspend() = runTest {
    val realStartTime = System.currentTimeMillis()
    val virtualStartTime = currentTime

    foo()
    println("${System.currentTimeMillis() - realStartTime} ms") // ~ 6 ms
    println("${currentTime - virtualStartTime} ms")             // 1000 ms
}

suspend fun foo() {
    delay(1000)    // auto-advances without delay
    println("foo") // executes eagerly when foo() is called
}
Текущее виртуальное время можно проверить с помощью свойства currentTime у TestScope.
Фактическое время выполнения в этом примере составляет несколько миллисекунд, тогда как виртуальное время равно аргументу задержки — 1000 миллисекундам.
Чтобы виртуальное время delay полностью работало и во вложенных корутинах, запускайте все вложенные корутины с помощью TestDispatcher. Иначе это не сработает. Этот диспетчер автоматически наследуется от другого TestScope, если только вы не укажете другой диспетчер:
@Test
fun testDelayInLaunch() = runTest {
    val realStartTime = System.currentTimeMillis()
    val virtualStartTime = currentTime

    bar()

    println("${System.currentTimeMillis() - realStartTime} ms") // ~ 11 ms
    println("${currentTime - virtualStartTime} ms")             // 1000 ms
}

suspend fun bar() = coroutineScope {
    launch {
        delay(1000)    // auto-advances without delay
        println("bar") // executes eagerly when bar() is called
    }
}
Если в приведённом выше примере вызвать launch с контекстом Dispatchers.Default, тест завершится неудачно. Вы получите исключение с сообщением, что задание ещё не завершено.
Проверить функцию loadContributorsConcurrent() таким способом можно только в том случае, если она запускает вложенные корутины с унаследованным контекстом и не изменяет его с помощью диспетчера Dispatchers.Default.
Элементы контекста, например диспетчер, можно указывать при вызове функции, а не при её определении. Это обеспечивает большую гибкость и упрощает тестирование.
По умолчанию компилятор выводит предупреждения при использовании экспериментального API тестирования. Чтобы отключить эти предупреждения, добавьте аннотацию @OptIn(ExperimentalCoroutinesApi::class) к тестовой функции или ко всему классу, содержащему тесты. Добавьте аргумент компилятора, указывающий, что вы используете экспериментальный API:
compileTestKotlin {
    kotlinOptions {
        freeCompilerArgs += "-Xuse-experimental=kotlin.Experimental"
    }
}
В проекте, соответствующем этому руководству, аргумент компилятора уже добавлен в скрипт Gradle.
Задание 8
Перепишите следующие тесты в tests/tasks/ так, чтобы они использовали виртуальное время вместо реального:
Request4SuspendKtTest.ktRequest5ConcurrentKtTest.ktRequest6ProgressKtTest.ktRequest7ChannelsKtTest.kt
Сравните общее время выполнения до и после переработки.
Подсказка к заданию 8
-
Замените вызов
runBlockingнаrunTest, аSystem.currentTimeMillis()— наcurrentTime:@Test fun test() = runTest { val startTime = currentTime // action val totalTime = currentTime - startTime // testing result } Раскомментируйте проверки, которые проверяют точное виртуальное время.
Не забудьте добавить
@UseExperimental(ExperimentalCoroutinesApi::class).
Решение задания 8
Вот решения для вариантов с параллельным выполнением и каналами:
fun testConcurrent() = runTest {
    val startTime = currentTime
    val result = loadContributorsConcurrent(MockGithubService, testRequestData)
    Assert.assertEquals("Wrong result for 'loadContributorsConcurrent'", expectedConcurrentResults.users, result)
    val totalTime = currentTime - startTime

    Assert.assertEquals(
        "The calls run concurrently, so the total virtual time should be 2200 ms: " +
                "1000 for repos request plus max(1000, 1200, 800) = 1200 for concurrent contributors requests)",
        expectedConcurrentResults.timeFromStart, totalTime
    )
}
Сначала убедитесь, что результаты доступны точно в ожидаемый момент виртуального времени, а затем проверьте сами результаты:
fun testChannels() = runTest {
    val startTime = currentTime
    var index = 0
    loadContributorsChannels(MockGithubService, testRequestData) { users, _ ->
        val expected = concurrentProgressResults[index++]
        val time = currentTime - startTime
        Assert.assertEquals(
            "Expected intermediate results after ${expected.timeFromStart} ms:",
            expected.timeFromStart, time
        )
        Assert.assertEquals("Wrong intermediate results after $time:", expected.users, users)
    }
}
Первый промежуточный результат последнего варианта с каналами становится доступен раньше, чем в варианте с отображением хода выполнения; разницу можно увидеть в тестах с виртуальным временем.
Что дальше
Посетите мастер-класс «Асинхронное программирование на Kotlin» на KotlinConf.
Узнайте больше об использовании виртуального времени и экспериментального пакета для тестирования.
© 2010–2026 JetBrains s.r.o. and Kotlin Programming Language contributors
Licensed under the Apache License, Version 2.0.
https://kotlinlang.org/docs/coroutines-and-channels.html


