Агрегаторы
OpenTSDB был разработан для эффективного объединения нескольких различных временных рядов во время выполнения запроса. Но как объединить отдельные временные ряды в один ряд данных? Функции агрегирования обеспечивают способ математического объединения различных рядов данных в один, предоставляя вам выбор различных математических операций. Поскольку OpenTSDB не знает, вернёт ли запрос несколько временных рядов, функция агрегирования всегда требуется на всякий случай.
Агрегаторы имеют два способа работы:
Агрегирование
Поскольку OpenTSDB не знает, вернёт ли запрос несколько временных рядов, пока не просканирует все данные, функция агрегирования должна быть указана для каждого запроса на всякий случай. Когда обнаруживается более одного ряда, два ряда агрегируются вместе в один временной ряд. Для каждого временного отметки в различных временных рядах агрегатор выполнит вычисление для каждого значения в каждом временном ряду в этот момент времени. То есть, агрегатор будет работать по всем временным рядам в каждый момент времени. Следующая таблица иллюстрирует работу агрегатора sum по временным рядам A и B для получения ряда Output.
| ряд | ts0 | ts0+10с | ts0+20с | ts0+30с | ts0+40с | ts0+50с |
|---|---|---|---|---|---|---|
| A | 5 | 5 | 10 | 15 | 20 | 5 |
| B | 10 | 5 | 20 | 15 | 10 | 0 |
| Результат | 15 | 10 | 30 | 30 | 30 | 5 |
Для временной метки ts0 значения данных для A и B суммируются, то есть 5 + 10 == 15. Затем два значения для ts1 суммируются, чтобы получить 10 и так далее. Каждая функция агрегирования выполнит другую математическую операцию.
Интерполяция
В примере выше оба временных ряда A и B имели точки данных в каждый момент времени, они четко совпадали. Но что происходит, когда два ряда не совпадают? Сложно, и иногда нежелательно, синхронизировать все источники данных для записи в точное время. Например, если у нас есть 10 000 серверов, отправляющих 100 метрик системы каждые 5 минут, это будет всплеск 10 млн точек данных за секунду. Нам понадобится довольно мощная сеть и кластер для обработки такого трафика. Не говоря уже о том, что система будет простаивать в течение оставшихся 5 минут. Вместо этого гораздо разумнее распределить записи во времени, чтобы в среднем было 3333 записи в секунду, чтобы снизить требования к оборудованию и сети.
Как суммировать или найти среднее значение числа и чего-то, чего не существует? Один вариант — просто игнорировать точки данных для всех временных рядов в момент времени, где в любом ряду отсутствуют данные. Но если у вас два временных ряда, и они просто не совпадают, ваш запрос вернёт пустой набор данных, хотя в хранилище есть хорошие данные, поэтому это не очень полезно.
Другой вариант — определить скалярное значение (например, 0 или максимальное значение для Long), которое будет использоваться всякий раз, когда отсутствует точка данных. OpenTSDB 2.0 предоставляет несколько методов агрегирования, которые заменяют скалярное значение отсутствующими точками данных. Они полезны при работе с временными рядами с разными значениями, такими как количество продаж в определённое время.
Однако иногда нет смысла определять скаляр для отсутствующих данных. Часто вы можете записывать монотонно возрастающий счётчик, например, количество переданных байтов из сетевого интерфейса. В случае счётчика мы можем использовать интерполяцию, чтобы предположить, каким будет значение в этот момент времени. Интерполяция использует две точки и интервал времени между ними для вычисления оценки значения в запрошенную временную метку.
Посмотрите на эти два временных ряда, где данные просто смещены на 10 секунд:
| ряд | ts0 | ts0+10с | ts0+20с | ts0+30с | ts0+40с | ts0+50с | ts0+60с |
|---|---|---|---|---|---|---|---|
| A | na | 5 | na | 15 | na | 5 | na |
| B | 10 | na | 20 | na | 10 | na | 20 |
Когда OpenTSDB вычисляет агрегирование, он начинает с первой найденной точки данных для любого ряда, в данном случае это данные для B в ts0. Мы запрашиваем значение для A в ts0, но там нет данных. Мы знаем, что есть данные для A в ts0+10s, но поскольку у нас нет значения до этого, мы не можем предположить, каким оно было бы. Таким образом, мы просто возвращаем значение для B.
Далее мы встречаем значение для A в момент времени ts0+10s. Мы запрашиваем значение для ts0+10s из временного ряда B, но его нет. Но B знает, что есть значение в ts0+20s, и у нас было значение в ts0, поэтому мы теперь можем вычислить оценку для ts0+10s. Формула для линейной интерполяции — y = y0 + (y1 - y0) * ((x - x0) / (x1 - x0)), где для временного ряда B, y0 = 10, y1 = 20, x = ts0+10s (or 10), x0 = ts0 (or 0) и x1 = ts0+20s (or 20). Таким образом, у нас есть y = 10 + (20 - 10) * ((10 - 0) / (20 - 0), что упрощается до y = 10 + 10 * (10 / 20), далее до y = 10 + 10 * .5 и y = 10 + 5. Следовательно, B даст нам оценку значения 15 в ts0+10s.
Итерация продолжается для каждой временной метки, для которой найдена точка данных для каждого ряда, возвращенного как часть запроса. Результирующий ряд, используя агрегатор sum, будет выглядеть так:
| ряд | ts0 | ts0+10с | ts0+20с | ts0+30с | ts0+40с | ts0+50с | ts0+60с |
|---|---|---|---|---|---|---|---|
| A | na | 5 | na | 15 | na | 5 | na |
| B | 10 | na | 20 | na | 10 | na | 20 |
| Интерполированное A | na | 10 | 10 | ||||
| Интерполированное B | 15 | 15 | 15 | na | |||
| Суммированный результат | 10 | 20 | 30 | 25 | 20 | 20 | 20 |
Дополнительные примеры: Для тех, кто интересуется графиками, мы имеем следующие примеры. Вымышленная метрика с именем m регистрируется в OpenTSDB. «Сумма m» — синяя линия вверху, полученная из запроса типа start=1h-ago&m=sum:m. Она получена суммированием красной линии для host=foo и зелёной линии для host=bar:
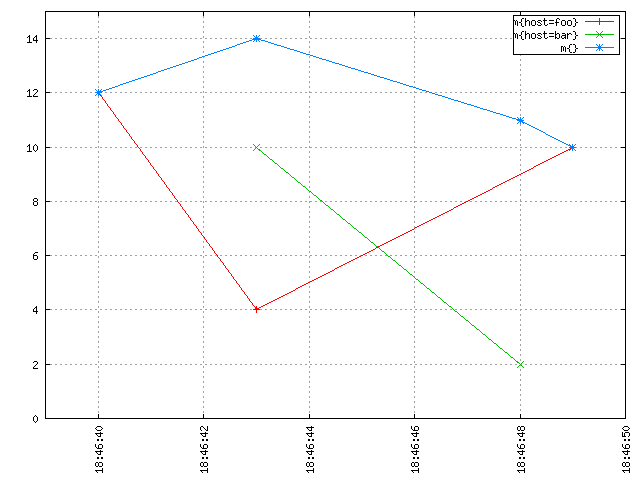
Из изображения выше интуитивно понятно, что если «сложить» красную и зелёную линии, получится синяя линия. В любой дискретной момент времени значение синей линии равно сумме значений красной и зелёной линий в этот момент времени. Без интерполяции вы получите что-то неинтуитивное, что труднее понять, и это также намного менее значимо и полезно:
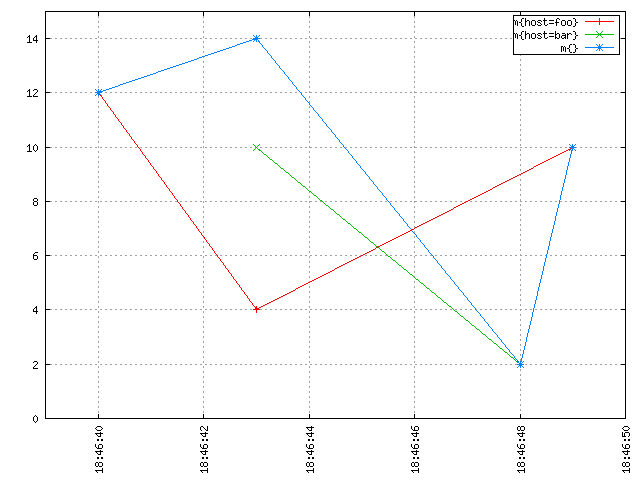
Обратите внимание, как синяя линия опускается до зелёной точки данных в 18:46:48. Не нужно быть математиком или иметь знания по высшей математике, чтобы увидеть, что интерполяция необходима для правильного агрегирования нескольких временных рядов и получения осмысленных результатов.
В настоящее время OpenTSDB в основном поддерживает линейную интерполяцию (иногда сокращенно «lerp»), а также некоторые агрегаторы, которые просто заменят нули или максимальное или минимальное значение. Заплаты приветствуются для тех, кто хочет добавить другие методы интерполяции.
Интерполяция выполняется только во время запроса, когда обнаруживается более одного временного ряда, соответствующего запросу. Многие системы сбора метрик интерполируют при записи, так что ваше исходное значение никогда не записывается. OpenTSDB сохраняет ваше исходное значение и позволяет извлечь его в любое время.
Вот ещё один немного более сложный пример, взятый с форума, иллюстрирующий, как несколько временных рядов агрегируются по среднему значению:

Толстая синяя линия с треугольниками представляет собой агрегирование с функцией avg нескольких временных рядов по запросу start=1h-ago&m=avg:duration_seconds. Как мы видим, результирующий временной ряд имеет одну точку данных в каждый момент времени всех подчинённых временных рядов, которые он агрегирует, и эта точка данных вычисляется путём взятия среднего арифметического значений всех временных рядов в этот момент времени. Это также верно для одиночной точки данных в фиолетовом временном ряду, который временно увеличил среднее значение до следующей точки данных.
Примечание
Функции агрегирования возвращают целочисленные или двойные значения на основе входных точек данных. Если оба исходных значения хранятся как целые числа, результаты вычислений будут целыми числами. Это означает, что любые дробные значения, полученные в результате вычисления, будут отброшены, округление не произойдёт. Если хотя бы одна из точек данных является числом с плавающей точкой, результат будет числом с плавающей точкой. Однако если включены операции по уменьшению выборки или скорости, результат всегда будет числом с плавающей точкой.
Уменьшение выборки
Вторым методом работы для агрегационных функций является downsampling. Поскольку OpenTSDB хранит данные с исходным разрешением неопределённо долго, запрос данных за длительный период может вернуть миллионы точек. Это может создать нагрузку на пропускную способность или графические библиотеки, поэтому часто запрашивают данные с меньшим разрешением для более длинных периодов. Сглаживание разбивает длинный период данных на меньшие периоды и объединяет данные для меньшего периода в одну точку данных. Агрегационные функции выполнят тот же расчёт, что и для процесса агрегации, но вместо работы со всеми точками данных для нескольких временных рядов в одной временной метке, сглаживание работает со многими точками данных в одном временном ряду в течение заданного временного периода.
Например, рассмотрим временные ряды A и B в первой таблице под Агрегация. Точки данных охватывают 50-секундный временной интервал. Предположим, что мы хотим сгладить его до 30 секунд. Это даст нам две точки данных для каждого временного ряда:
| временной ряд | ts0 | ts0+10с | ts0+20с | ts0+30с | ts0+40с | ts0+50с |
|---|---|---|---|---|---|---|
| A | 5 | 5 | 10 | 15 | 20 | 5 |
| A Сглаженный | 35 | 25 | ||||
| B | 10 | 5 | 20 | 15 | 10 | 0 |
| B Сглаженный | 50 | 10 | ||||
| Результат агрегации | 85 | 35 |
Для ранних версий OpenTSDB фактические временные метки новых точек данных будут средним значением временных меток каждой точки данных в временном интервале. Начиная с версии 2.1 и выше, временная метка каждой точки выравнивается с началом временного интервала в соответствии с остатком от деления текущего времени на интервал сглаживания.
Обратите внимание, что когда запрос задаёт функцию сглаживания и возвращается несколько временных рядов, сглаживание происходит перед агрегацией. То есть, теперь, когда у нас есть A Downsampled и B Downsampled, мы можем агрегировать два временных ряда, чтобы получить агрегированный результат в нижней строке.
Политики заполнения
С версии 2.2 вы можете указать политику заполнения при сглаживании для подстановки значений для использования в межвременных агрегациях, когда точки данных «пропущены». Поскольку OpenTSDB не накладывает ограничений на временное выравнивание или на то, когда значения должны существовать, такие ограничения должны быть указаны во время запроса. Во время сериализации, если все временные ряды пропускают значения для ожидаемой временной метки, ничего не передаётся. Например, если временной ряд записывает данные каждую минуту с T0 до T4, но по какой-то причине источник не записывает данные в T3, будет сериализовано только 4 значения, тогда как пользователь может ожидать 5. С политиками заполнения вы теперь можете выбрать, какое значение будет передано для T3.
При агрегировании нескольких временных рядов OpenTSDB обычно выполняет линейную интерполяцию, когда временной ряд пропускает значение в временной метке, присутствующей в одном или нескольких других временных рядах. Некоторые агрегаторы подставляют определённые значения, такие как нуль, минимальное или максимальное значение. С помощью политик заполнения вы можете изменить поведение агрегации, пометив пропущенное значение как NaN или скаляр, например, ноль. Когда для временного ряда передаётся NaN, он пропускается во всех расчётах. Например, если запрос требует среднего значения метрики, и один или несколько временных рядов пропускают значения, подстановка 0 снизит среднее значение, а интерполяция вводит несуществующие значения. Однако с NaN мы можем пометить значение как пропущенное и пропустить его в расчёте.
Доступные политики включают:
- None (
none) — стандартное поведение, которое не передаёт пропущенные значения во время сериализации и выполняет линейную интерполяцию (или другую указанную интерполяцию) при агрегировании временных рядов. - NaN (
nan) — передаётNaNв выходных данных сериализации, когда все значения отсутствуют в временном ряде. Пропускает временные ряды в агрегациях, когда значение отсутствует. - Null (
null) — такое же поведение, как NaN, за исключением того, что во время сериализации он передаётnullвместоNaN. - Zero (
zero) — подставляет ноль, когда временная метка отсутствует. Значение ноль будет включено в агрегированные результаты.
(Эти термины могут использоваться в спецификациях сглаживания, например, 1h-sum-nan)
Пример с политикой заполнения NaN и сглаживанием по 10 секундам:
| временной ряд | ts0 | ts0+10с | ts0+20с | ts0+30с | ts0+40с | ts0+50с | ts0+60с |
|---|---|---|---|---|---|---|---|
| A | na | na | na | 15 | na | 5 | na |
| B | 10 | na | 20 | na | na | na | 20 |
| Интерполированный A | NaN | NaN | NaN | NaN | NaN | ||
| Интерполированный B | NaN | NaN | NaN | NaN | |||
| Суммированный результат | 10 | NaN | 20 | 15 | NaN | 5 | 20 |
Доступные агрегаторы
Ниже приводится описание агрегационных функций, доступных в OpenTSDB.
| Агрегатор | Описание | Интерполяция |
|---|---|---|
| avg | Среднее значение точек данных | Линейная интерполяция |
| count | Количество исходных точек данных в наборе | Ноль при отсутствии данных |
| dev | Вычисляет стандартное отклонение | Линейная интерполяция |
| ep50r3 | Вычисляет оценённый 50-й перцентиль с методом R-3 * | Линейная интерполяция |
| ep50r7 | Вычисляет оценённый 50-й перцентиль с методом R-7 * | Линейная интерполяция |
| ep75r3 | Вычисляет оценённый 75-й перцентиль с методом R-3 * | Линейная интерполяция |
| ep75r7 | Вычисляет оценённый 75-й перцентиль с методом R-7 * | Линейная интерполяция |
| ep90r3 | Вычисляет оценённый 90-й перцентиль с методом R-3 * | Линейная интерполяция |
| ep90r7 | Вычисляет оценённый 90-й перцентиль с методом R-7 * | Линейная интерполяция |
| ep95r3 | Вычисляет оценённый 95-й перцентиль с методом R-3 * | Линейная интерполяция |
| ep95r7 | Вычисляет оценённый 95-й перцентиль с методом R-7 * | Линейная интерполяция |
| ep99r3 | Вычисляет оценённый 99-й перцентиль с методом R-3 * | Линейная интерполяция |
| ep99r7 | Вычисляет оценённый 99-й перцентиль с методом R-7 * | Линейная интерполяция |
| ep999r3 | Вычисляет оценённый 999-й перцентиль с методом R-3 * | Линейная интерполяция |
| ep999r7 | Вычисляет оценённый 999-й перцентиль с методом R-7 * | Линейная интерполяция |
| first | Возвращает первую точку данных в наборе. Полезно только для сглаживания, а не агрегации. (2.3) | Неопределённо |
| last | Возвращает последнюю точку данных в наборе. Полезно только для сглаживания, а не агрегации. (2.3) | Неопределённо |
| mimmin | Выбирает наименьшую точку данных | Максимум при отсутствии данных |
| mimmax | Выбирает наибольшую точку данных | Минимум при отсутствии данных |
| min | Выбирает наименьшую точку данных | Линейная интерполяция |
| max | Выбирает наибольшую точку данных | Линейная интерполяция |
| none | Пропускает агрегацию по группам всех временных рядов. (2.3) | Ноль при отсутствии данных |
| p50 | Вычисляет 50-й перцентиль | Линейная интерполяция |
| p75 | Вычисляет 75-й перцентиль | Линейная интерполяция |
| p90 | Вычисляет 90-й перцентиль | Линейная интерполяция |
| p95 | Вычисляет 95-й перцентиль | Линейная интерполяция |
| p99 | Вычисляет 99-й перцентиль | Линейная интерполяция |
| p999 | Вычисляет 999-й перцентиль | Линейная интерполяция |
| sum | Суммирует точки данных | Линейная интерполяция |
| zimsum | Суммирует точки данных | Ноль при отсутствии данных |
* Для расчёта перцентилей см. статью Википедии. Для расчётов с высокой степенью кардинальности использование оценённых перцентилей может быть более производительным.
Avg
Вычисляет среднее значение всех значений в течение временного интервала или по многим временным рядам. Эта функция выполнит линейную интерполяцию между временными рядами. Она полезна для анализа метрик датчиков. Обратите внимание, что даже если расчёт обычно даёт число с плавающей точкой, если данные записываются как целые числа, будет возвращено целое число, теряя некоторую точность.
Count
Возвращает количество точек данных, хранящихся в временном ряде или диапазоне. При агрегировании нескольких временных рядов значения нуля будут заменены. Лучше использовать эту функцию при сглаживании.
Dev
Вычисляет стандартное отклонение по интервалу или временным рядам. Данная функция выполняет линейную интерполяцию по временным рядам. Полезно для анализа метрик датчиков. Обратите внимание, что, хотя вычисление обычно приводит к значению с плавающей точкой, если данные точки записаны как целые числа, возвращается целое число, теряя некоторую точность.
Оценённые процентили
Вычисляет различные процентили, используя выбор алгоритмов. Эти значения полезны для рядов с большим количеством точек данных, так как некоторые данные могут быть исключены из расчётов. При агрегировании нескольких рядов функция выполняет линейную интерполяцию. Подробнее см. Википедию. Реализация осуществляется с помощью библиотеки Apache Math.
Первый и Последний
(2.3) Эти агрегаторы возвращают первую или последнюю точку данных в интервале усреднения. Например, если ведро усреднения содержит ряд 2, 6, 1, 7, то агрегатор first вернёт 1, а last вернёт 7. Обратите внимание, что этот агрегатор полезен только для усреднения. При использовании в качестве агрегатора группировки результаты неопределённы, так как порядок временных рядов, полученных из хранилища и находящихся в памяти, не является постоянным для разных TSD или запусков.
Макс
Обратная функция min, она возвращает наибольшую точку данных из всех временных рядов или в течение заданного временного интервала. Данная функция выполняет линейную интерполяцию по временным рядам. Полезно для анализа верхних границ метрик датчиков.
МинМакс
Функция «максимум при отсутствии минимума» возвращает только наименьшую точку данных из всех временных рядов или в течение заданного временного интервала. Эта функция не выполняет интерполяцию, вместо этого она возвращает максимальное значение для указанного типа данных, если значение отсутствует. Для целых чисел это будет Long.MaxValue, для чисел с плавающей точкой — Double.MaxValue. Подробнее см. Типы данных. Полезно для анализа нижних границ метрик датчиков.
МаксМин
Функция «минимум при отсутствии максимума» возвращает только наибольшую точку данных из всех временных рядов или в течение заданного временного интервала. Эта функция не выполняет интерполяцию, вместо этого она возвращает минимальное значение для указанного типа данных, если значение отсутствует. Для целых чисел это будет Long.MinValue, для чисел с плавающей точкой — Double.MinValue. Подробнее см. Типы данных. Полезно для анализа верхних границ метрик датчиков.
Мин
Возвращает только наименьшую точку данных из всех временных рядов или в течение заданного временного интервала. Данная функция выполняет линейную интерполяцию по временным рядам. Полезно для анализа нижних границ метрик датчиков.
Нет
(2.3) Пропускает агрегацию по группам. Этот агрегатор полезен для извлечения исходных данных из хранилища, так как он вернёт набор результатов для каждого временного ряда, соответствующего фильтрам. Обратите внимание, что запрос выдаст исключение, если используется с усреднением.
Процентили
Вычисляет различные процентили. При агрегировании нескольких рядов функция выполняет линейную интерполяцию. Реализация осуществляется с помощью библиотеки Apache Math.
Сумма
Вычисляет сумму всех точек данных из всех временных рядов или в течение заданного временного интервала при усреднении. Это функция агрегации по умолчанию для графического интерфейса, так как она часто наиболее полезна при объединении нескольких временных рядов, таких как датчики или счётчики. Она выполняет линейную интерполяцию, когда точки данных не совпадают. Если у вас есть отдельный ряд значений, которые вы хотите суммировать, и вам не нужна интерполяция, обратите внимание на zimsum
ZimСумма
Вычисляет сумму всех точек данных в указанный момент времени из всех временных рядов или в течение заданного временного интервала. Эта функция не выполняет интерполяцию, вместо этого она заменяет пропущенные точки данных 0. Это может быть полезно при работе с дискретными значениями.
© 2010–2016 The OpenTSDB Authors
Licensed under the GNU LGPLv2.1+ and GPLv3+ licenses.
http://opentsdb.net/docs/build/html/user_guide/query/aggregators.html


