Дополнительные параметры управления динамическим поведением
Создано: 22 сен 2025 | Последнее обновление: 03 дек 2025
PyTorch предоставляет несколько дополнительных параметров для управления динамическим поведением. Для использования этих параметров требуется глубокое понимание внутренних механизмов PyTorch, а также может потребоваться настройка дополнительных инструментов. К ним относятся:
- Оптимизация с профилированием (PGO) — метод, позволяющий компилятору сохранять автоматически принятые динамические решения и повторно использовать их в разных заданиях.
- Коллектив компилятора — функция, позволяющая изменять поведение автоматического определения динамических форм, выводя, является ли входной элемент динамическим, на основе того, различается ли его размер на разных рангах.
Оптимизация с профилированием (PGO)
Оптимизация с профилированием (PGO) расширяет возможности автоматического определения динамических форм, позволяя обмениваться решениями, полученными при профилировании, между запусками модели. В частности, она сериализует все решения, принятые при автоматическом определении динамических форм, в файл на диске. Затем этот файл можно скопировать или сохранить в централизованном сервисе метаданных, например S3, и повторно использовать на других машинах, чтобы обеспечить согласованное поведение в разных средах.
В рамках оставшейся части этого руководства для локального включения PGO можно использовать следующие переменные среды TORCH_COMPILE_JOB_ID=1 TORCH_DYNAMO_AUTOMATIC_DYNAMIC_LOCAL_PGO=1
Определение динамических элементов, помеченных PGO
Используйте tlparse, чтобы найти интересующие номера строк и проверить, наблюдались ли для входных данных несколько значений.
Чтобы определить, какие элементы помечены как динамические оптимизацией с профилированием (PGO), выполните следующие действия с помощью tlparse:
-
В выводе
tlparseнайдите номер строки интересующего кадра. Например:
-
Откройте
local_codeс помощьюput_local_code_state_илиput_remote_code_state_для последнего кадра (например, 6/1).Каждый
?указывает на то, что для этого входного элемента наблюдалось несколько значений.Например, следующий вывод показывает, что для входного элемента
L['m']вsize[0]наблюдались разные размеры, но шаг всегда был равен 1:/data/users/bobren/a/pytorch/r2.py:2:func: L['m']: fully dynamic scalar or tensor L['x']: tensor size=[?] stride=[1] L['y']: tensor size=[?] stride=[1] L['z']: tensor size=[?] stride=[1]
Примечание
Если элемент помечен PGO как динамический, это не гарантирует, что он останется динамическим в графе. Специализация может вернуть его в статическое состояние.
Коллектив компилятора
Разные ранги могут обмениваться данными о наблюдавшихся размерах. Во второй итерации автоматическое определение динамических форм использует эту информацию, чтобы определить, какие элементы следует пометить как динамические, основываясь на входных данных, наблюдавшихся на всех рангах. Подробности см. в этом PR. Чтобы включить эту функцию, используйте enable_compiler_collectives=True с декоратором @config.patch.
@config.patch(enable_compiler_collectives=True)
Примечание
Эта функция позволяет использовать коллективные операции во время компиляции для синхронизации поведения на разных рангах. В настоящее время она используется для изменения поведения автоматического определения динамических форм: функция определяет, является ли входной элемент динамическим, на основе того, различается ли его размер на разных рангах. Поскольку для синхронизации используются коллективные операции, все ранги должны выполнять компиляцию одновременно; ранги не должны расходиться из-за разрывов графа. Надёжнее всего обеспечить это, запуская torch только в программах SPMD. Нарушение этого условия может привести к взаимной блокировке NCCL и превышению времени ожидания NCCL.
Сокращение числа компиляций: пошаговое руководство
Если ваша модель запускается в основном задании и у вас есть tlparse, выполните следующие действия:
Шаг 1. Пометьте динамические элементы
Первый шаг — сократить число начальных компиляций, результаты которых впоследствии оптимизируются автоматическим определением динамических форм или PGO. Это несложно, поскольку заранее известно, что такой подход сработает. Если при одном запуске кадр начинается со статических графов и сходится к динамическим, а при втором (прогретом) запуске с включённым PGO вы замечаете сокращение числа скомпилированных кадров, это, вероятно, результат данной оптимизации.
Этот процесс состоит из двух шагов:
- Найдите элементы, помеченные как динамические с помощью PGO или автоматического определения динамических форм.
- Пометьте их как динамические с помощью одной из пользовательских аннотаций.
Как определить элементы, которые нужно пометить как динамические
Следуйте этим рекомендациям:
- Артефакт PGO: Выполните действия из раздела Определение динамических элементов, помеченных PGO.
-
Динамические журналы: Если у вас есть запуск с
TORCH_LOGS="+dynamic", при каждом выделении нового динамического измерения в строке отладки будут указаны это измерение и имя входного элемента. - Сравнение графов: Для кадров, число компиляций которых сократилось между запусками, изучите графы Dynamo во втором запуске или в последних запусках холодного запуска. Найдите элементы, помеченные в этих графах как динамические. В частности, найдите похожие графы (один специализированный, другой динамический).
Даже без прогретого запуска можно проверить все графы для конкретного кадра и определить, похожи ли некоторые из них и сходятся ли они к динамической версии.
Например, на следующем снимке tlparse графы Dynamo 20/0, 20/1 и 20/2 похожи, но имеют разные размеры (например, граф 20/0 отличается от графа 20/2). В графе Dynamo 20/2 для rotary_pos_emb_ и x используются размеры s0, s1 и s5.

Совет
Два графа считаются похожими, если в них совпадают последовательность вызовов операций torch и входные тензоры. Могут различаться целочисленные входные данные, которые в специализированной версии могли быть встроены в код, а также арифметические вычисления, присутствующие только в динамической версии из-за встраивания в статической версии.
Шаг 2. Отладка: поиск упущенных возможностей
Сложность отладки может сильно различаться в зависимости от возникающих проблем. В итоге часто требуется найти ошибку, включить флаг или изменить пользовательский код либо код фреймворка.
Поиск похожих графов
Сначала найдите группу похожих графов, которые можно объединить в один динамический граф, как обсуждалось в предыдущем разделе о сравнении графов. Если похожих графов найти не удалось, на этом шаге больше ничего делать не нужно.
Быстрые проверки: раннее выявление проблем
После нахождения похожих графов нужно выяснить, почему для них выполняется повторная компиляция. Проверьте следующее:
-
Проверьте причины повторной компиляции: Для графов, которые вы считаете похожими, нажмите
recompile_reasonв выводеtlparseдля более позднего графа. Убедитесь, что причина связана с размером, а не с другими факторами. Например, на этих снимках причина повторной компиляции связана с размером:

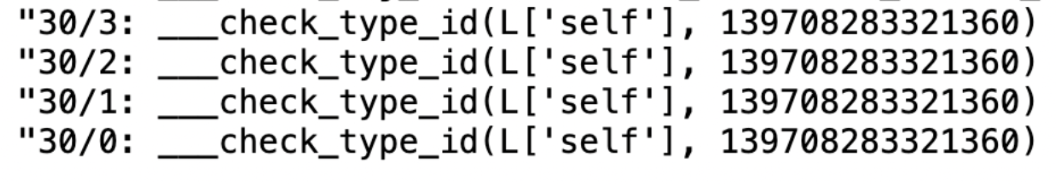
На снимке ниже причина не связана с размером, а значит, динамические формы эту проблему не устранят:
- Сравните файлы guards: Убедитесь, что в одном графе нет проверок для элементов, не связанных с размером, которые отсутствуют в остальных графах.
-
Заранее проверьте пользовательские ядра Triton: Проверьте, вызывает ли ваша модель пользовательские ядра Triton с аргументами
tl.constexpr, поскольку такие аргументы всегда специализируются. Если модель получает разные значения для этих аргументов, это может приводить к повторной компиляции.
Определение причин повторной компиляции и их устранение
-
Элемент не помечен как динамический, хотя должен быть? Определите, был ли входной элемент помечен как динамический, а затем специализирован, или его вовсе не помечали как динамический. Это можно выяснить следующим образом:
-
Проверьте граф Dynamo — найдите
Sym(number). Например:Sym(256) vs Sym(s0)
-
Используйте журналы динамических форм:
["TORCH_LOGS=+dynamic"]
create_symbol s2 = 2 for L['self']._modules['cle ...
-
Проверьте файлы guards. Если размер тензора динамический, это будет обозначено как
None:TENSOR_MATCH:check_tensor(L['self'].x._parameters['weight']], Parameter, DispatchKeySet(CPU, BackendSelect, ADInplaceOrView, AutogradCPU), torch.float32, device=None, requires_grad=True, size=[None, None], stride=[None, 1])
-
-
Почему элемент не помечен как динамический? Если вы выяснили, что элемент не помечен как динамический, проверьте следующее:
-
Убедитесь, что это не свойство, параметр или поле модуля
nn. Проверьте настройки флагов:force_parameter_static_shapes = Trueforce_nn_module_property_static_shapes = Trueallow_unspec_int_on_nn_module = False- Или используйте список разрешённых динамических элементов, чтобы пометить его как динамический. Такой способ имеет наивысший приоритет.
Совет
Помечать элементы по одному может быть долго. Для начала переключите флаги, чтобы выявить блокирующие специализации, а в конце процесса решите, как помечать элементы как динамические.
- Если вам кажется, что это может быть ошибка, отправьте отчёт об ошибке и добавьте метку
module: dynamic shapes. Список известных проблем см. в этом списке.
-
-
Специализируется ли динамический элемент? Определите причину специализации. Она может быть связана с пользовательским кодом (например, с условием
if), кодом фреймворка или вызовом ядра Triton. Чтобы выяснить причину специализации:-
Используйте tlparse: Найдите в
compilation_metricsраздел специализации. В нём указано, что именно было специализировано, а также стеки вызовов пользователя и фреймворка на момент специализации. Пример:

В приведённом выше журнале показано, что
s0специализирован до33из-за следующего кода:`if self.x ==33` at example4.py line 16.
-
Используйте динамические журналы: передайте
["TORCH_LOGS=+dynamic"]. Найдите первую специализацию: после специализации переменной специализируются и все зависимые от неё переменные.
Пример записи журнала:
torch/fx/experimental/symbolic_shapes.py:6557] [0/2] eval Eq(s0, 33) [guard added] if self.x ==33:  # example4.py:16 in forward (_dynamo/variables/tensor.py:1242 in evaluate_expr), for more info run with TORCHDYNAMO_EXTENDED_DEBUG_GUARD_ADDED="Eq(s0, 33)"
V0228 12:04:24.190000 2990033 torch/fx/experimental/symbolic_shapes.py:6000] [0/2] _update_var_to_range s0 = VR[33, 33] (update)
В приведённом выше журнале показано, что
s0специализирован до33из-за следующего кода:if self.x ==33. At example4.py like 16.
-
Используйте tlparse: Найдите в
© 2026, PyTorch Contributors
PyTorch has a BSD-style license, as found in the LICENSE file.
https://docs.pytorch.org/docs/2.14/user_guide/torch_compiler/compile/dynamic_shapes_advanced_control_options.html


