Вглубь TorchDynamo
Прежде чем читать этот раздел, прочитайте torch.compiler.
TorchDynamo — это компилятор Just-In-Time (JIT) на уровне Python, предназначенный для ускорения неулучшенных программ PyTorch. TorchDynamo подключается к API оценки фреймов в CPython (PEP 523), чтобы динамически изменять байткод Python непосредственно перед его выполнением. Он переписывает байткод Python, чтобы извлечь последовательности операций PyTorch в граф FX, который затем компилируется с настраиваемым бэкендом. Он создает этот граф FX с помощью анализа байткода и разработан для смешивания выполнения Python с компилированными бэкендами, чтобы получить лучшее из обоих миров — удобство использования и производительность.
TorchDynamo упрощает эксперименты с различными бэкендами компилятора для ускорения кода PyTorch всего одной строкой декоратора torch._dynamo.optimize() , которая для удобства обернута в torch.compile()
Следующая диаграмма демонстрирует, как PyTorch работает с torch.compile и без него:
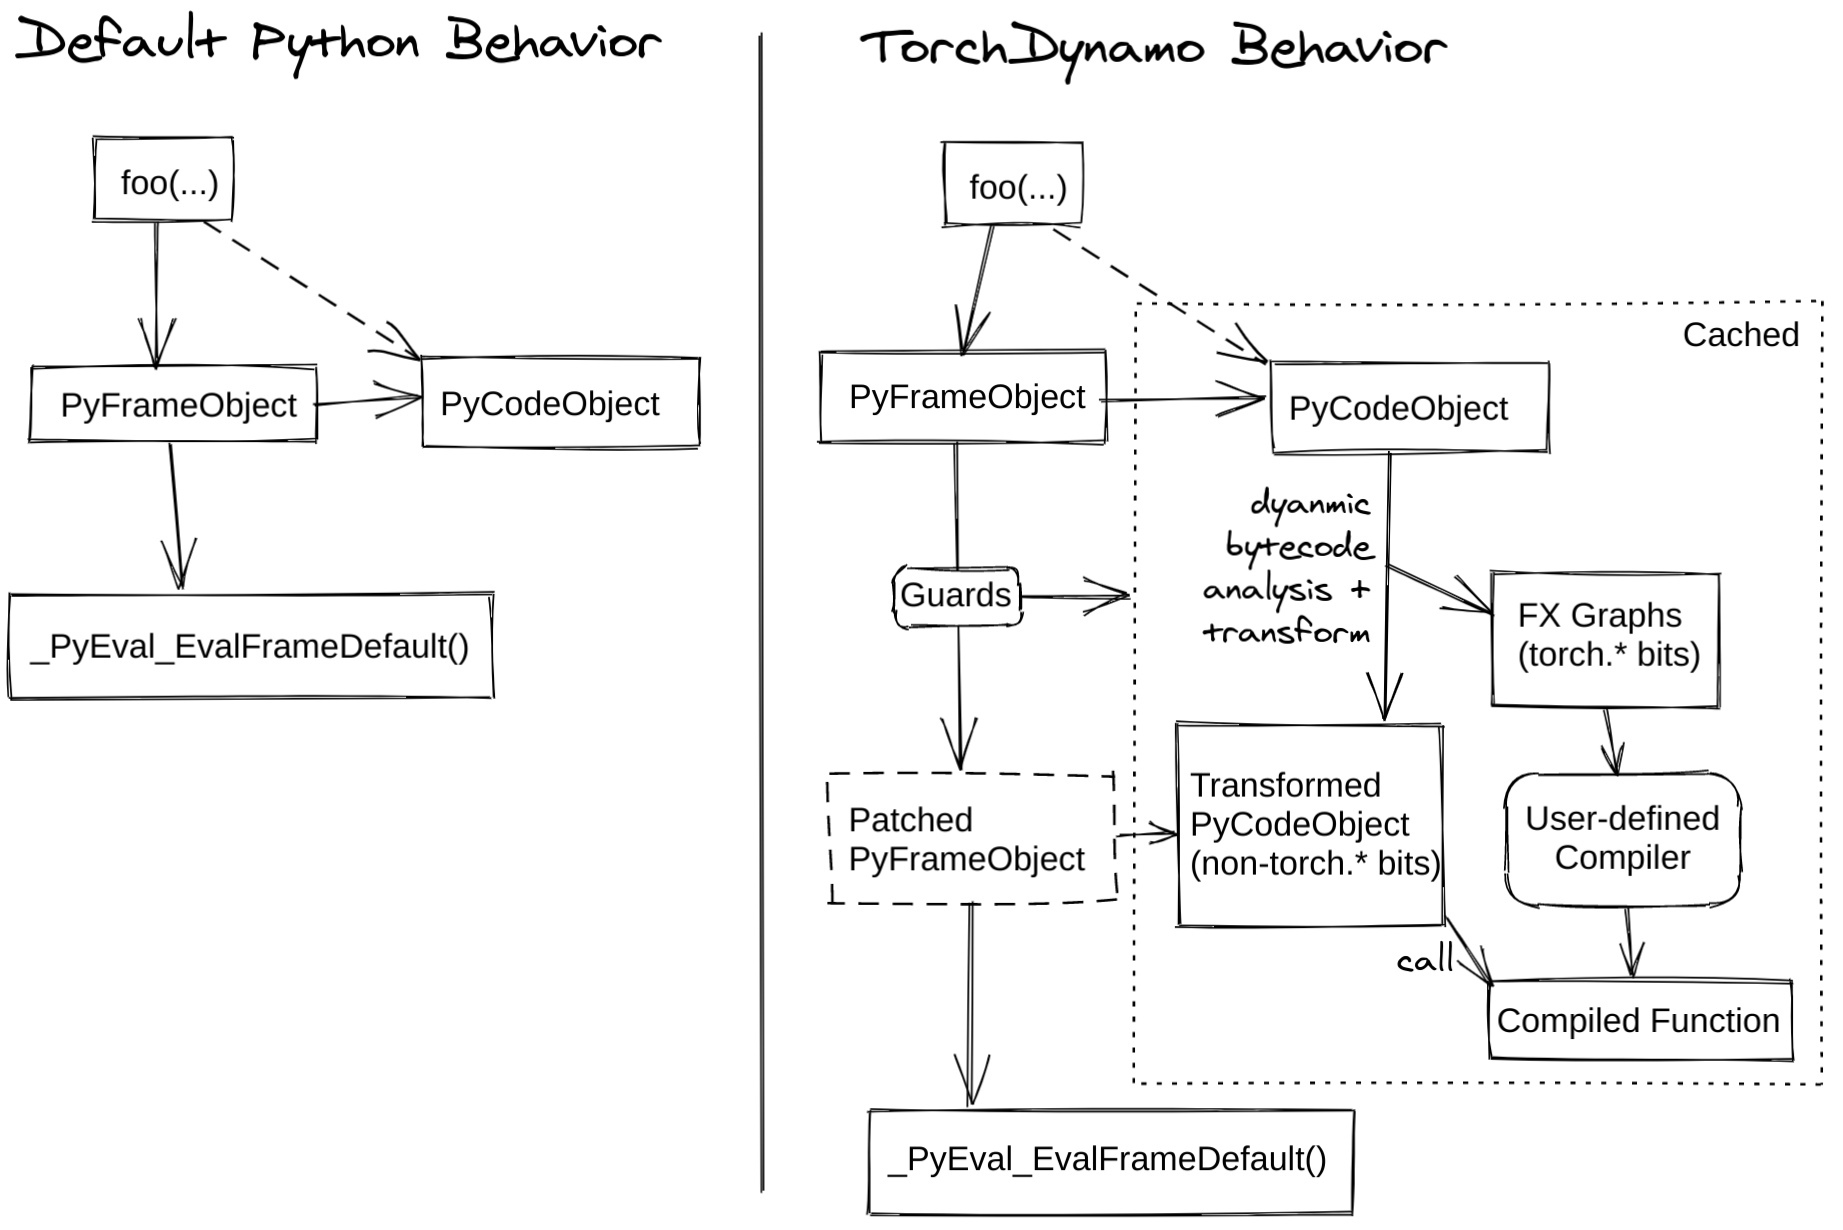
TorchInductor — один из бэкендов, поддерживаемых графом TorchDynamo, в Triton для GPU или C++/OpenMP для CPU. У нас есть панель мониторинга производительности обучения, которая предоставляет сравнение производительности для различных бэкендов обучения. Подробнее можно узнать в посте TorchInductor на PyTorch dev-discuss.
Для глубокого обзора прочитайте разделы ниже, посмотрите видео вглубь темы и ознакомьтесь с темами dev-discuss.
Внутреннее устройство TorchDynamo
Автор: Jason Ansel и Kaichao You
В этом разделе мы рассмотрим некоторые внутренние механизмы TorchDynamo и продемонстрируем, как TorchDynamo работает внутри.
Что такое страж?
TorchDynamo работает в режиме реального времени и специализирует графики на основе динамических свойств. Ниже приведен базовый пример использования TorchDynamo. Можно декорировать функцию или метод с помощью torchdynamo.optimize для включения оптимизации TorchDynamo:
from typing import List
import torch
from torch import _dynamo as torchdynamo
def my_compiler(gm: torch.fx.GraphModule, example_inputs: List[torch.Tensor]):
    print("my_compiler() called with FX graph:")
    gm.graph.print_tabular()
    return gm.forward  # return a python callable

@torchdynamo.optimize(my_compiler)
def toy_example(a, b):
    x = a / (torch.abs(a) + 1)
    if b.sum() < 0:
        b = b * -1
    return x * b
for _ in range(100):
    toy_example(torch.randn(10), torch.randn(10))
Например, на первом графике выше есть следующие стражи:
GUARDS:
 - local 'a' TENSOR_MATCH
 - local 'b' TENSOR_MATCH
 - global 'torch' FUNCTION_MATCH
Если любой из этих стражей терпит неудачу, граф будет перезахвачен и перекомпилирован. Интересный тип стража там — TENSOR_MATCH, который проверяет следующие torch.Tensor свойства:
- Класс Python тензора (наследование тензора и т. д.)
- тип
- устройство
- requires_grad
- dispatch_key (с применёнными thread-local включениями/исключениями)
- ndim
- sizes*
- strides*
Полный режим специализации позволяет компилятору бэкенда предположить полностью статический граф. К сожалению, большинство бэкендов требуют этого. Операторы, возвращающие динамические формы, вызовут разрыв графа, если не установлен динамический режим формы.
Что делает Dynamo?
Если вы хотите лучше понять, что делает TorchDynamo, вы можете установить:
import torch._dynamo.config
import logging

torch._dynamo.config.log_level = logging.INFO
torch._dynamo.config.output_code = True
Этот код запускает полезные (но надоедливые) выводы.
Например, выводы для первого графика в toy_example такие:
__compiled_fn_0 <eval_with_key>.1
opcode         name     target                                                  args              kwargs
-------------  -------  ------------------------------------------------------  ----------------  --------
placeholder    a        a                                                       ()                {}
placeholder    b        b                                                       ()                {}
call_function  abs_1    <built-in method abs of type object at 0x7f9ca082f8a0>  (a,)              {}
call_function  add      <built-in function add>                                 (abs_1, 1)        {}
call_function  truediv  <built-in function truediv>                             (a, add)          {}
call_method    sum_1    sum                                                     (b,)              {}
call_function  lt       <built-in function lt>                                  (sum_1, 0)        {}
output         output   output                                                  ((truediv, lt),)  {}

ORIGINAL BYTECODE toy_example example.py 9
 10           0 LOAD_FAST                0 (a)
              2 LOAD_GLOBAL              0 (torch)
              4 LOAD_METHOD              1 (abs)
              6 LOAD_FAST                0 (a)
              8 CALL_METHOD              1
             10 LOAD_CONST               1 (1)
             12 BINARY_ADD
             14 BINARY_TRUE_DIVIDE
             16 STORE_FAST               2 (x)

 11          18 LOAD_FAST                1 (b)
             20 LOAD_METHOD              2 (sum)
             22 CALL_METHOD              0
             24 LOAD_CONST               2 (0)
             26 COMPARE_OP               0 (<)
             28 POP_JUMP_IF_FALSE       38

 12          30 LOAD_FAST                1 (b)
             32 LOAD_CONST               3 (-1)
             34 BINARY_MULTIPLY
             36 STORE_FAST               1 (b)

 13     >>   38 LOAD_FAST                2 (x)
             40 LOAD_FAST                1 (b)
             42 BINARY_MULTIPLY
             44 RETURN_VALUE

MODIFIED BYTECODE
  9           0 LOAD_GLOBAL              3 (__compiled_fn_0)
              2 LOAD_FAST                0 (a)
              4 LOAD_FAST                1 (b)
              6 CALL_FUNCTION            2
              8 UNPACK_SEQUENCE          2
             10 STORE_FAST               2 (x)
             12 POP_JUMP_IF_FALSE       24
             14 LOAD_GLOBAL              4 (__resume_at_30_1)
             16 LOAD_FAST                1 (b)
             18 LOAD_FAST                2 (x)
             20 CALL_FUNCTION            2
             22 RETURN_VALUE
        >>   24 LOAD_GLOBAL              5 (__resume_at_38_2)
             26 LOAD_FAST                1 (b)
             28 LOAD_FAST                2 (x)
             30 CALL_FUNCTION            2
             32 RETURN_VALUE

GUARDS:
 - local 'a' TENSOR_MATCH
 - local 'b' TENSOR_MATCH
 - global 'torch' FUNCTION_MATCH
Вверху вы видите граф FX. Далее следует исходный байткод функции, за которым следует изменённый байткод, сгенерированный TorchDynamo. И, наконец, стражи, о которых мы говорили выше.
В изменённом байткоде __compiled_fn_0 — это возвращаемое значение my_compiler() (скомпилированного графа). __resume_at_30_1 и __resume_at_38_2 — это сгенерированные функции продолжения, которые возобновляют выполнение после разрыва графа (в смещениях байткода 30 и 38). Каждая из этих функций имеет вид:
__resume_at_<offset>:
    ... restore stack state if needed ...
    JUMP_ABSOLUTE <offset> into toy_example
    ... original bytecode of toy_example ...
Создавая эту resume_at функцию, мы заставляем оставшуюся часть функции выполняться в новом фрейме Python, что рекурсивно запускает TorchDynamo для перезапуска захвата, как только выполнение достигнет этой точки в первый раз.
Как инспектировать артефакты, сгенерированные TorchDynamo?
Для инспекции артефактов, сгенерированных TorchDynamo, есть API torch._dynamo.eval_frame._debug_get_cache_entry_list , который извлекает скомпилированный код и стражи из объекта __code__ функции. У скомпилированной функции может быть несколько записей кеша, и каждая запись кеша состоит из сгенерированной функции для проверки стражей и объекта types.CodeType для хранения кода, который будет выполнен, если условия стража выполнены.
from torch._dynamo.eval_frame import _debug_get_cache_entry_list
cache_entries = _debug_get_cache_entry_list(toy_example._torchdynamo_orig_callable.__code__)
guard, code = cache_entries[0]
# the guard takes an input frame, and tells whether a re-compilation should be triggered.
import inspect
print(inspect.getfullargspec(guard))
# if you know python bytecode, you can understand the following code.
import dis
dis.dis(guard)
dis.dis(code)
Скомпилированный байткод, напечатанный dis.dis(code), вызовет результат функции компилятора бэкенда, которая хранится в глобальной переменной, такой как __compiled_fn_0 в модуле, содержащем исходную функцию.
Сгенерированные байткоды примерно эквивалентны следующему Python (преобразованному вручную для целей иллюстрации).
def compiled_example(a, b):
    # behind the scene, pytorch C code checks the guarding condition
    # if all guard fails, trigger re-compile
    # else, run the compiled code
    # after some setup work, the code finally looks like the following
    x, b_sum_less_than_0 = __compiled_fn_0._torchdynamo_orig_callable(a, b)
    # the condition test on tensor value leads to graph break here
    # we use python interpreter to select the branch
    # depending on the value, the rest graph is either `__resume_at_30_1`
    # or `__resume_at_38_2`
    if b_sum_less_than_0:
        return __resume_at_30_1(b, x)
     return __resume_at_38_2(b, x)

def __resume_at_38_2(b, x):
    return x * b

def __resume_at_30_1(b, x):
    b = b * -1
    return x * b

def fn(a, b):
    x = a / (torch.abs(a) + 1)
    lt = b.sum() < 0
    return x, lt

__compiled_fn_0._torchdynamo_orig_callable = fn
Обратите внимание, что мы передаём простую my_compiler функцию как компилятор бэкенда, поэтому код подграфа __resume_at_38_2, __resume_at_30_1, и __compiled_fn_0._torchdynamo_orig_callable остаётся кодом Python. Однако, если мы используем другие бэкенды, такие как встроенный inductor, код подграфа будет скомпилирован в ядра CUDA для GPU или код C++ для CPU.
© 2024, PyTorch Contributors
PyTorch has a BSD-style license, as found in the LICENSE file.
https://pytorch.org/docs/2.1/torch.compiler_deepdive.html


