Профилирование для понимания производительности torch.compile
Для чего используется torch.profiler:
torch.profiler полезен для понимания производительности вашей программы на уровне ядер — например, он может показывать разрывы графа и использование GPU на уровне программы. Данные, предоставляемые профилировщиком, часто помогают пользователям понять, где стоит углубиться в исследование для понимания производительности модели.
Для понимания производительности на уровне ядер существуют и другие инструменты. Инструмент ncu от NVIDIA или инструменты профилирования индуктора можно использовать для индуктора.
См. также общее руководство по профилировщику PyTorch .
Основы использования torch.profiler и просмотра трассировок
Пример программы: Мы воспользуемся этим примером для профилирования resnet18. Обратите внимание на следующие части этой примерной программы:
- Включение предварительного прогона для ожидания завершения компиляции (это разогреет системы, такие как кэширующий аллокатор CUDA)
- Использование контекста
torch.profiler.profile()для профилирования интересующего нас раздела - Использование
prof.export_chrome_trace("trace.json")для экспорта профилируемого артефакта.
import torch
from torchvision.models import resnet18

model = resnet18().cuda()
inputs = [torch.randn((5, 3, 224, 224), device='cuda') for _ in range(10)]

model_c = torch.compile(model)

def fwd_bwd(inp):
    out = model_c(inp)
    out.sum().backward()

# warm up
fwd_bwd(inputs[0])

with torch.profiler.profile() as prof:
    for i in range(1, 4):
        fwd_bwd(inputs[i])
        prof.step()

prof.export_chrome_trace("trace.json")
Просмотр трассировок Chrome: В браузере Chrome откройте chrome://tracing и загрузите файл json. Используйте клавиши «w» и «s» для приближения и отдаления, а «a» и «d» — для перемещения влево и вправо. «?» отобразит страницу справки со списком горячих клавиш.
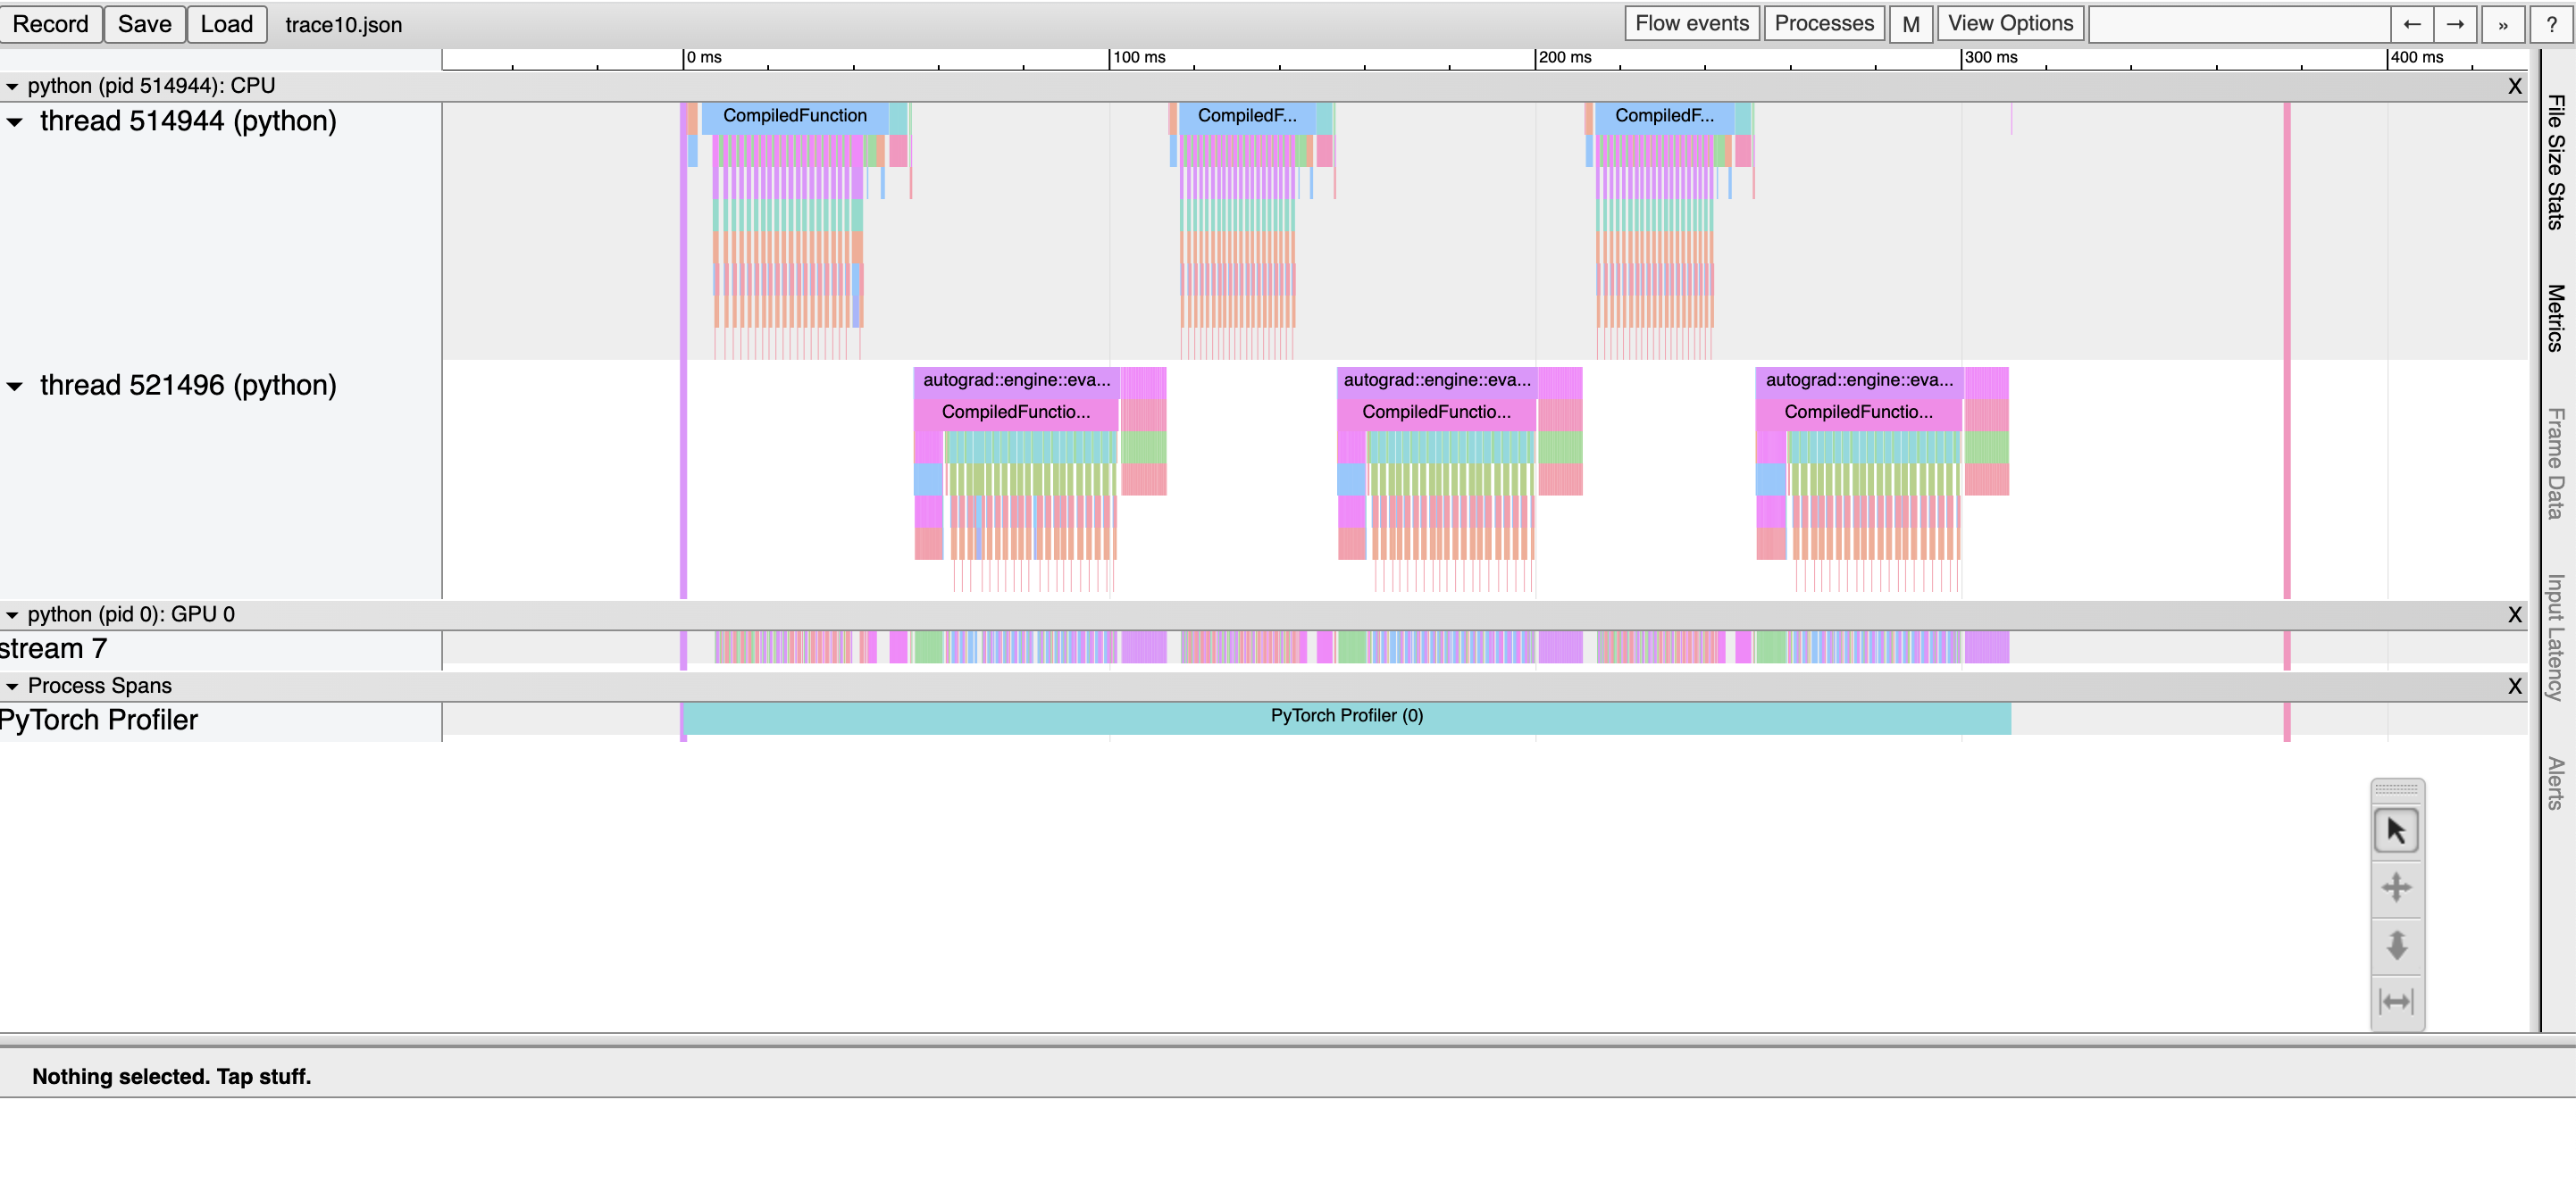
Здесь мы наблюдаем: * события CompiledFunction и CompiledFunctionBackward, которые соответствуют областям, скомпилированным dynamo. * События CPU в верхней части и события GPU в нижней.
Потоки между событиями CPU и GPU
Каждое ядро на GPU выполняется после запуска кодом, выполняющимся на CPU. Профилировщик может отображать соединения (т. е. «потоки») между событиями GPU и CPU, чтобы показать, какое событие CPU запустило ядро GPU. Это особенно полезно, потому что, за исключением нескольких случаев, ядра GPU запускаются асинхронно.
Чтобы просмотреть соединение потока, щелкните по ядру GPU и нажмите «ac2g»:
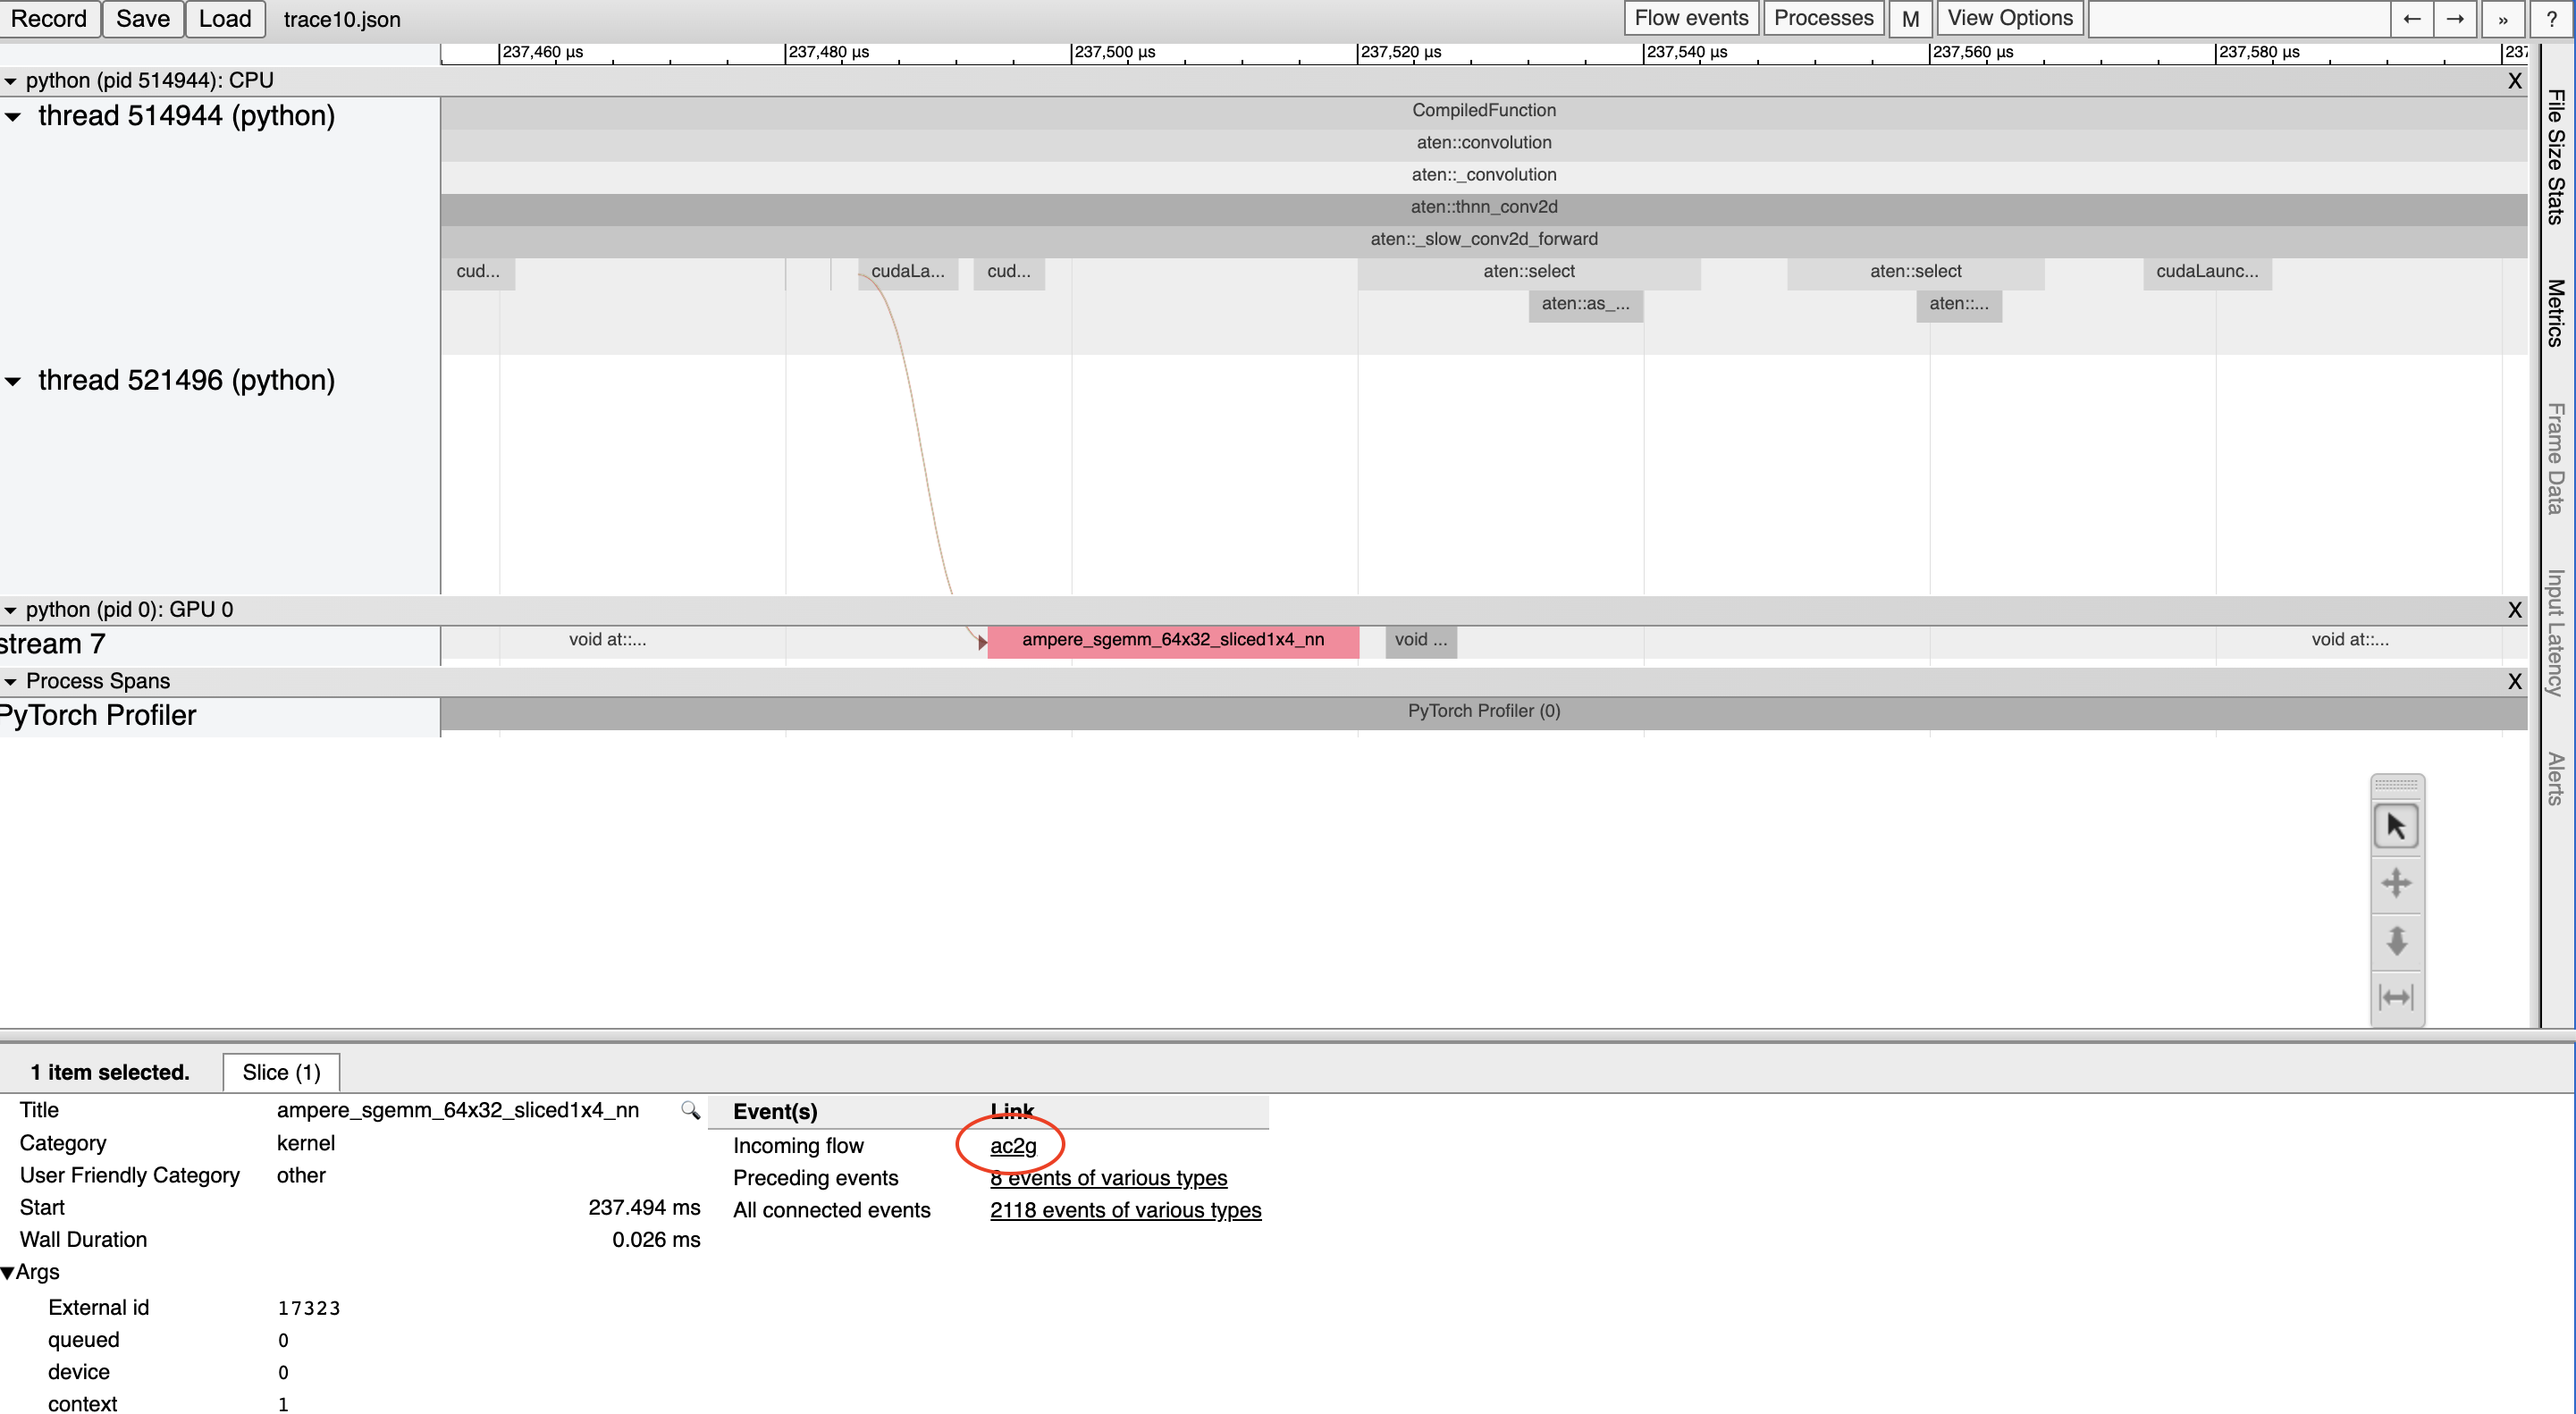
В качестве альтернативы, включите все потоки, используя раскрывающийся список «События потоков» вверху.
Работа с проблемами профилирования CUDA Graph
При включении CUDA графиков некоторые конфигурации CUDA (версия драйвера ниже 525.85.12 или CUDA < 12) могут столкнуться с проблемами между инструментами профилирования и CUDA графами. Для решения этих проблем добавьте пустой контекст профилирования в верхней части вашей программы:
import torch

torch.profiler._utils._init_for_cuda_graphs()

# ... rest of program
Понимание времени компиляции
Чтобы понять, почему компиляция занимает много времени, вы можете профилировать первый вызов программы, скомпилированной с помощью torch.compile. Имейте в виду, что трассировки профиля компиляций могут быть искажены сильнее, чем типичные трассировки профиля, потому что рабочие нагрузки компиляции могут существенно отличаться от типичных рабочих нагрузок PyTorch. В некоторых случаях файлы трассировки также могут быть довольно большими. Трассировки > 1 ГБ могут быть трудно открыть с помощью инструмента трассировки Chrome.
Примечание: примерно ту же информацию можно получить и в неграфическом формате с помощью torch._dynamo.utils.compile_times(). Этот инструмент не покажет, когда происходят шаги компиляции, но покажет время, потраченное на каждый шаг — и эти времена не будут затронуты никакой нагрузкой профилирования.
Пример ниже:
import torch
from torchvision.models import resnet18

model = resnet18().cuda()
inputs = [torch.randn((5, 3, 224, 224), device='cuda') for _ in range(10)]

model_c = torch.compile(model)

def fwd_bwd(inp):
    out = model_c(inp)
    out.sum().backward()

def warmup_compile():
    def fn(x):
        return x.sin().relu()

    x = torch.rand((2, 2), device='cuda', requires_grad=True)
    fn_c = torch.compile(fn)
    out = fn_c(x)
    out.sum().backward()

with torch.profiler.profile() as prof:
    with torch.profiler.record_function("warmup compile"):
        warmup_compile()

    with torch.profiler.record_function("resnet18 compile"):
        fwd_bwd(inputs[0])

prof.export_chrome_trace("trace_compile.json")
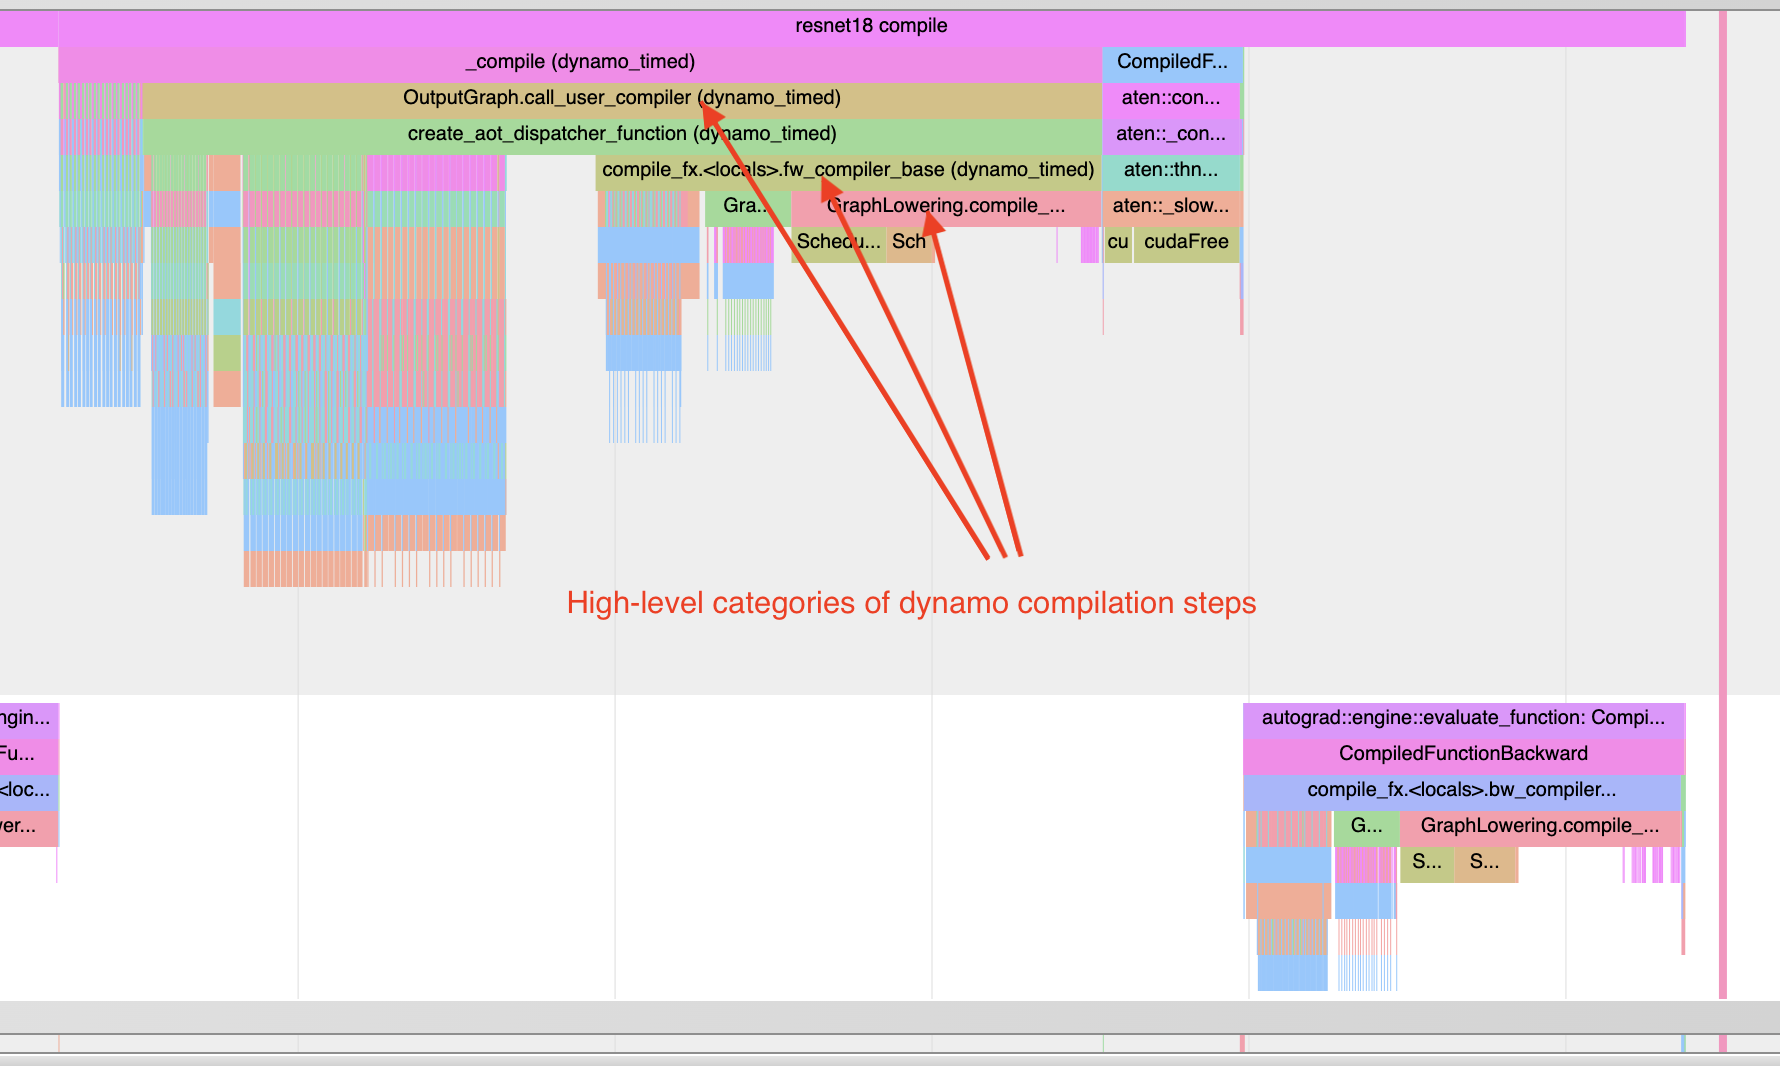
Обратите внимание на несколько моментов:
- Первый вызов должен происходить во время профилирования, чтобы захватить компиляцию
- Добавьте предварительную компиляцию для инициализации систем, которые нужно инициализировать лениво.
Поиск разрывов графа
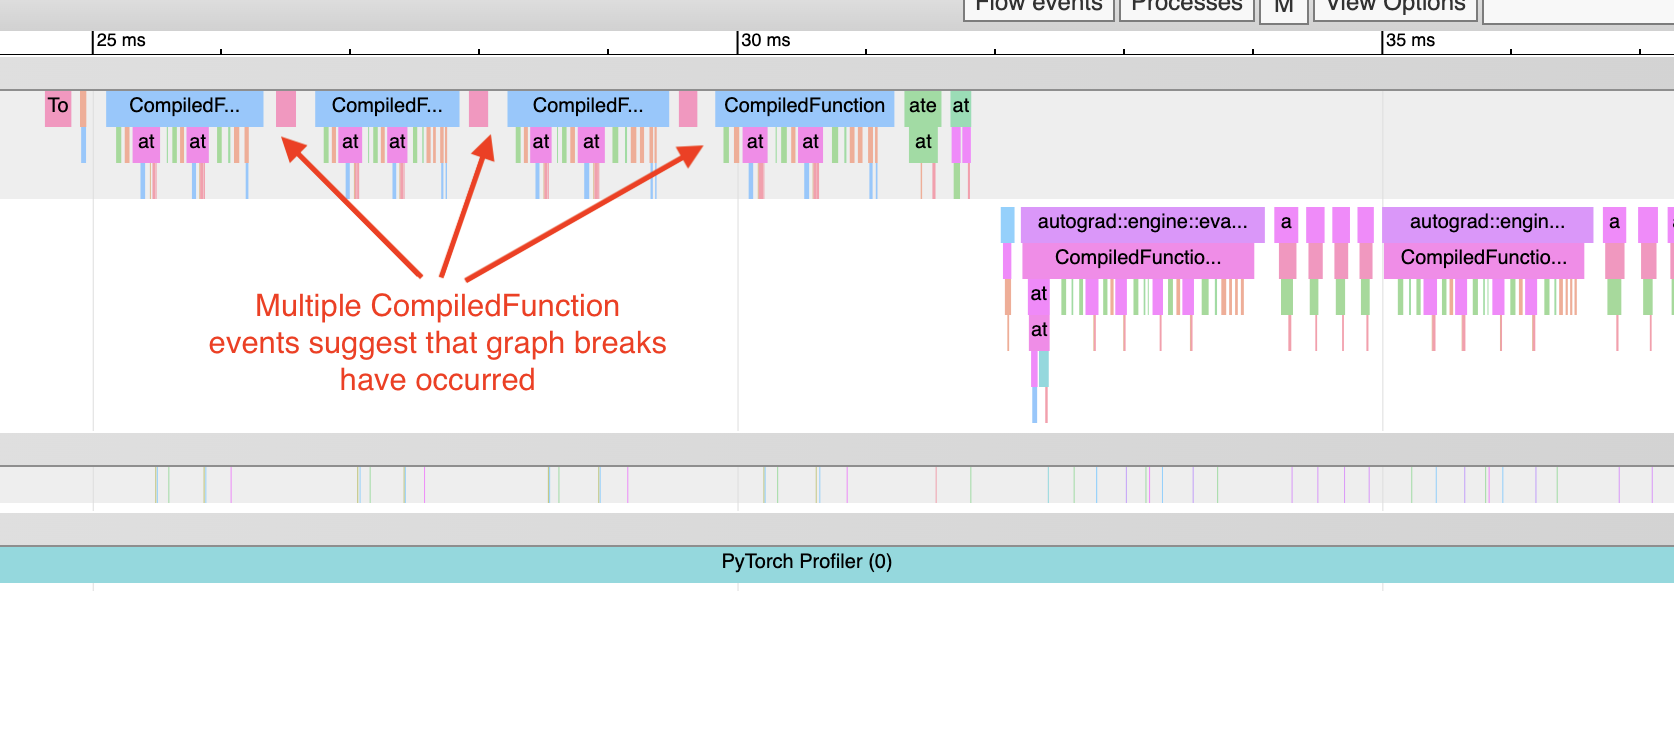
Хотя существуют инструменты ведения журнала для выявления разрывов графа, профилировщик предоставляет быстрый визуальный метод выявления разрывов графа.
Если для каких-либо входных данных требуются градиенты, разрывы графа легко определить: каждый разрыв графа прервет блок CompiledFunction, разделив его на две части.
См. синтетический пример ниже для демонстрации:
import torch
import torch._dynamo

class ModelWithBreaks(torch.nn.Module):
    def __init__(self):
        super().__init__()
        def create_sequential():
            return torch.nn.Sequential(
                torch.nn.Linear(128, 128),
                torch.nn.ReLU(),
                torch.nn.Linear(128, 128),
                torch.nn.ReLU(),
            )
        self.mod1 = create_sequential()
        self.mod2 = create_sequential()
        self.mod3 = create_sequential()
        self.mod4 = create_sequential()

    def forward(self, inp):
        mod1 = self.mod1(inp)
        torch._dynamo.graph_break()
        mod2 = self.mod2(mod1)
        torch._dynamo.graph_break()
        mod3 = self.mod3(mod2)
        torch._dynamo.graph_break()
        mod4 = self.mod4(mod3)
        return mod4


model = ModelWithBreaks().cuda()
inputs = [torch.randn((128, 128), device='cuda') for _ in range(10)]

model_c = torch.compile(model)

def fwd_bwd(inp):
    out = model_c(inp)
    out.sum().backward()

# warm up
fwd_bwd(inputs[0])

with torch.profiler.profile() as prof:
    for i in range(1, 4):
        fwd_bwd(inputs[i])
        prof.step()

prof.export_chrome_trace("trace_break.json")
Накладные расходы на запуск
Распространённой проблемой является плохое использование GPU. Быстрый способ определить это — наличие больших промежутков между ядрами на GPU:
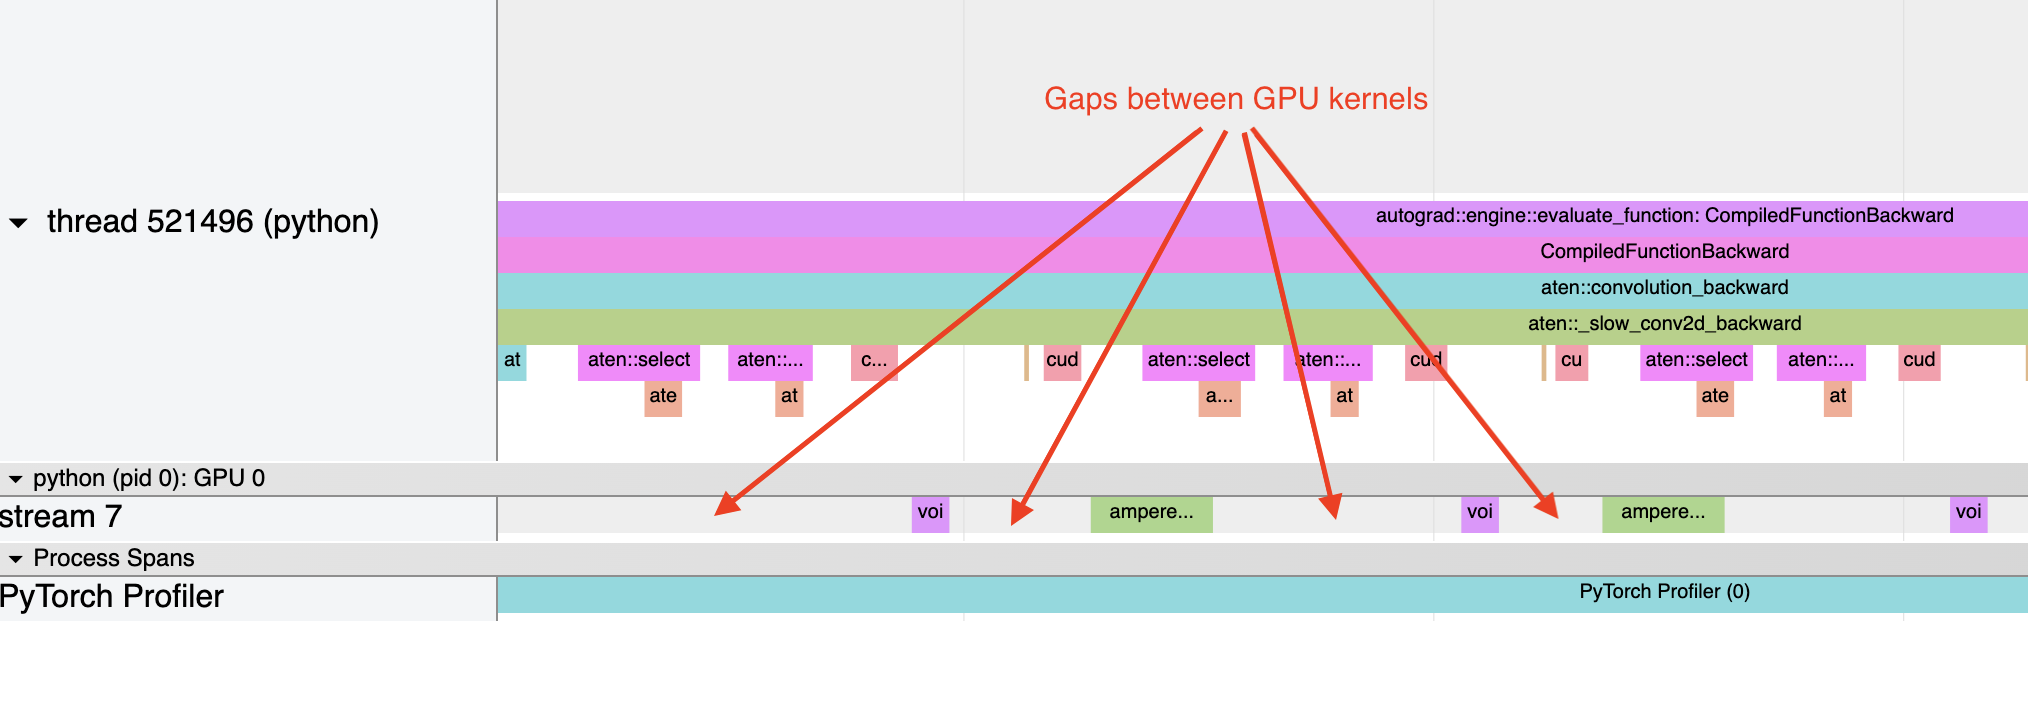
Это часто является следствием накладных расходов CPU, например, если время, затрачиваемое на CPU между запусками ядер, больше, чем время, потраченное GPU на обработку ядер. Проблема более распространена для небольших размеров пакета.
При использовании индуктора включение CUDA графиков часто помогает улучшить производительность, когда накладные расходы на запуск являются проблемой.
© 2024, PyTorch Contributors
PyTorch has a BSD-style license, as found in the LICENSE file.
https://pytorch.org/docs/2.1/torch.compiler_profiling_torch_compile.html


