Понимание использования памяти CUDA
Для отладки использования памяти CUDA PyTorch предоставляет возможность создавать снимки памяти, которые записывают состояние выделенной памяти CUDA в любой момент времени и, по желанию, записывают историю событий выделения, приведших к этому снимку.
Сгенерированные снимки можно перетащить в интерактивный просмотрщик, размещённый по адресу pytorch.org/memory_viz, для их изучения.
Генерация снимка
Общий шаблон для записи снимка — это включение истории памяти, выполнение наблюдаемого кода и затем сохранение файла с закодированным снимком:
# enable memory history, which will
# add tracebacks and event history to snapshots
torch.cuda.memory._record_memory_history()

run_your_code()
torch.cuda.memory._dump_snapshot("my_snapshot.pickle")
Использование визуализатора
Откройте pytorch.org/memory_viz и перетащите файл закодированного снимка в визуализатор. Визуализатор — это приложение на JavaScript, работающее локально на вашем компьютере. Он не загружает данные снимка.
Активная временная шкала памяти
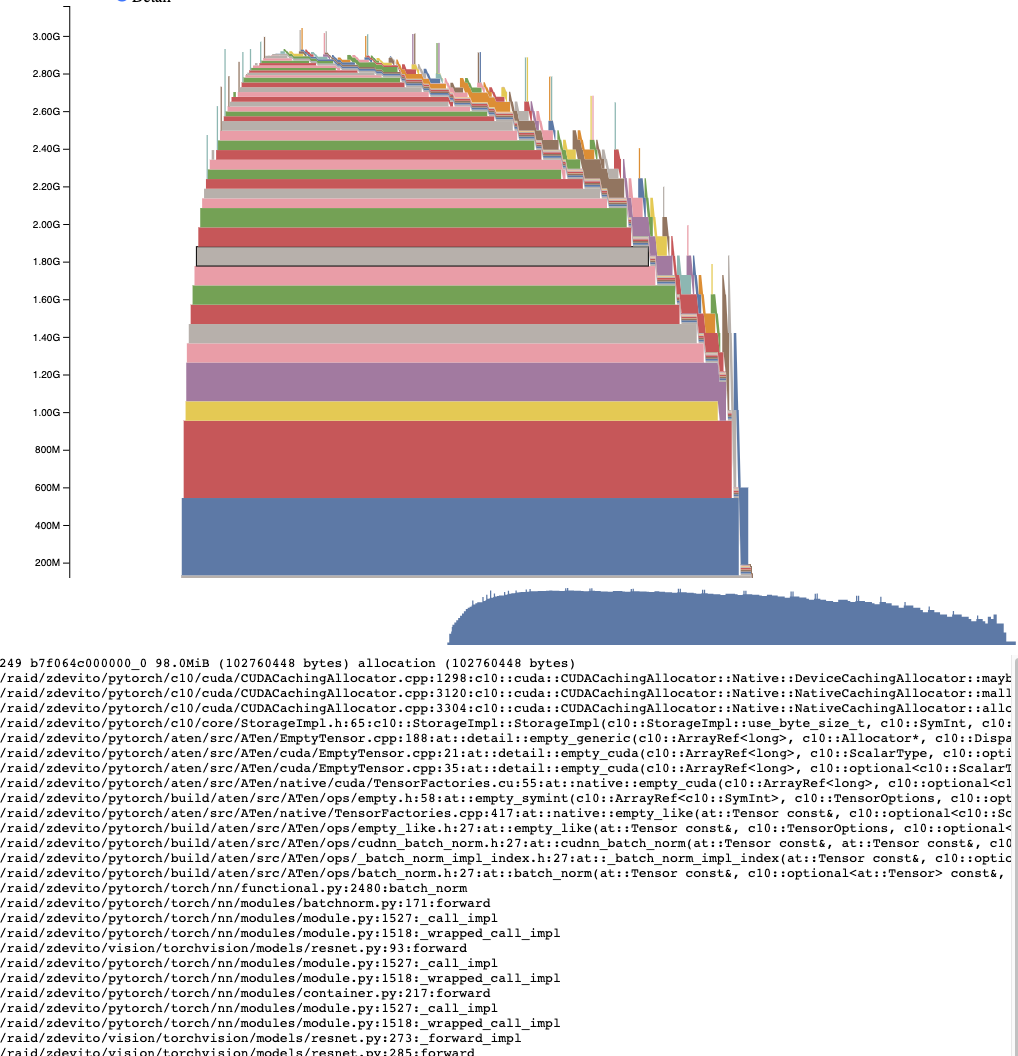
Активная временная шкала памяти отображает все активные тензоры в течение времени в снимке на определённом графическом процессоре. Используйте масштабирование/перемещение по графику для просмотра более мелких выделений. Наведите курсор на выделенные блоки, чтобы увидеть стек вызовов, когда этот блок был выделен, а также такие детали, как его адрес. Слайдер деталей можно настроить для отображения меньшего количества выделений и повышения производительности при большом объёме данных.
История состояния выделения
История состояния выделения отображает отдельные события выделения в временной шкале слева. Выберите событие в временной шкале, чтобы увидеть визуальное резюме состояния выделения в это событие. Это резюме отображает каждый отдельный сегмент, возвращённый функцией cudaMalloc, и как он разделяется на блоки отдельных выделений или свободного пространства. Наведите курсор на сегменты и блоки, чтобы увидеть стек вызовов при выделении памяти. Наведите курсор на события, чтобы увидеть стек вызовов при возникновении события, например, при освобождении тензора. Ошибки недостатка памяти сообщаются как события OOM. Изучение состояния памяти во время OOM может дать представление о причинах сбоя выделения, даже если зарезервированная память по-прежнему существует.
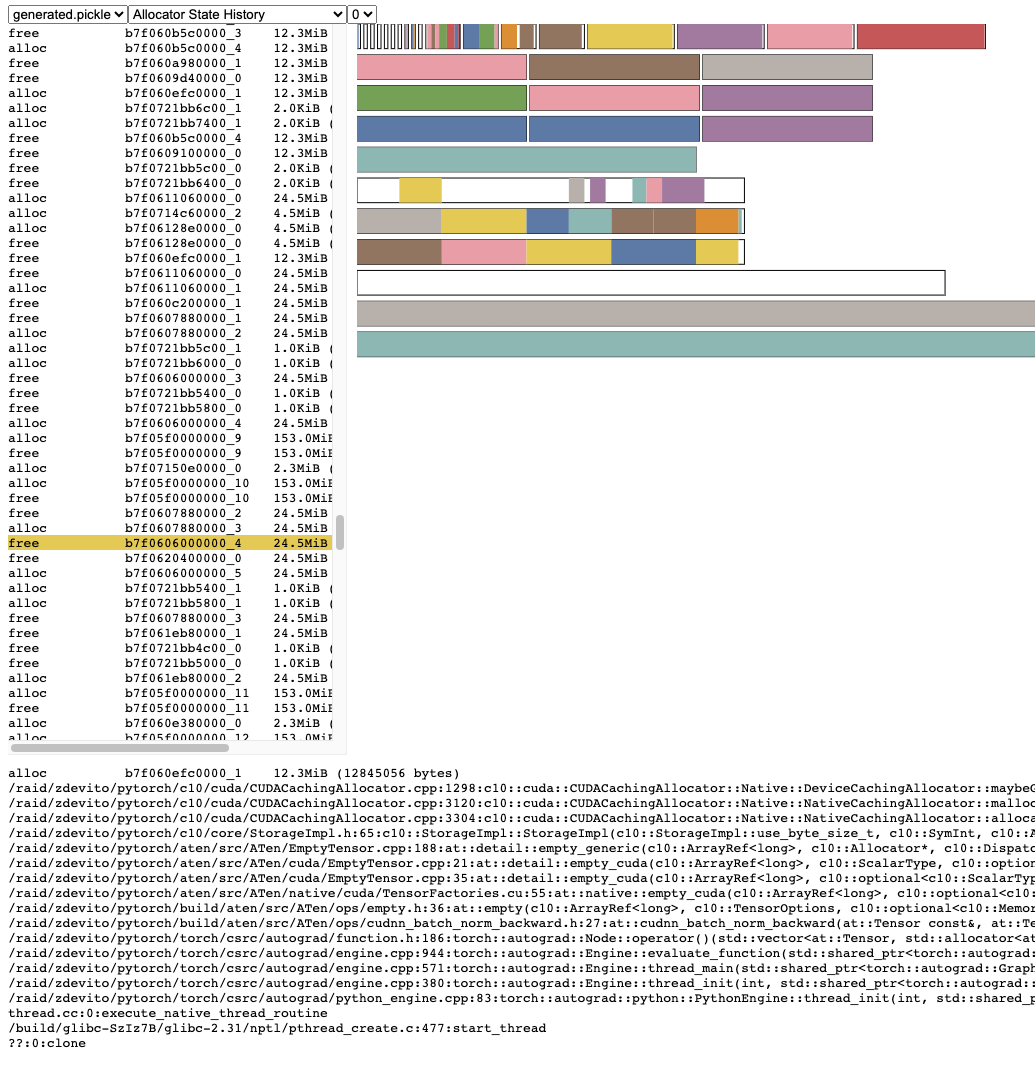
Информация о стеке вызовов также сообщает об адресе, в котором произошло выделение. Адрес b7f064c000000_0 относится к блоку по адресу 7f064c000000, который является «_0» -м обращением к этому адресу. Эту уникальную строку можно найти в активной временной шкале памяти и искать в истории активного состояния, чтобы изучить состояние памяти при выделении или освобождении тензора.
Справочник API снимков
-
torch.cuda.memory._record_memory_history(enabled='all', context='all', stacks='all', max_entries=9223372036854775807, device=None)[source] -
Включает запись стеков вызовов, связанных с выделениями памяти, так что вы можете определить, что выделило любой фрагмент памяти в
torch.cuda.memory._snapshot().Помимо сохранения стеков вызовов с каждым текущим выделением и освобождением, это также включит запись истории всех событий выделения/освобождения.
Используйте
torch.cuda.memory._snapshot()для получения этой информации и инструменты в_memory_viz.pyдля визуализации снимков.Сбор трассировок Python быстрый (2 мкс на трассировку), поэтому вы можете рассмотреть возможность включения этого в производственных задачах, если ожидается необходимость отладки проблем с памятью.
Сбор трассировок C++ также быстрый (~50 нс/кадр), что для многих типичных программ составляет ~2 мкс на трассировку, но может варьироваться в зависимости от глубины стека.
- Параметры
-
-
enabled (Literal[None, "state", "all"], optional) –
None, отключение записи истории памяти.“state”, сохранение информации для текущей выделенной памяти.“all”, дополнительно сохранение истории всех вызовов выделения/освобождения. По умолчанию «all». -
context (Literal[None, "state", "alloc", "all"], optional) –
None, не записывать никакие трассировки.“state”, запись трассировок для текущей выделенной памяти.“alloc”, дополнительно записывать трассировки для вызовов выделения.“all”, дополнительно записывать трассировки для вызовов освобождения. По умолчанию «all». -
stacks (Literal["python", "all"], optional) –
“python”, включить кадры Python, TorchScript и inductor в трассировки“all”, дополнительно включить кадры C++ По умолчанию «all». -
max_entries (int, optional) – Сохранять максимум
max_entriesсобытий выделения/освобождения в записанной истории.
-
enabled (Literal[None, "state", "all"], optional) –
-
torch.cuda.memory._snapshot(device=None)[source] -
Сохраняет снимок состояния памяти CUDA в момент вызова. Состояние представлено в виде словаря со следующей структурой.
class Snapshot(TypedDict): segments : List[Segment] device_traces: List[List[TraceEntry]] class Segment(TypedDict): # Segments are memory returned from a cudaMalloc call. # The size of reserved memory is the sum of all Segments. # Segments are cached and reused for future allocations. # If the reuse is smaller than the segment, the segment # is split into more then one Block. # empty_cache() frees Segments that are entirely inactive. address: int total_size: int # cudaMalloc'd size of segment stream: int segment_type: Literal['small', 'large'] # 'large' (>1MB) allocated_size: int # size of memory in use active_size: int # size of memory in use or in active_awaiting_free state blocks : List[Block] class Block(TypedDict): # A piece of memory returned from the allocator, or # current cached but inactive. size: int requested_size: int # size requested during malloc, may be smaller than # size due to rounding address: int state: Literal['active_allocated', # used by a tensor 'active_awaiting_free', # waiting for another stream to finish using # this, then it will become free 'inactive',] # free for reuse frames: List[Frame] # stack trace from where the allocation occurred class Frame(TypedDict): filename: str line: int name: str class TraceEntry(TypedDict): # When `torch.cuda.memory._record_memory_history()` is enabled, # the snapshot will contain TraceEntry objects that record each # action the allocator took. action: Literal[ 'alloc' # memory allocated 'free_requested', # the allocated received a call to free memory 'free_completed', # the memory that was requested to be freed is now # able to be used in future allocation calls 'segment_alloc', # the caching allocator ask cudaMalloc for more memory # and added it as a segment in its cache 'segment_free', # the caching allocator called cudaFree to return memory # to cuda possibly trying free up memory to # allocate more segments or because empty_caches was called 'oom', # the allocator threw an OOM exception. 'size' is # the requested number of bytes that did not succeed 'snapshot' # the allocator generated a memory snapshot # useful to coorelate a previously taken # snapshot with this trace ] addr: int # not present for OOM frames: List[Frame] size: int stream: int device_free: int # only present for OOM, the amount of # memory cuda still reports to be free- Возвращает
-
Объект словаря Snapshot
-
torch.cuda.memory._dump_snapshot(filename='dump_snapshot.pickle')[source] -
Сохраняет закодированную версию словаря
torch.memory._snapshot()в файл. Этот файл можно открыть с помощью интерактивного просмотрщика снимков по адресу pytorch.org/memory_viz- Параметры
-
filename (str, optional) – Имя создаваемого файла. По умолчанию «dump_snapshot.pickle».
© 2024, PyTorch Contributors
PyTorch has a BSD-style license, as found in the LICENSE file.
https://pytorch.org/docs/2.1/torch_cuda_memory.html


