Примечание
Перейти к концу, чтобы загрузить полный код примера. или запустить этот пример в браузере через JupyterLite или Binder
Линейный и квадратичный дискриминантный анализ с эллипсами ковариации
В этом примере отображаются эллипсы ковариации каждого класса и граница принятия решений, вычисленная с помощью LinearDiscriminantAnalysis (LDA) и QuadraticDiscriminantAnalysis (QDA). Эллипсы отображают удвоенное стандартное отклонение для каждого класса. В случае LDA стандартное отклонение одинаково для всех классов, тогда как каждый класс имеет собственное стандартное отклонение в случае QDA.
# Authors: The scikit-learn developers
# SPDX-License-Identifier: BSD-3-Clause
Генерация данных
Сначала мы определим функцию для генерации синтетических данных. Она создает два облака, центрированные в (0, 0) и (1, 1). Каждому облаку назначается определенный класс. Разброс облака контролируется параметрами cov_class_1 и cov_class_2, являющимися матрицами ковариации, используемыми при генерации выборок из гауссовых распределений.
import numpy as np


def make_data(n_samples, n_features, cov_class_1, cov_class_2, seed=0):
    rng = np.random.RandomState(seed)
    X = np.concatenate(
        [
            rng.randn(n_samples, n_features) @ cov_class_1,
            rng.randn(n_samples, n_features) @ cov_class_2 + np.array([1, 1]),
        ]
    )
    y = np.concatenate([np.zeros(n_samples), np.ones(n_samples)])
    return X, y
Мы генерируем три набора данных. В первом наборе данных два класса имеют одинаковую матрицу ковариации, и эта матрица ковариации обладает свойством быть сферической (изотропной). Второй набор данных аналогичен первому, но не налагает ограничение на сферичность ковариации. Наконец, третий набор данных имеет не сферическую матрицу ковариации для каждого класса.
covariance = np.array([[1, 0], [0, 1]])
X_isotropic_covariance, y_isotropic_covariance = make_data(
    n_samples=1_000,
    n_features=2,
    cov_class_1=covariance,
    cov_class_2=covariance,
    seed=0,
)
covariance = np.array([[0.0, -0.23], [0.83, 0.23]])
X_shared_covariance, y_shared_covariance = make_data(
    n_samples=300,
    n_features=2,
    cov_class_1=covariance,
    cov_class_2=covariance,
    seed=0,
)
cov_class_1 = np.array([[0.0, -1.0], [2.5, 0.7]]) * 2.0
cov_class_2 = cov_class_1.T
X_different_covariance, y_different_covariance = make_data(
    n_samples=300,
    n_features=2,
    cov_class_1=cov_class_1,
    cov_class_2=cov_class_2,
    seed=0,
)
Функции построения графиков
Код ниже используется для построения нескольких графических элементов, полученных из оценщиков, т.е., LinearDiscriminantAnalysis (LDA) и QuadraticDiscriminantAnalysis (QDA). Отображаемая информация включает:
- границу принятия решений, основанную на оценке вероятности оценщика;
- диаграмму рассеяния с кружками, представляющими хорошо классифицированные выборки;
- диаграмму рассеяния с крестиками, представляющими неправильно классифицированные выборки;
- среднее значение каждого класса, оцененное оценщиком, отмеченное звездочкой;
- оцененная ковариация, представленная эллипсом на расстоянии 2 стандартных отклонений от среднего значения.
import matplotlib as mpl
from matplotlib import colors

from sklearn.inspection import DecisionBoundaryDisplay


def plot_ellipse(mean, cov, color, ax):
    v, w = np.linalg.eigh(cov)
    u = w[0] / np.linalg.norm(w[0])
    angle = np.arctan(u[1] / u[0])
    angle = 180 * angle / np.pi  # convert to degrees
    # filled Gaussian at 2 standard deviation
    ell = mpl.patches.Ellipse(
        mean,
        2 * v[0] ** 0.5,
        2 * v[1] ** 0.5,
        angle=180 + angle,
        facecolor=color,
        edgecolor="black",
        linewidth=2,
    )
    ell.set_clip_box(ax.bbox)
    ell.set_alpha(0.4)
    ax.add_artist(ell)


def plot_result(estimator, X, y, ax):
    cmap = colors.ListedColormap(["tab:red", "tab:blue"])
    DecisionBoundaryDisplay.from_estimator(
        estimator,
        X,
        response_method="predict_proba",
        plot_method="pcolormesh",
        ax=ax,
        cmap="RdBu",
        alpha=0.3,
    )
    DecisionBoundaryDisplay.from_estimator(
        estimator,
        X,
        response_method="predict_proba",
        plot_method="contour",
        ax=ax,
        alpha=1.0,
        levels=[0.5],
    )
    y_pred = estimator.predict(X)
    X_right, y_right = X[y == y_pred], y[y == y_pred]
    X_wrong, y_wrong = X[y != y_pred], y[y != y_pred]
    ax.scatter(X_right[:, 0], X_right[:, 1], c=y_right, s=20, cmap=cmap, alpha=0.5)
    ax.scatter(
        X_wrong[:, 0],
        X_wrong[:, 1],
        c=y_wrong,
        s=30,
        cmap=cmap,
        alpha=0.9,
        marker="x",
    )
    ax.scatter(
        estimator.means_[:, 0],
        estimator.means_[:, 1],
        c="yellow",
        s=200,
        marker="*",
        edgecolor="black",
    )

    if isinstance(estimator, LinearDiscriminantAnalysis):
        covariance = [estimator.covariance_] * 2
    else:
        covariance = estimator.covariance_
    plot_ellipse(estimator.means_[0], covariance[0], "tab:red", ax)
    plot_ellipse(estimator.means_[1], covariance[1], "tab:blue", ax)

    ax.set_box_aspect(1)
    ax.spines["top"].set_visible(False)
    ax.spines["bottom"].set_visible(False)
    ax.spines["left"].set_visible(False)
    ax.spines["right"].set_visible(False)
    ax.set(xticks=[], yticks=[])
Сравнение LDA и QDA
Мы сравниваем два оценщика LDA и QDA на всех трех наборах данных.
import matplotlib.pyplot as plt

from sklearn.discriminant_analysis import (
    LinearDiscriminantAnalysis,
    QuadraticDiscriminantAnalysis,
)

fig, axs = plt.subplots(nrows=3, ncols=2, sharex="row", sharey="row", figsize=(8, 12))

lda = LinearDiscriminantAnalysis(solver="svd", store_covariance=True)
qda = QuadraticDiscriminantAnalysis(store_covariance=True)

for ax_row, X, y in zip(
    axs,
    (X_isotropic_covariance, X_shared_covariance, X_different_covariance),
    (y_isotropic_covariance, y_shared_covariance, y_different_covariance),
):
    lda.fit(X, y)
    plot_result(lda, X, y, ax_row[0])
    qda.fit(X, y)
    plot_result(qda, X, y, ax_row[1])

axs[0, 0].set_title("Linear Discriminant Analysis")
axs[0, 0].set_ylabel("Data with fixed and spherical covariance")
axs[1, 0].set_ylabel("Data with fixed covariance")
axs[0, 1].set_title("Quadratic Discriminant Analysis")
axs[2, 0].set_ylabel("Data with varying covariances")
fig.suptitle(
    "Linear Discriminant Analysis vs Quadratic Discriminant Analysis",
    y=0.94,
    fontsize=15,
)
plt.show()
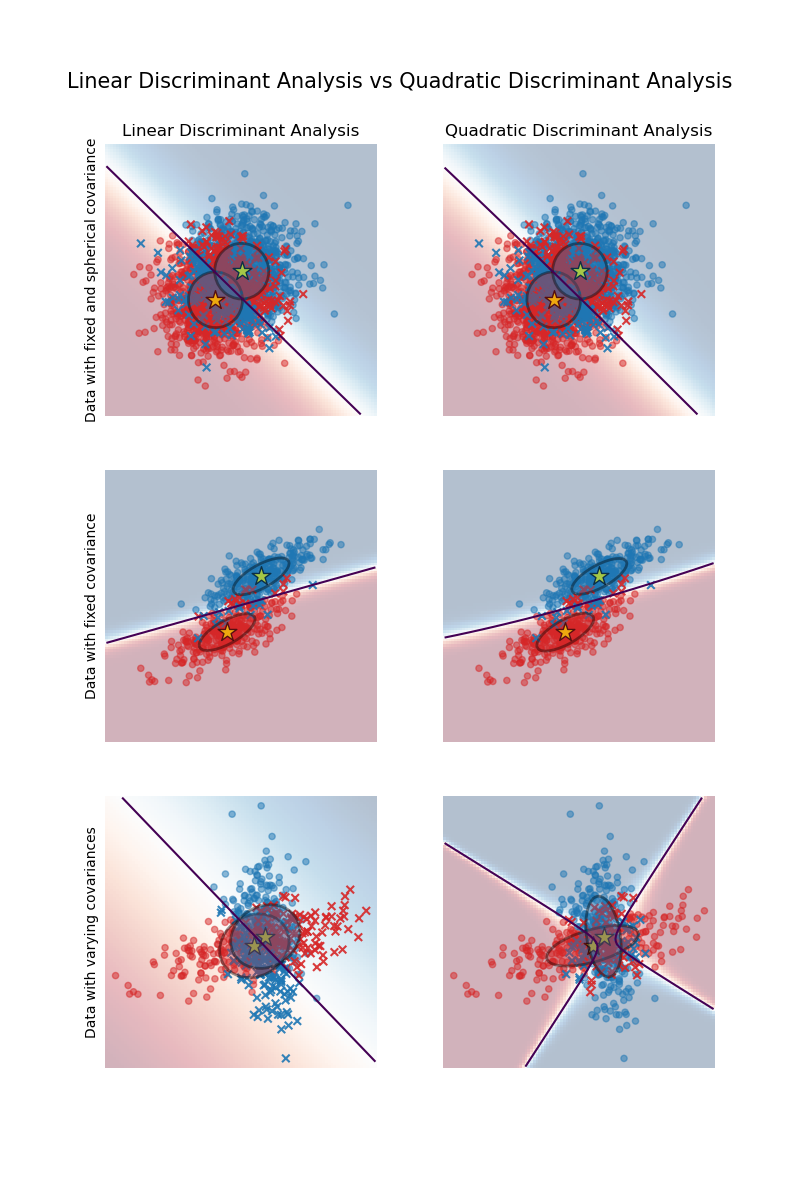
Первым важным моментом является то, что LDA и QDA эквивалентны для первого и второго наборов данных. Действительно, основное различие заключается в том, что LDA предполагает, что матрица ковариации каждого класса равна, в то время как QDA оценивает матрицу ковариации для каждого класса. Поскольку в этих случаях процесс генерации данных имеет одинаковую матрицу ковариации для обоих классов, QDA оценивает две матрицы ковариации, которые (почти) равны, и, следовательно, эквивалентны матрице ковариации, оцененной LDA.
В первом наборе данных матрица ковариации, используемая для генерации набора данных, является сферической, что приводит к границе принятия решений, которая совпадает с перпендикулярной биссектрисой между двумя средними значениями. Это больше не относится ко второму набору данных. Граница принятия решений проходит только через середину двух средних значений.
Наконец, в третьем наборе данных мы наблюдаем реальное различие между LDA и QDA. QDA подгоняет две матрицы ковариации и предоставляет нелинейную границу принятия решений, тогда как LDA недообучается, поскольку предполагает, что оба класса имеют одну общую матрицу ковариации.
Общее время выполнения скрипта: (0 минут 0,414 секунды)


Связанные примеры


© 2007–2025 The scikit-learn developers
Licensed under the 3-clause BSD License.
https://scikit-learn.org/1.6/auto_examples/classification/plot_lda_qda.html


