Примечание
Перейти к концу для загрузки полного примера кода. или для запуска этого примера в браузере через JupyterLite или Binder
Особенности моделей градиентного бустинга с гистограммами
Градиентный бустинг на основе гистограмм (HGBT) — одна из наиболее полезных моделей машинного обучения с учителем в scikit-learn. Они основаны на современной реализации градиентного бустинга, сопоставимой с LightGBM и XGBoost. Таким образом, модели HGBT более функциональны, чем и часто превосходят альтернативные модели, такие как случайные леса, особенно когда количество образцов больше, чем несколько десятков тысяч (см. Сравнение случайных лесов и моделей градиентного бустинга с гистограммами).
Основные функциональные преимущества моделей HGBT:
- Несколько доступных функций потерь для задач регрессии среднего и квантиля, см. Функция потерь квантиля.
- Поддержка категориальных признаков, см. Поддержка категориальных признаков в градиентном бустинге.
- Преждевременная остановка.
- Поддержка пропущенных значений, что исключает необходимость импьютера.
- Монотонные ограничения.
- Ограничения взаимодействия.
Этот пример предназначен для демонстрации всех пунктов, кроме 2 и 6, в реальной ситуации.
# Authors: The scikit-learn developers
# SPDX-License-Identifier: BSD-3-Clause
Подготовка данных
Набор данных по электроэнергии состоит из данных, собранных на рынке электроэнергии Нового Южного Уэльса (Австралия). На этом рынке цены не фиксированы и зависят от спроса и предложения. Они устанавливаются каждые пять минут. Передачи электроэнергии в/из соседнего штата Виктория проводились для сглаживания колебаний.
Набор данных, первоначально названный ELEC2, содержит 45 312 записей с датами с 7 мая 1996 по 5 декабря 1998 года. Каждый образец набора данных относится к периоду 30 минут, то есть на каждый период в один день приходится 48 записей. Каждый образец набора данных имеет 7 столбцов:
- дата: между 7 мая 1996 и 5 декабря 1998. Нормализовано в диапазоне от 0 до 1;
- день: день недели (1-7);
- период: получасовые интервалы в течение 24 часов. Нормализовано в диапазоне от 0 до 1;
- nswprice/nswdemand: цена/спрос на электроэнергию в Новом Южном Уэльсе;
- vicprice/vicdemand: цена/спрос на электроэнергию в Виктории.
Первоначально это задача классификации, но здесь мы используем ее для задачи регрессии для предсказания запланированной передачи электроэнергии между штатами.
from sklearn.datasets import fetch_openml

electricity = fetch_openml(
    name="electricity", version=1, as_frame=True, parser="pandas"
)
df = electricity.frame
Этот конкретный набор данных имеет пошаговое постоянное значение для первых 17 760 записей:
df["transfer"][:17_760].unique()
array([0.414912, 0.500526])
Давайте удалим эти записи и рассмотрим почасовую передачу электроэнергии в разные дни недели:
import matplotlib.pyplot as plt
import seaborn as sns

df = electricity.frame.iloc[17_760:]
X = df.drop(columns=["transfer", "class"])
y = df["transfer"]

fig, ax = plt.subplots(figsize=(15, 10))
pointplot = sns.lineplot(x=df["period"], y=df["transfer"], hue=df["day"], ax=ax)
handles, lables = ax.get_legend_handles_labels()
ax.set(
    title="Hourly energy transfer for different days of the week",
    xlabel="Normalized time of the day",
    ylabel="Normalized energy transfer",
)
_ = ax.legend(handles, ["Sun", "Mon", "Tue", "Wed", "Thu", "Fri", "Sat"])
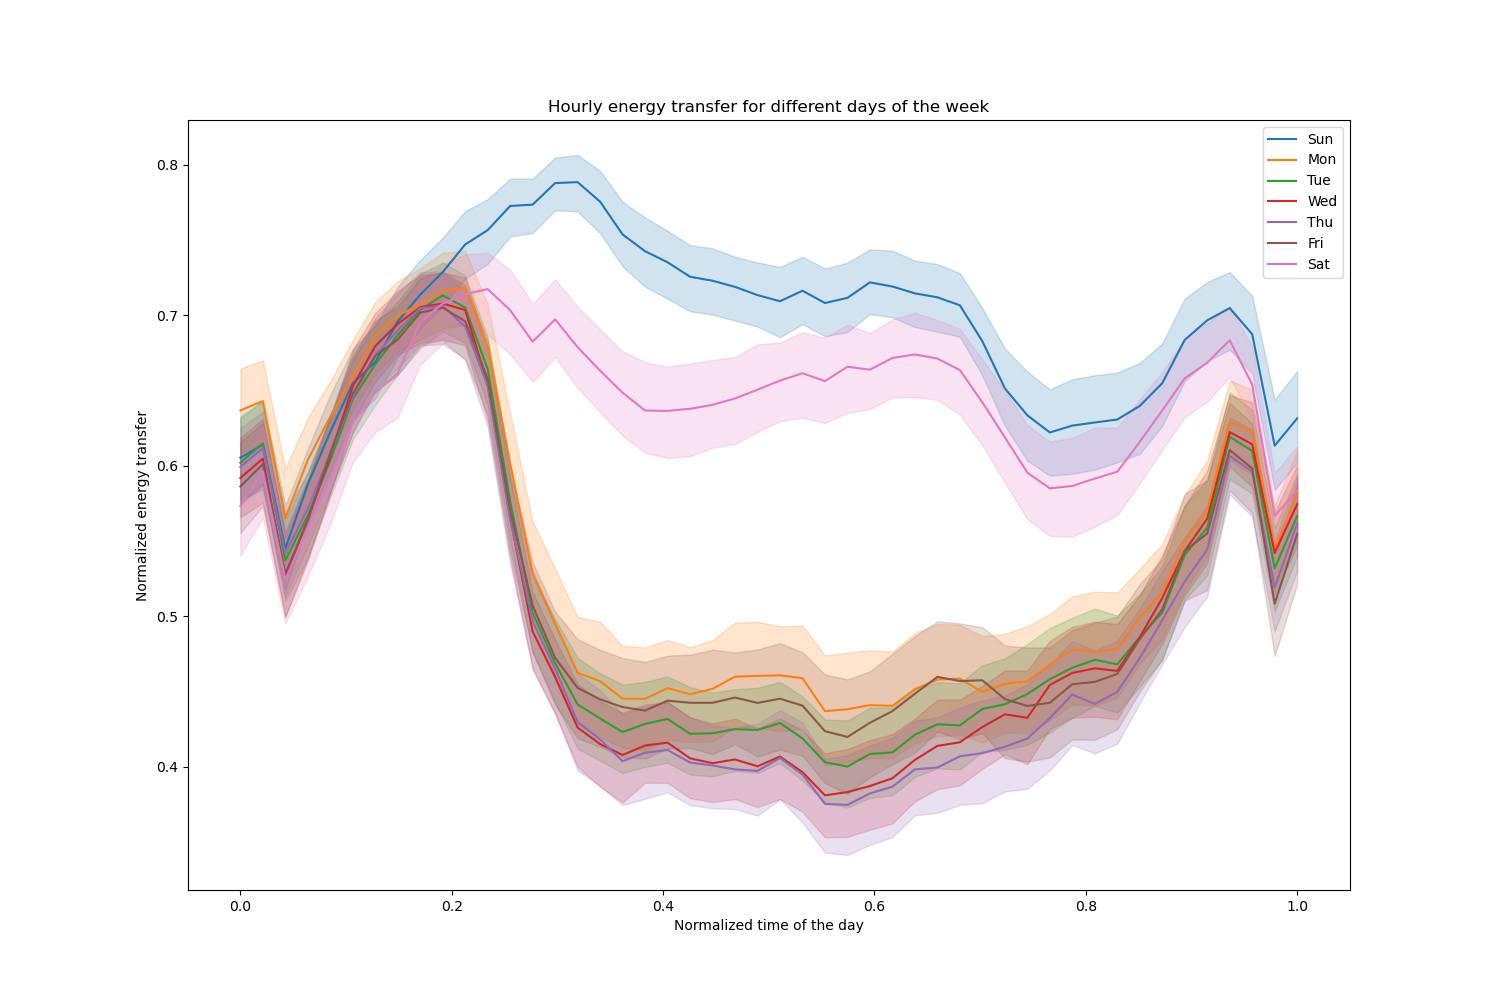
Обратите внимание, что передача энергии систематически увеличивается в выходные дни.
Влияние количества деревьев и преждевременной остановки
Для демонстрации влияния (максимального) количества деревьев мы обучаем HistGradientBoostingRegressor на ежедневной передаче электроэнергии, используя весь набор данных. Затем мы визуализируем его прогнозы в зависимости от параметра max_iter. Здесь мы не пытаемся оценить производительность модели и ее способность к обобщению, а скорее ее способность учиться на данных обучения.
from sklearn.ensemble import HistGradientBoostingRegressor
from sklearn.model_selection import train_test_split

X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.4, shuffle=False)

print(f"Training sample size: {X_train.shape[0]}")
print(f"Test sample size: {X_test.shape[0]}")
print(f"Number of features: {X_train.shape[1]}")
Training sample size: 16531
Test sample size: 11021
Number of features: 7
max_iter_list = [5, 50]
average_week_demand = (
    df.loc[X_test.index].groupby(["day", "period"], observed=False)["transfer"].mean()
)
colors = sns.color_palette("colorblind")
fig, ax = plt.subplots(figsize=(10, 5))
average_week_demand.plot(color=colors[0], label="recorded average", linewidth=2, ax=ax)

for idx, max_iter in enumerate(max_iter_list):
    hgbt = HistGradientBoostingRegressor(
        max_iter=max_iter, categorical_features=None, random_state=42
    )
    hgbt.fit(X_train, y_train)

    y_pred = hgbt.predict(X_test)
    prediction_df = df.loc[X_test.index].copy()
    prediction_df["y_pred"] = y_pred
    average_pred = prediction_df.groupby(["day", "period"], observed=False)[
        "y_pred"
    ].mean()
    average_pred.plot(
        color=colors[idx + 1], label=f"max_iter={max_iter}", linewidth=2, ax=ax
    )

ax.set(
    title="Predicted average energy transfer during the week",
    xticks=[(i + 0.2) * 48 for i in range(7)],
    xticklabels=["Sun", "Mon", "Tue", "Wed", "Thu", "Fri", "Sat"],
    xlabel="Time of the week",
    ylabel="Normalized energy transfer",
)
_ = ax.legend()

С помощью нескольких итераций модели HGBT могут достичь сходимости (см. Сравнение случайных лесов и моделей градиентного бустинга с гистограммами), что означает, что добавление дополнительных деревьев больше не улучшает модель. На приведенном выше рисунке 5 итераций недостаточно для получения хороших прогнозов. С 50 итерациями мы уже можем выполнить хорошую работу.
Установка max_iter слишком высокой может ухудшить качество прогноза и привести к большим ненужным вычислительным затратам. Поэтому реализация HGBT в scikit-learn предоставляет автоматическую стратегию преждевременной остановки. С ее помощью модель использует часть обучающих данных в качестве внутренней проверочной выборки (validation_fraction) и останавливает обучение, если оценка на проверочной выборке не улучшается (или ухудшается) после n_iter_no_change итераций в пределах определенной толерантности (tol).
Обратите внимание, что существует компромисс между learning_rate и max_iter: В целом, меньшие значения learning rate предпочтительнее, но требуют большего числа итераций для сходимости к минимальной функции потерь, в то время как большие значения learning rate сходимость быстрее (требуется меньше итераций/деревьев), но с большей минимальной функцией потерь.
Из-за этой высокой корреляции между learning rate и количеством итераций, хорошей практикой является настройка learning rate вместе со всеми (важными) другими гиперпараметрами, обучение модели HBGT на обучающей выборке с достаточно большим значением для max_iter и определение наилучшего max_iter с помощью преждевременной остановки и некоторых явных validation_fraction.
common_params = {
    "max_iter": 1_000,
    "learning_rate": 0.3,
    "validation_fraction": 0.2,
    "random_state": 42,
    "categorical_features": None,
    "scoring": "neg_root_mean_squared_error",
}

hgbt = HistGradientBoostingRegressor(early_stopping=True, **common_params)
hgbt.fit(X_train, y_train)

_, ax = plt.subplots()
plt.plot(-hgbt.validation_score_)
_ = ax.set(
    xlabel="number of iterations",
    ylabel="root mean squared error",
    title=f"Loss of hgbt with early stopping (n_iter={hgbt.n_iter_})",
)

Затем мы можем перезаписать значение для max_iter на разумное значение и избежать дополнительных вычислительных затрат внутренней проверки. Округляя количество итераций, можно учесть вариативность обучающей выборки:
import math

common_params["max_iter"] = math.ceil(hgbt.n_iter_ / 100) * 100
common_params["early_stopping"] = False
hgbt = HistGradientBoostingRegressor(**common_params)
Примечание
Внутренняя проверка, выполняемая при преждевременной остановке, не оптимальна для временных рядов.
Поддержка пропущенных значений
Модели HGBT обладают встроенной поддержкой пропущенных значений. При обучении строитель дерева определяет, куда должны направляться образцы с пропущенными значениями (левое или правое поддерево) на каждом шаге разделения, основываясь на потенциальном выигрыше. При прогнозировании эти образцы отправляются соответствующему поддереву. Если в обучающей выборке признак не имел пропущенных значений, то при прогнозировании образцы с пропущенными значениями для этого признака отправляются в поддерево с наибольшим количеством образцов (как это наблюдалось во время обучения).
Настоящий пример демонстрирует, как регрессии HGBT справляются со значениями, отсутствующими случайно (MCAR), т. е. отсутствие значений не зависит от наблюдаемых данных или отсутствующих данных. Мы можем смоделировать такую ситуацию, случайным образом заменяя значения из случайных признаков значениями nan.
import numpy as np

from sklearn.metrics import root_mean_squared_error

rng = np.random.RandomState(42)
first_week = slice(0, 336)  # first week in the test set as 7 * 48 = 336
missing_fraction_list = [0, 0.01, 0.03]


def generate_missing_values(X, missing_fraction):
    total_cells = X.shape[0] * X.shape[1]
    num_missing_cells = int(total_cells * missing_fraction)
    row_indices = rng.choice(X.shape[0], num_missing_cells, replace=True)
    col_indices = rng.choice(X.shape[1], num_missing_cells, replace=True)
    X_missing = X.copy()
    X_missing.iloc[row_indices, col_indices] = np.nan
    return X_missing


fig, ax = plt.subplots(figsize=(12, 6))
ax.plot(y_test.values[first_week], label="Actual transfer")

for missing_fraction in missing_fraction_list:
    X_train_missing = generate_missing_values(X_train, missing_fraction)
    X_test_missing = generate_missing_values(X_test, missing_fraction)
    hgbt.fit(X_train_missing, y_train)
    y_pred = hgbt.predict(X_test_missing[first_week])
    rmse = root_mean_squared_error(y_test[first_week], y_pred)
    ax.plot(
        y_pred[first_week],
        label=f"missing_fraction={missing_fraction}, RMSE={rmse:.3f}",
        alpha=0.5,
    )
ax.set(
    title="Daily energy transfer predictions on data with MCAR values",
    xticks=[(i + 0.2) * 48 for i in range(7)],
    xticklabels=["Mon", "Tue", "Wed", "Thu", "Fri", "Sat", "Sun"],
    xlabel="Time of the week",
    ylabel="Normalized energy transfer",
)
_ = ax.legend(loc="lower right")

Как ожидалось, модель ухудшается по мере увеличения доли пропущенных значений.
Поддержка функции потерь квантиля
Функция потерь квантиля в регрессии позволяет оценить изменчивость или неопределенность целевой переменной. Например, предсказание 5-го и 95-го перцентилей может предоставить 90% доверительный интервал, т. е. диапазон, в котором мы ожидаем, что новое наблюдаемое значение будет находиться с вероятностью 90%.
from sklearn.metrics import mean_pinball_loss

quantiles = [0.95, 0.05]
predictions = []

fig, ax = plt.subplots(figsize=(12, 6))
ax.plot(y_test.values[first_week], label="Actual transfer")

for quantile in quantiles:
    hgbt_quantile = HistGradientBoostingRegressor(
        loss="quantile", quantile=quantile, **common_params
    )
    hgbt_quantile.fit(X_train, y_train)
    y_pred = hgbt_quantile.predict(X_test[first_week])

    predictions.append(y_pred)
    score = mean_pinball_loss(y_test[first_week], y_pred)
    ax.plot(
        y_pred[first_week],
        label=f"quantile={quantile}, pinball loss={score:.2f}",
        alpha=0.5,
    )

ax.fill_between(
    range(len(predictions[0][first_week])),
    predictions[0][first_week],
    predictions[1][first_week],
    color=colors[0],
    alpha=0.1,
)
ax.set(
    title="Daily energy transfer predictions with quantile loss",
    xticks=[(i + 0.2) * 48 for i in range(7)],
    xticklabels=["Mon", "Tue", "Wed", "Thu", "Fri", "Sat", "Sun"],
    xlabel="Time of the week",
    ylabel="Normalized energy transfer",
)
_ = ax.legend(loc="lower right")

Мы наблюдаем тенденцию к переоценке передачи энергии. Это можно количественно подтвердить, вычислив эмпирические показатели охвата, как это делается в разделе калибровка доверительных интервалов. Имейте в виду, что предсказанные перцентили — это всего лишь оценки от модели. Качество таких оценок можно улучшить, выполнив:
- собрать больше точек данных;
- лучше настроить гиперпараметры модели, см. Интервалы прогнозов для регрессии градиентного бустинга;
- создать более предсказуемые признаки из тех же данных, см. Инженерия признаков, связанных со временем.
Монотонные ограничения
В случае, когда известны особенности предметной области, требующие, чтобы взаимосвязь между признаком и целевой переменной была монотонно возрастающей или убывающей, можно применить такие ограничения в прогнозах модели HGBT, что делает модель более интерпретируемой и может уменьшить ее дисперсию (и потенциально смягчить переобучение) ценой увеличения смещения. Монотонные ограничения также могут использоваться для соблюдения определенных нормативных требований, обеспечения соответствия и согласования с этическими соображениями.
В данном примере политика передачи энергии с Виктории в Новый Южный Уэльс направлена на смягчение колебаний цен, что означает, что прогнозы модели должны обеспечить данную цель, то есть передача должна увеличиваться с ценой и спросом в Новом Южном Уэльсе, но также уменьшаться с ценой и спросом в Виктории, чтобы принести пользу обеим популяциям.
Если имена признаков в обучающей выборке имеются, то можно указать монотонные ограничения, передав словарь с соглашением:
- 1: монотонно возрастает
- 0: без ограничений
- -1: монотонно убывает
В качестве альтернативы можно передать объект-массив, кодирующий вышеупомянутое соглашение по позициям.
from sklearn.inspection import PartialDependenceDisplay

monotonic_cst = {
    "date": 0,
    "day": 0,
    "period": 0,
    "nswdemand": 1,
    "nswprice": 1,
    "vicdemand": -1,
    "vicprice": -1,
}
hgbt_no_cst = HistGradientBoostingRegressor(
    categorical_features=None, random_state=42
).fit(X, y)
hgbt_cst = HistGradientBoostingRegressor(
    monotonic_cst=monotonic_cst, categorical_features=None, random_state=42
).fit(X, y)

fig, ax = plt.subplots(nrows=2, figsize=(15, 10))
disp = PartialDependenceDisplay.from_estimator(
    hgbt_no_cst,
    X,
    features=["nswdemand", "nswprice"],
    line_kw={"linewidth": 2, "label": "unconstrained", "color": "tab:blue"},
    ax=ax[0],
)
PartialDependenceDisplay.from_estimator(
    hgbt_cst,
    X,
    features=["nswdemand", "nswprice"],
    line_kw={"linewidth": 2, "label": "constrained", "color": "tab:orange"},
    ax=disp.axes_,
)
disp = PartialDependenceDisplay.from_estimator(
    hgbt_no_cst,
    X,
    features=["vicdemand", "vicprice"],
    line_kw={"linewidth": 2, "label": "unconstrained", "color": "tab:blue"},
    ax=ax[1],
)
PartialDependenceDisplay.from_estimator(
    hgbt_cst,
    X,
    features=["vicdemand", "vicprice"],
    line_kw={"linewidth": 2, "label": "constrained", "color": "tab:orange"},
    ax=disp.axes_,
)
_ = plt.legend()

Обратите внимание, что nswdemand и vicdemand, по-видимому, уже монотонны без ограничений. Это хороший пример, показывающий, что модель с монотонными ограничениями «слишком ограничивает».
Кроме того, мы можем проверить, что качество прогнозирования модели не значительно ухудшается при внедрении монотонных ограничений. Для этой цели мы используем TimeSeriesSplit кросс-валидацию для оценки дисперсии тестовой оценки. При этом мы гарантируем, что обучающая выборка не предшествует тестовой выборке, что имеет решающее значение при работе с данными, имеющими временные отношения.
from sklearn.metrics import make_scorer, root_mean_squared_error
from sklearn.model_selection import TimeSeriesSplit, cross_validate

ts_cv = TimeSeriesSplit(n_splits=5, gap=48, test_size=336)  # a week has 336 samples
scorer = make_scorer(root_mean_squared_error)

cv_results = cross_validate(hgbt_no_cst, X, y, cv=ts_cv, scoring=scorer)
rmse = cv_results["test_score"]
print(f"RMSE without constraints = {rmse.mean():.3f} +/- {rmse.std():.3f}")

cv_results = cross_validate(hgbt_cst, X, y, cv=ts_cv, scoring=scorer)
rmse = cv_results["test_score"]
print(f"RMSE with constraints    = {rmse.mean():.3f} +/- {rmse.std():.3f}")
RMSE without constraints = 0.103 +/- 0.030
RMSE with constraints    = 0.107 +/- 0.034
При этом следует отметить, что сравнение проводится между двумя различными моделями, которые могут быть оптимизированы различной комбинацией гиперпараметров. Вот почему в этом разделе мы не используем common_params, как это делалось ранее.
Общее время выполнения сценария: (0 минут 21,334 секунды)


Связанные примеры


© 2007–2025 The scikit-learn developers
Licensed under the 3-clause BSD License.
https://scikit-learn.org/1.6/auto_examples/ensemble/plot_hgbt_regression.html


