Примечание
Перейти к концу для скачивания полного примера кода. Или запустить этот пример в браузере с помощью JupyterLite или Binder
Сравнение алгоритмов обнаружения аномалий для выявления выбросов на наборах данных игрушечного типа
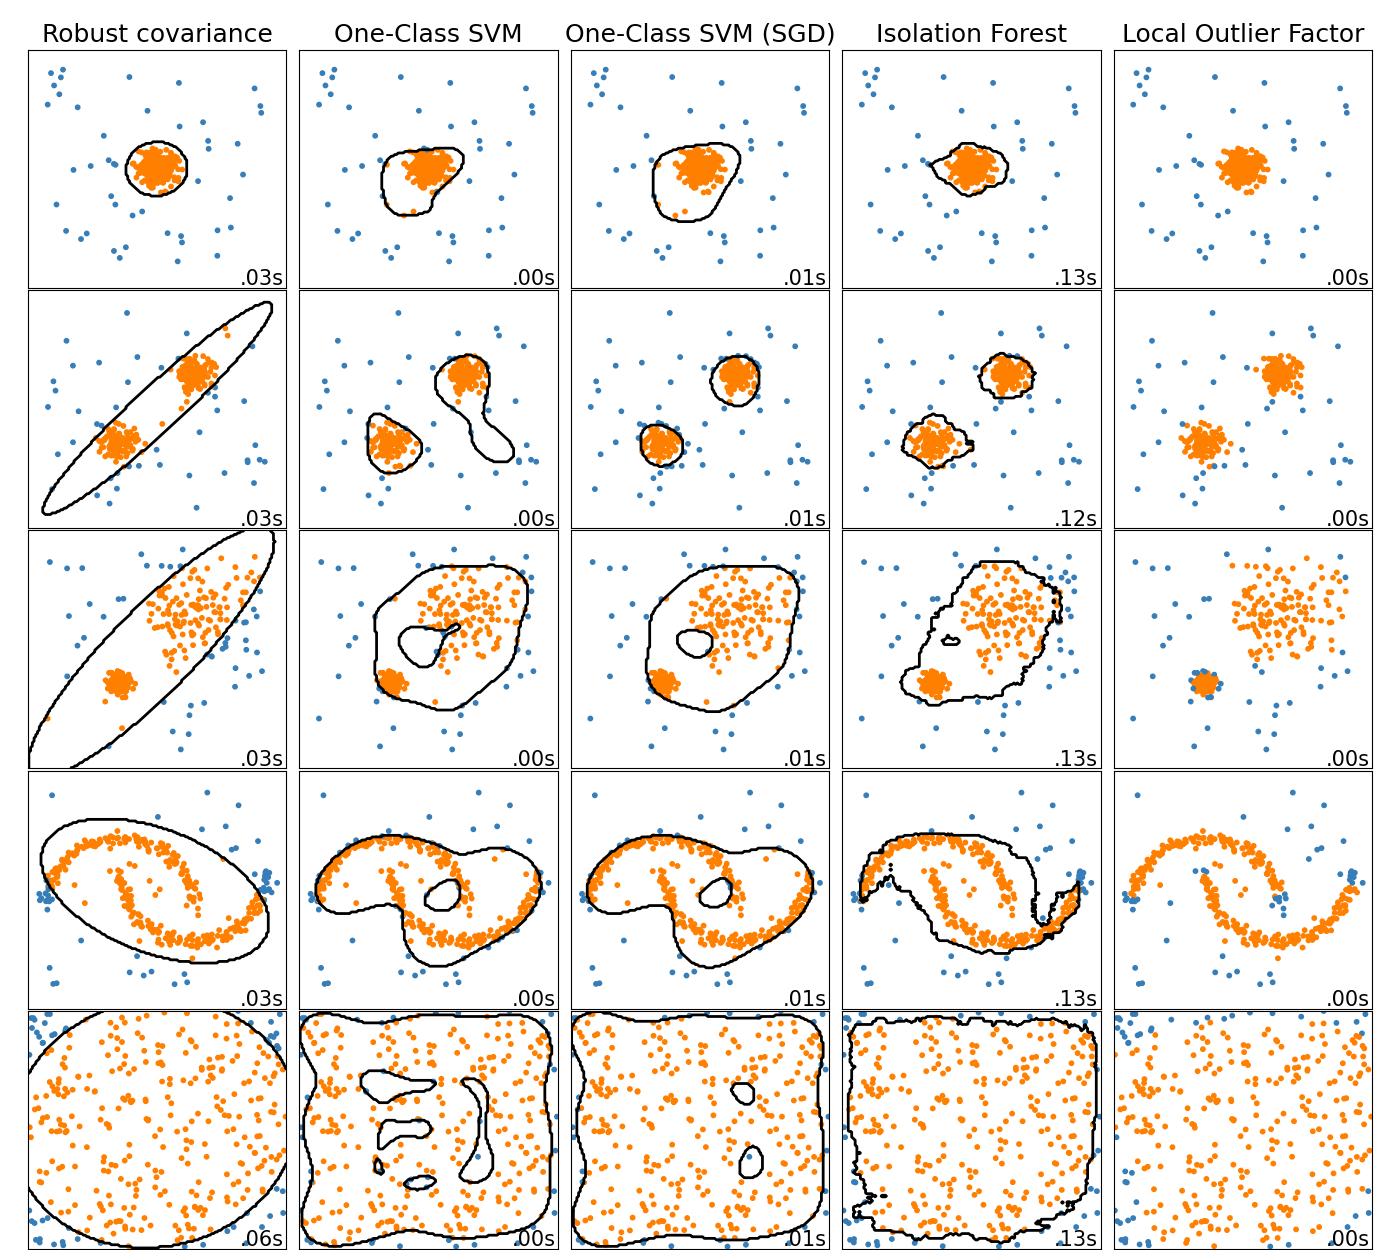
В этом примере показаны характеристики различных алгоритмов обнаружения аномалий на наборах данных в двух измерениях. Наборы данных содержат одну или две моды (области высокой плотности), чтобы проиллюстрировать способность алгоритмов справляться с многомодальными данными.
Для каждого набора данных 15% образцов генерируются как случайный равномерный шум. Эта доля является значением параметра nu для OneClassSVM и параметра contamination для других алгоритмов обнаружения выбросов. Границы решений между инлайнерами и выбросами отображаются черным цветом, за исключением Local Outlier Factor (LOF), так как он не имеет метода predict, который можно применить к новым данным при использовании для обнаружения выбросов.
Известно, что OneClassSVM чувствителен к выбросам, и поэтому не работает очень хорошо для выявления выбросов. Этот оценщик лучше всего подходит для обнаружения новинок, когда обучающая выборка не загрязнена выбросами. Тем не менее, обнаружение выбросов в высокомерных пространствах или без каких-либо предположений о распределении данных инлайнеров является очень сложной задачей, и одноклассовая SVM может давать полезные результаты в этих ситуациях, в зависимости от значений её гиперпараметров.
sklearn.linear_model.SGDOneClassSVM является реализацией одноклассовой SVM, основанной на стохастическом градиентном спуске (SGD). В сочетании с приближением ядер этот оценщик может использоваться для приближения решения керализованной sklearn.svm.OneClassSVM. Мы отмечаем, что, хотя и не идентичны, границы решений для sklearn.linear_model.SGDOneClassSVM и одноклассовой SVM очень похожи. Основным преимуществом использования sklearn.linear_model.SGDOneClassSVM является то, что он масштабируется линейно с количеством образцов.
sklearn.covariance.EllipticEnvelope предполагает, что данные являются гауссовыми, и вычисляет эллипс. Таким образом, он ухудшается, когда данные не являются одномодальными. Однако обратите внимание, что этот оценщик устойчив к выбросам.
IsolationForest и LocalOutlierFactor кажутся достаточно эффективными для наборов данных с несколькими модами. Преимущество LocalOutlierFactor по сравнению с другими оценщиками показано для третьего набора данных, где две моды имеют различную плотность. Это преимущество объясняется локальным характером LOF, что означает, что он сравнивает оценку аномальности одного образца только с оценками его соседей.
Наконец, для последнего набора данных сложно сказать, что один образец более аномален, чем другой, поскольку они равномерно распределены в гиперкубе. За исключением OneClassSVM, который немного переобучивается, все оценщики предоставляют приемлемые решения для этой ситуации. В таком случае было бы разумно более внимательно рассмотреть оценки аномальности образцов, так как хороший оценщик должен присваивать подобные оценки всем образцам.
Хотя эти примеры дают некоторое представление об алгоритмах, это представление может не относиться к данным очень высокой размерности.
Наконец, обратите внимание, что параметры моделей здесь подобраны вручную, но на практике их необходимо корректировать. В отсутствие помеченных данных проблема полностью неконтролируема, поэтому выбор модели может быть сложной задачей.
# Authors: The scikit-learn developers
# SPDX-License-Identifier: BSD-3-Clause

import time

import matplotlib
import matplotlib.pyplot as plt
import numpy as np

from sklearn import svm
from sklearn.covariance import EllipticEnvelope
from sklearn.datasets import make_blobs, make_moons
from sklearn.ensemble import IsolationForest
from sklearn.kernel_approximation import Nystroem
from sklearn.linear_model import SGDOneClassSVM
from sklearn.neighbors import LocalOutlierFactor
from sklearn.pipeline import make_pipeline

matplotlib.rcParams["contour.negative_linestyle"] = "solid"

# Example settings
n_samples = 300
outliers_fraction = 0.15
n_outliers = int(outliers_fraction * n_samples)
n_inliers = n_samples - n_outliers

# define outlier/anomaly detection methods to be compared.
# the SGDOneClassSVM must be used in a pipeline with a kernel approximation
# to give similar results to the OneClassSVM
anomaly_algorithms = [
    (
        "Robust covariance",
        EllipticEnvelope(contamination=outliers_fraction, random_state=42),
    ),
    ("One-Class SVM", svm.OneClassSVM(nu=outliers_fraction, kernel="rbf", gamma=0.1)),
    (
        "One-Class SVM (SGD)",
        make_pipeline(
            Nystroem(gamma=0.1, random_state=42, n_components=150),
            SGDOneClassSVM(
                nu=outliers_fraction,
                shuffle=True,
                fit_intercept=True,
                random_state=42,
                tol=1e-6,
            ),
        ),
    ),
    (
        "Isolation Forest",
        IsolationForest(contamination=outliers_fraction, random_state=42),
    ),
    (
        "Local Outlier Factor",
        LocalOutlierFactor(n_neighbors=35, contamination=outliers_fraction),
    ),
]

# Define datasets
blobs_params = dict(random_state=0, n_samples=n_inliers, n_features=2)
datasets = [
    make_blobs(centers=[[0, 0], [0, 0]], cluster_std=0.5, **blobs_params)[0],
    make_blobs(centers=[[2, 2], [-2, -2]], cluster_std=[0.5, 0.5], **blobs_params)[0],
    make_blobs(centers=[[2, 2], [-2, -2]], cluster_std=[1.5, 0.3], **blobs_params)[0],
    4.0
    * (
        make_moons(n_samples=n_samples, noise=0.05, random_state=0)[0]
        - np.array([0.5, 0.25])
    ),
    14.0 * (np.random.RandomState(42).rand(n_samples, 2) - 0.5),
]

# Compare given classifiers under given settings
xx, yy = np.meshgrid(np.linspace(-7, 7, 150), np.linspace(-7, 7, 150))

plt.figure(figsize=(len(anomaly_algorithms) * 2 + 4, 12.5))
plt.subplots_adjust(
    left=0.02, right=0.98, bottom=0.001, top=0.96, wspace=0.05, hspace=0.01
)

plot_num = 1
rng = np.random.RandomState(42)

for i_dataset, X in enumerate(datasets):
    # Add outliers
    X = np.concatenate([X, rng.uniform(low=-6, high=6, size=(n_outliers, 2))], axis=0)

    for name, algorithm in anomaly_algorithms:
        t0 = time.time()
        algorithm.fit(X)
        t1 = time.time()
        plt.subplot(len(datasets), len(anomaly_algorithms), plot_num)
        if i_dataset == 0:
            plt.title(name, size=18)

        # fit the data and tag outliers
        if name == "Local Outlier Factor":
            y_pred = algorithm.fit_predict(X)
        else:
            y_pred = algorithm.fit(X).predict(X)

        # plot the levels lines and the points
        if name != "Local Outlier Factor":  # LOF does not implement predict
            Z = algorithm.predict(np.c_[xx.ravel(), yy.ravel()])
            Z = Z.reshape(xx.shape)
            plt.contour(xx, yy, Z, levels=[0], linewidths=2, colors="black")

        colors = np.array(["#377eb8", "#ff7f00"])
        plt.scatter(X[:, 0], X[:, 1], s=10, color=colors[(y_pred + 1) // 2])

        plt.xlim(-7, 7)
        plt.ylim(-7, 7)
        plt.xticks(())
        plt.yticks(())
        plt.text(
            0.99,
            0.01,
            ("%.2fs" % (t1 - t0)).lstrip("0"),
            transform=plt.gca().transAxes,
            size=15,
            horizontalalignment="right",
        )
        plot_num += 1

plt.show()
Общее время выполнения скрипта: (0 минут 3.779 секунды)


Связанные примеры


© 2007–2025 The scikit-learn developers
Licensed under the 3-clause BSD License.
https://scikit-learn.org/1.6/auto_examples/miscellaneous/plot_anomaly_comparison.html


