Примечание
Перейти в конец для скачивания полного примера кода. или для запуска этого примера в вашем браузере через JupyterLite или Binder
Класс отношений правдоподобия для оценки производительности классификации
В этом примере демонстрируется функция class_likelihood_ratios, которая вычисляет положительные и отрицательные отношения правдоподобия (LR+, LR-), чтобы оценить предсказательную силу бинарного классификатора. Как мы увидим, эти метрики независимы от пропорции между классами в тестовом наборе, что делает их очень полезными, когда доступные данные для исследования имеют другую пропорцию классов, чем целевое применение.
Типичным случаем является исследование по типу «случай-контроль» в медицине, где классы почти сбалансированы, в то время как в общей популяции наблюдается сильный дисбаланс классов. В таком применении предварительная вероятность того, что у человека есть целевое состояние, может быть выбрана в качестве распространённости, то есть пропорции конкретной популяции, страдающей от медицинского состояния. Последующие вероятности представляют собой тогда вероятность того, что состояние действительно присутствует, учитывая положительный результат теста.
В этом примере мы сначала обсудим связь между предварительными и последующими шансами, определяемыми Отношения правдоподобия классов. Затем мы оценим их поведение в некоторых контролируемых сценариях. В последнем разделе мы построим их как функцию распространённости положительного класса.
# Authors: The scikit-learn developers
# SPDX-License-Identifier: BSD-3-Clause
Анализ предварительных и последующих тестов
Предположим, что у нас есть группа испытуемых с физиологическими измерениями X которые, надеемся, будут служить косвенными биомаркерами заболевания и фактическими показателями заболевания y (истинные значения). Большинство людей в популяции не имеют заболевания, но меньшинство (в данном случае около 10%) страдают от него:
from sklearn.datasets import make_classification

X, y = make_classification(n_samples=10_000, weights=[0.9, 0.1], random_state=0)
print(f"Percentage of people carrying the disease: {100*y.mean():.2f}%")
Percentage of people carrying the disease: 10.37%
Создаётся модель машинного обучения, чтобы диагностировать, вероятно ли, что человек с некоторыми заданными физиологическими измерениями будет иметь интересующее нас заболевание. Для оценки модели нам нужно оценить её производительность на отдельном тестовом наборе:
from sklearn.model_selection import train_test_split

X_train, X_test, y_train, y_test = train_test_split(X, y, random_state=0)
Затем мы можем обучить нашу диагностическую модель и вычислить положительное отношение правдоподобия, чтобы оценить полезность этого классификатора как инструмента диагностики заболеваний:
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import class_likelihood_ratios

estimator = LogisticRegression().fit(X_train, y_train)
y_pred = estimator.predict(X_test)
pos_LR, neg_LR = class_likelihood_ratios(y_test, y_pred)
print(f"LR+: {pos_LR:.3f}")
LR+: 12.617
Поскольку положительное отношение правдоподобия значительно больше 1,0, это означает, что инструмент диагностики на основе машинного обучения полезен: последующие шансы того, что состояние действительно присутствует, учитывая положительный результат теста, более чем в 12 раз превышают предварительные шансы.
Перекрёстная проверка отношений правдоподобия
Мы оцениваем изменчивость показателей для отношений правдоподобия классов в некоторых конкретных случаях.
import pandas as pd


def scoring(estimator, X, y):
    y_pred = estimator.predict(X)
    pos_lr, neg_lr = class_likelihood_ratios(y, y_pred, raise_warning=False)
    return {"positive_likelihood_ratio": pos_lr, "negative_likelihood_ratio": neg_lr}


def extract_score(cv_results):
    lr = pd.DataFrame(
        {
            "positive": cv_results["test_positive_likelihood_ratio"],
            "negative": cv_results["test_negative_likelihood_ratio"],
        }
    )
    return lr.aggregate(["mean", "std"])
Сначала мы проверим модель LogisticRegression с параметрами по умолчанию, как использовалось в предыдущем разделе.
from sklearn.model_selection import cross_validate

estimator = LogisticRegression()
extract_score(cross_validate(estimator, X, y, scoring=scoring, cv=10))
Мы подтверждаем, что модель полезна: последующие шансы в 12-20 раз превышают предварительные шансы.
Напротив, давайте рассмотрим модель-фиктив, которая будет выдавать случайные прогнозы с такими же шансами, как средняя распространённость заболевания в обучающей выборке:
from sklearn.dummy import DummyClassifier

estimator = DummyClassifier(strategy="stratified", random_state=1234)
extract_score(cross_validate(estimator, X, y, scoring=scoring, cv=10))
Здесь оба отношения правдоподобия классов близки к 1,0, что делает этот классификатор бесполезным как диагностический инструмент для улучшения выявления заболевания.
Другой вариант для фиктивной модели — всегда предсказывать наиболее частый класс, в данном случае «нет заболевания».
estimator = DummyClassifier(strategy="most_frequent")
extract_score(cross_validate(estimator, X, y, scoring=scoring, cv=10))
Отсутствие положительных предсказаний означает, что не будет истинно положительных и ложноположительных результатов, что приводит к неопределённому значению LR+, которое ни в коем случае не следует интерпретировать как бесконечное LR+ (классификатор идеально определяет положительные случаи). В такой ситуации функция class_likelihood_ratios возвращает nan и по умолчанию выводит предупреждение. Действительно, значение LR- помогает нам отбросить эту модель.
Аналогичная ситуация может возникнуть при перекрёстной проверке сильно несбалансированных данных с небольшим количеством образцов: некоторые подвыборки не будут содержать образцов заболевания, и поэтому они будут выдавать ноль истинно положительных и ложноотрицательных результатов при тестировании. Математически это приводит к бесконечному LR+, что также не следует интерпретировать как способность модели идеально определять положительные случаи. Такое событие приводит к увеличению дисперсии оценки отношений правдоподобия, но всё ещё может интерпретироваться как увеличение последующих шансов наличия состояния.
estimator = LogisticRegression()
X, y = make_classification(n_samples=300, weights=[0.9, 0.1], random_state=0)
extract_score(cross_validate(estimator, X, y, scoring=scoring, cv=10))
Независимость от распространенности
Коэффициенты правдоподобия не зависят от распространенности заболевания и могут быть экстраполированы между популяциями независимо от возможного дисбаланса классов, при условии, что к ним всем применяется одна и та же модель. Обратите внимание, что на графиках ниже линия раздела классов остается неизменной (см. SVM: Разделяющая гиперплоскость для несбалансированных классов для исследования линии разделения классов при несбалансированных классах).
Здесь мы обучаем базовая модель LogisticRegression на исследовании «случай-контроль» с распространенностью 50%. Затем она оценивается на популяциях с различной распространенностью. Мы используем функцию make_classification, чтобы гарантировать, что процесс генерации данных всегда одинаковый, как показано на графиках ниже. Метка 1 соответствует положительному классу «заболевание», а метка 0 соответствует классу «отсутствие заболевания».
from collections import defaultdict

import matplotlib.pyplot as plt
import numpy as np

from sklearn.inspection import DecisionBoundaryDisplay

populations = defaultdict(list)
common_params = {
    "n_samples": 10_000,
    "n_features": 2,
    "n_informative": 2,
    "n_redundant": 0,
    "random_state": 0,
}
weights = np.linspace(0.1, 0.8, 6)
weights = weights[::-1]

# fit and evaluate base model on balanced classes
X, y = make_classification(**common_params, weights=[0.5, 0.5])
estimator = LogisticRegression().fit(X, y)
lr_base = extract_score(cross_validate(estimator, X, y, scoring=scoring, cv=10))
pos_lr_base, pos_lr_base_std = lr_base["positive"].values
neg_lr_base, neg_lr_base_std = lr_base["negative"].values
Теперь мы покажем линию раздела классов для каждого уровня распространенности. Обратите внимание, что мы отображаем только подмножество исходных данных, чтобы лучше оценить линию раздела классов линейной модели.
fig, axs = plt.subplots(nrows=3, ncols=2, figsize=(15, 12))

for ax, (n, weight) in zip(axs.ravel(), enumerate(weights)):
    X, y = make_classification(
        **common_params,
        weights=[weight, 1 - weight],
    )
    prevalence = y.mean()
    populations["prevalence"].append(prevalence)
    populations["X"].append(X)
    populations["y"].append(y)

    # down-sample for plotting
    rng = np.random.RandomState(1)
    plot_indices = rng.choice(np.arange(X.shape[0]), size=500, replace=True)
    X_plot, y_plot = X[plot_indices], y[plot_indices]

    # plot fixed decision boundary of base model with varying prevalence
    disp = DecisionBoundaryDisplay.from_estimator(
        estimator,
        X_plot,
        response_method="predict",
        alpha=0.5,
        ax=ax,
    )
    scatter = disp.ax_.scatter(X_plot[:, 0], X_plot[:, 1], c=y_plot, edgecolor="k")
    disp.ax_.set_title(f"prevalence = {y_plot.mean():.2f}")
    disp.ax_.legend(*scatter.legend_elements())
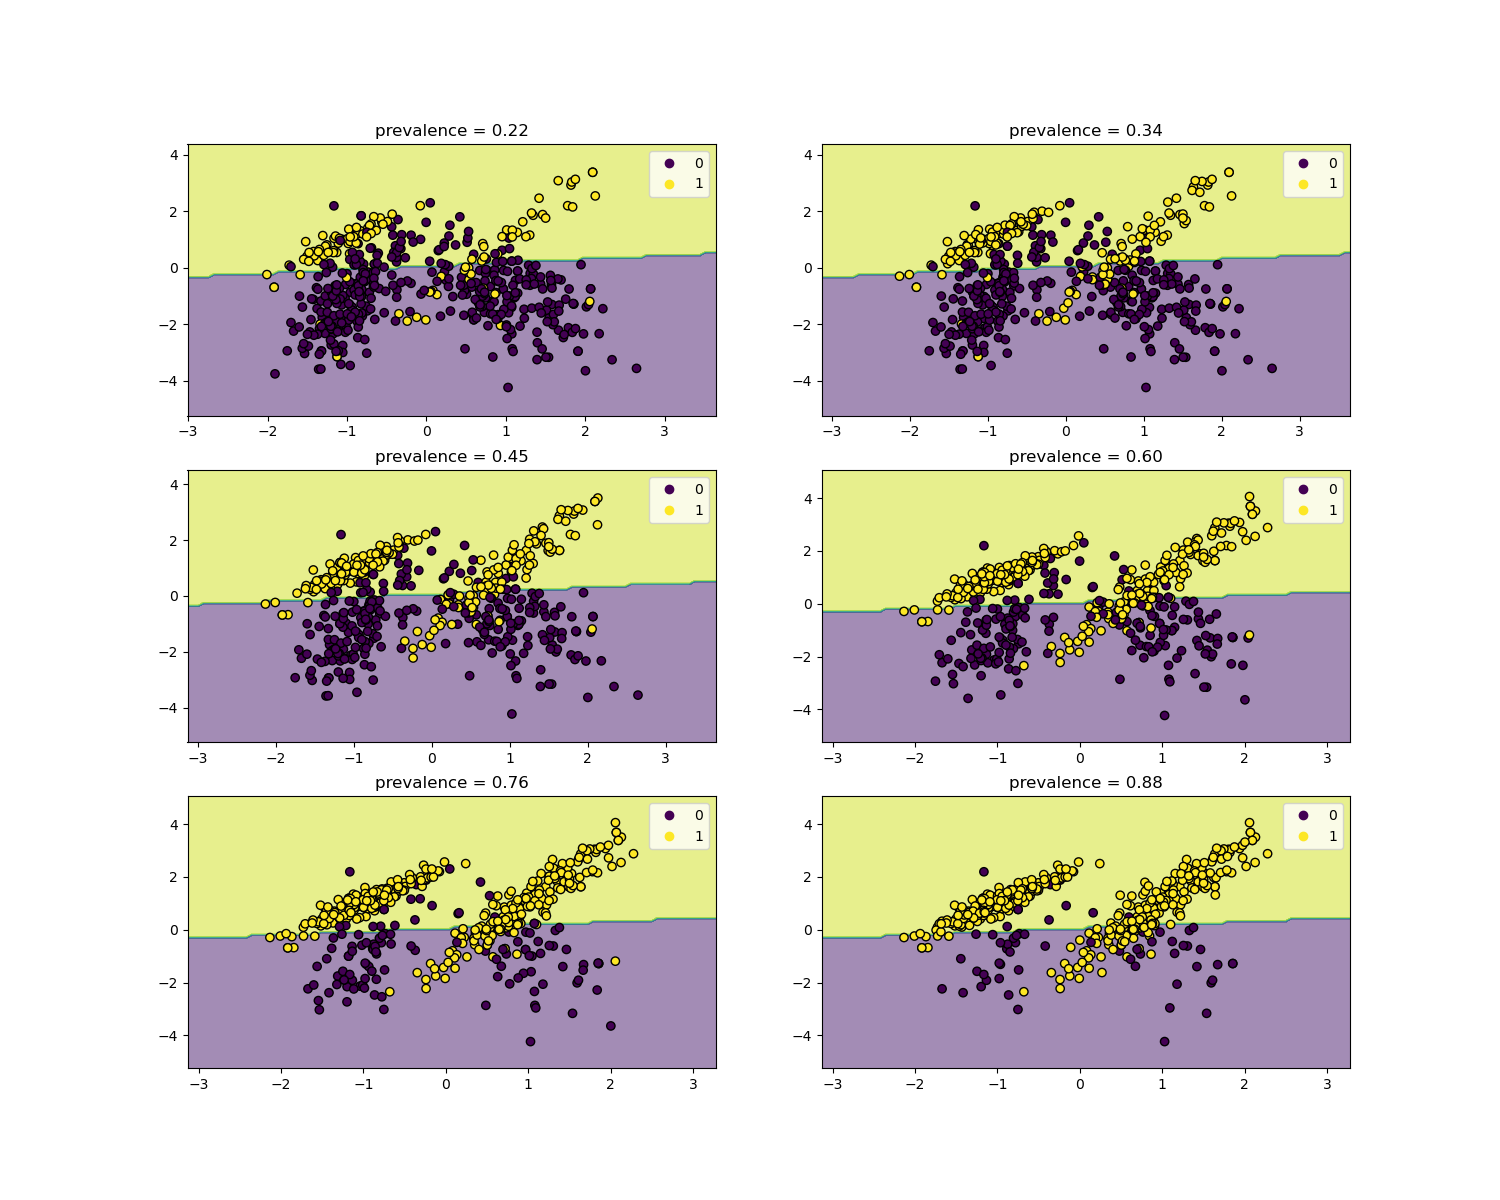
Мы определяем функцию для бутстрапинга.
def scoring_on_bootstrap(estimator, X, y, rng, n_bootstrap=100):
    results_for_prevalence = defaultdict(list)
    for _ in range(n_bootstrap):
        bootstrap_indices = rng.choice(
            np.arange(X.shape[0]), size=X.shape[0], replace=True
        )
        for key, value in scoring(
            estimator, X[bootstrap_indices], y[bootstrap_indices]
        ).items():
            results_for_prevalence[key].append(value)
    return pd.DataFrame(results_for_prevalence)
Мы оцениваем базовая модель для каждой распространенности, используя бутстрапинг.
results = defaultdict(list)
n_bootstrap = 100
rng = np.random.default_rng(seed=0)

for prevalence, X, y in zip(
    populations["prevalence"], populations["X"], populations["y"]
):
    results_for_prevalence = scoring_on_bootstrap(
        estimator, X, y, rng, n_bootstrap=n_bootstrap
    )
    results["prevalence"].append(prevalence)
    results["metrics"].append(
        results_for_prevalence.aggregate(["mean", "std"]).unstack()
    )

results = pd.DataFrame(results["metrics"], index=results["prevalence"])
results.index.name = "prevalence"
results
На графиках ниже мы видим, что коэффициенты правдоподобия классов, пересчитанные с различными значениями распространенности, действительно являются постоянными в пределах одного стандартного отклонения от тех, что были вычислены для сбалансированных классов.
fig, (ax1, ax2) = plt.subplots(nrows=1, ncols=2, figsize=(15, 6))
results["positive_likelihood_ratio"]["mean"].plot(
    ax=ax1, color="r", label="extrapolation through populations"
)
ax1.axhline(y=pos_lr_base + pos_lr_base_std, color="r", linestyle="--")
ax1.axhline(
    y=pos_lr_base - pos_lr_base_std,
    color="r",
    linestyle="--",
    label="base model confidence band",
)
ax1.fill_between(
    results.index,
    results["positive_likelihood_ratio"]["mean"]
    - results["positive_likelihood_ratio"]["std"],
    results["positive_likelihood_ratio"]["mean"]
    + results["positive_likelihood_ratio"]["std"],
    color="r",
    alpha=0.3,
)
ax1.set(
    title="Positive likelihood ratio",
    ylabel="LR+",
    ylim=[0, 5],
)
ax1.legend(loc="lower right")

ax2 = results["negative_likelihood_ratio"]["mean"].plot(
    ax=ax2, color="b", label="extrapolation through populations"
)
ax2.axhline(y=neg_lr_base + neg_lr_base_std, color="b", linestyle="--")
ax2.axhline(
    y=neg_lr_base - neg_lr_base_std,
    color="b",
    linestyle="--",
    label="base model confidence band",
)
ax2.fill_between(
    results.index,
    results["negative_likelihood_ratio"]["mean"]
    - results["negative_likelihood_ratio"]["std"],
    results["negative_likelihood_ratio"]["mean"]
    + results["negative_likelihood_ratio"]["std"],
    color="b",
    alpha=0.3,
)
ax2.set(
    title="Negative likelihood ratio",
    ylabel="LR-",
    ylim=[0, 0.5],
)
ax2.legend(loc="lower right")

plt.show()

Общее время выполнения скрипта: (0 минут 2,139 секунды)


Связанные примеры


© 2007–2025 The scikit-learn developers
Licensed under the 3-clause BSD License.
https://scikit-learn.org/1.6/auto_examples/model_selection/plot_likelihood_ratios.html


