Примечание
Перейти к концу для скачивания полного кода примера. или для запуска этого примера в вашем браузере через JupyterLite или Binder
Сравнение эффекта различных масштабирующих преобразователей на данные с выбросами
Признаки 0 (медианный доход в квартале) и 5 (средняя заполняемость домов) набора данных California Housing dataset имеют очень разные масштабы и содержат некоторые очень большие выбросы. Эти две характеристики приводят к трудностям при визуализации данных и, что более важно, могут ухудшить предсказательную производительность многих алгоритмов машинного обучения. Немасштабированные данные также могут замедлить или даже предотвратить сходимость многих оценок, основанных на градиенте.
Действительно, многие оценки разработаны с предположением, что каждое значение признака близко к нулю, или, что еще важнее, что все признаки изменяются в сравнимых масштабах. В частности, оценки, основанные на метрике и градиенте, часто предполагают приблизительно стандартизированные данные (центрированные признаки с единичными дисперсиями). Заметным исключением являются оценки, основанные на деревьях решений, которые устойчивы к произвольному масштабированию данных.
В этом примере используются различные масштабирующие преобразователи, для того чтобы привести данные в заранее заданный диапазон.
Масштабирующие преобразователи являются линейными (или, точнее, аффинными) и отличаются друг от друга способом, которым они оценивают параметры, используемые для сдвига и масштабирования каждого признака.
QuantileTransformer обеспечивает нелинейные преобразования, в которых расстояния между крайними выбросами и инлинерами сжимаются. PowerTransformer обеспечивает нелинейные преобразования, в которых данные отображаются на нормальное распределение для стабилизации дисперсии и минимизации скошенности.
В отличие от предыдущих преобразований, нормализация относится к преобразованию по образцу, а не по признаку.
Следующий код немного громоздкий, можете перейти непосредственно к анализу результатов.
# Authors: The scikit-learn developers
# SPDX-License-Identifier: BSD-3-Clause

import matplotlib as mpl
import numpy as np
from matplotlib import cm
from matplotlib import pyplot as plt

from sklearn.datasets import fetch_california_housing
from sklearn.preprocessing import (
    MaxAbsScaler,
    MinMaxScaler,
    Normalizer,
    PowerTransformer,
    QuantileTransformer,
    RobustScaler,
    StandardScaler,
    minmax_scale,
)

dataset = fetch_california_housing()
X_full, y_full = dataset.data, dataset.target
feature_names = dataset.feature_names

feature_mapping = {
    "MedInc": "Median income in block",
    "HouseAge": "Median house age in block",
    "AveRooms": "Average number of rooms",
    "AveBedrms": "Average number of bedrooms",
    "Population": "Block population",
    "AveOccup": "Average house occupancy",
    "Latitude": "House block latitude",
    "Longitude": "House block longitude",
}

# Take only 2 features to make visualization easier
# Feature MedInc has a long tail distribution.
# Feature AveOccup has a few but very large outliers.
features = ["MedInc", "AveOccup"]
features_idx = [feature_names.index(feature) for feature in features]
X = X_full[:, features_idx]
distributions = [
    ("Unscaled data", X),
    ("Data after standard scaling", StandardScaler().fit_transform(X)),
    ("Data after min-max scaling", MinMaxScaler().fit_transform(X)),
    ("Data after max-abs scaling", MaxAbsScaler().fit_transform(X)),
    (
        "Data after robust scaling",
        RobustScaler(quantile_range=(25, 75)).fit_transform(X),
    ),
    (
        "Data after power transformation (Yeo-Johnson)",
        PowerTransformer(method="yeo-johnson").fit_transform(X),
    ),
    (
        "Data after power transformation (Box-Cox)",
        PowerTransformer(method="box-cox").fit_transform(X),
    ),
    (
        "Data after quantile transformation (uniform pdf)",
        QuantileTransformer(
            output_distribution="uniform", random_state=42
        ).fit_transform(X),
    ),
    (
        "Data after quantile transformation (gaussian pdf)",
        QuantileTransformer(
            output_distribution="normal", random_state=42
        ).fit_transform(X),
    ),
    ("Data after sample-wise L2 normalizing", Normalizer().fit_transform(X)),
]

# scale the output between 0 and 1 for the colorbar
y = minmax_scale(y_full)

# plasma does not exist in matplotlib < 1.5
cmap = getattr(cm, "plasma_r", cm.hot_r)


def create_axes(title, figsize=(16, 6)):
    fig = plt.figure(figsize=figsize)
    fig.suptitle(title)

    # define the axis for the first plot
    left, width = 0.1, 0.22
    bottom, height = 0.1, 0.7
    bottom_h = height + 0.15
    left_h = left + width + 0.02

    rect_scatter = [left, bottom, width, height]
    rect_histx = [left, bottom_h, width, 0.1]
    rect_histy = [left_h, bottom, 0.05, height]

    ax_scatter = plt.axes(rect_scatter)
    ax_histx = plt.axes(rect_histx)
    ax_histy = plt.axes(rect_histy)

    # define the axis for the zoomed-in plot
    left = width + left + 0.2
    left_h = left + width + 0.02

    rect_scatter = [left, bottom, width, height]
    rect_histx = [left, bottom_h, width, 0.1]
    rect_histy = [left_h, bottom, 0.05, height]

    ax_scatter_zoom = plt.axes(rect_scatter)
    ax_histx_zoom = plt.axes(rect_histx)
    ax_histy_zoom = plt.axes(rect_histy)

    # define the axis for the colorbar
    left, width = width + left + 0.13, 0.01

    rect_colorbar = [left, bottom, width, height]
    ax_colorbar = plt.axes(rect_colorbar)

    return (
        (ax_scatter, ax_histy, ax_histx),
        (ax_scatter_zoom, ax_histy_zoom, ax_histx_zoom),
        ax_colorbar,
    )


def plot_distribution(axes, X, y, hist_nbins=50, title="", x0_label="", x1_label=""):
    ax, hist_X1, hist_X0 = axes

    ax.set_title(title)
    ax.set_xlabel(x0_label)
    ax.set_ylabel(x1_label)

    # The scatter plot
    colors = cmap(y)
    ax.scatter(X[:, 0], X[:, 1], alpha=0.5, marker="o", s=5, lw=0, c=colors)

    # Removing the top and the right spine for aesthetics
    # make nice axis layout
    ax.spines["top"].set_visible(False)
    ax.spines["right"].set_visible(False)
    ax.get_xaxis().tick_bottom()
    ax.get_yaxis().tick_left()
    ax.spines["left"].set_position(("outward", 10))
    ax.spines["bottom"].set_position(("outward", 10))

    # Histogram for axis X1 (feature 5)
    hist_X1.set_ylim(ax.get_ylim())
    hist_X1.hist(
        X[:, 1], bins=hist_nbins, orientation="horizontal", color="grey", ec="grey"
    )
    hist_X1.axis("off")

    # Histogram for axis X0 (feature 0)
    hist_X0.set_xlim(ax.get_xlim())
    hist_X0.hist(
        X[:, 0], bins=hist_nbins, orientation="vertical", color="grey", ec="grey"
    )
    hist_X0.axis("off")
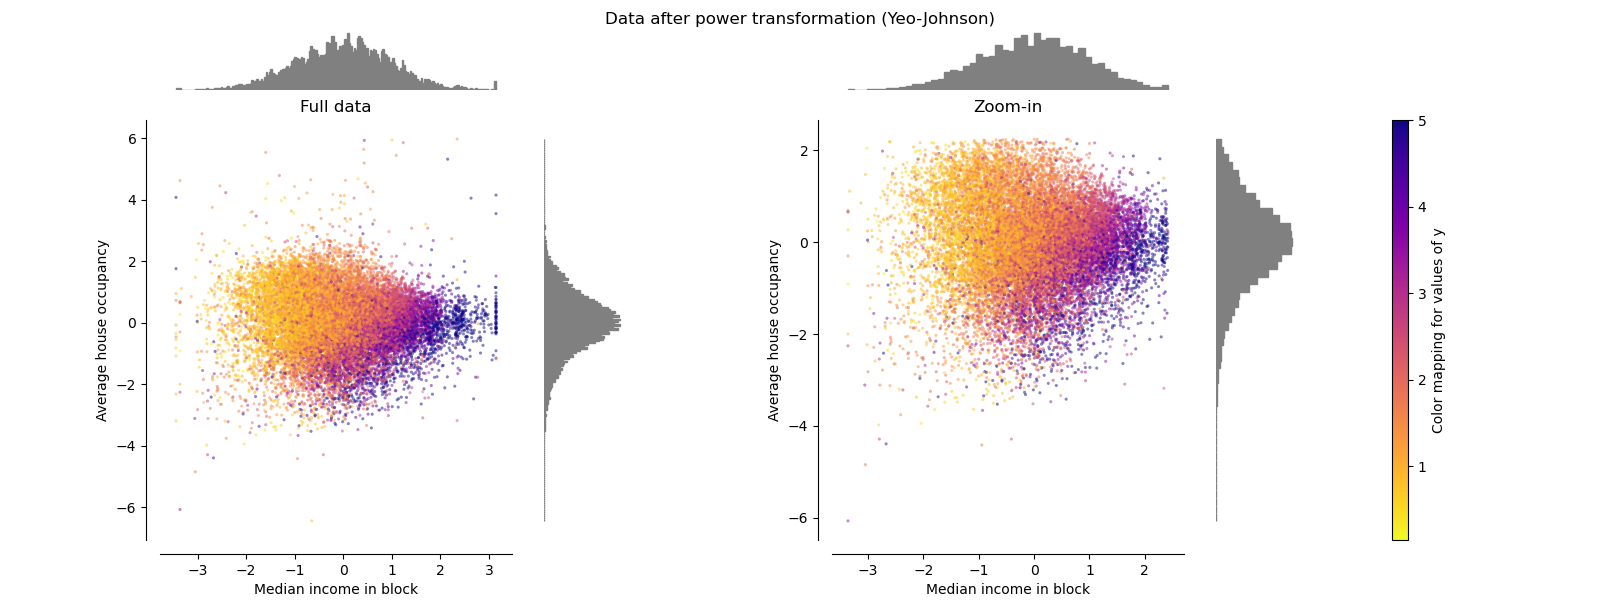
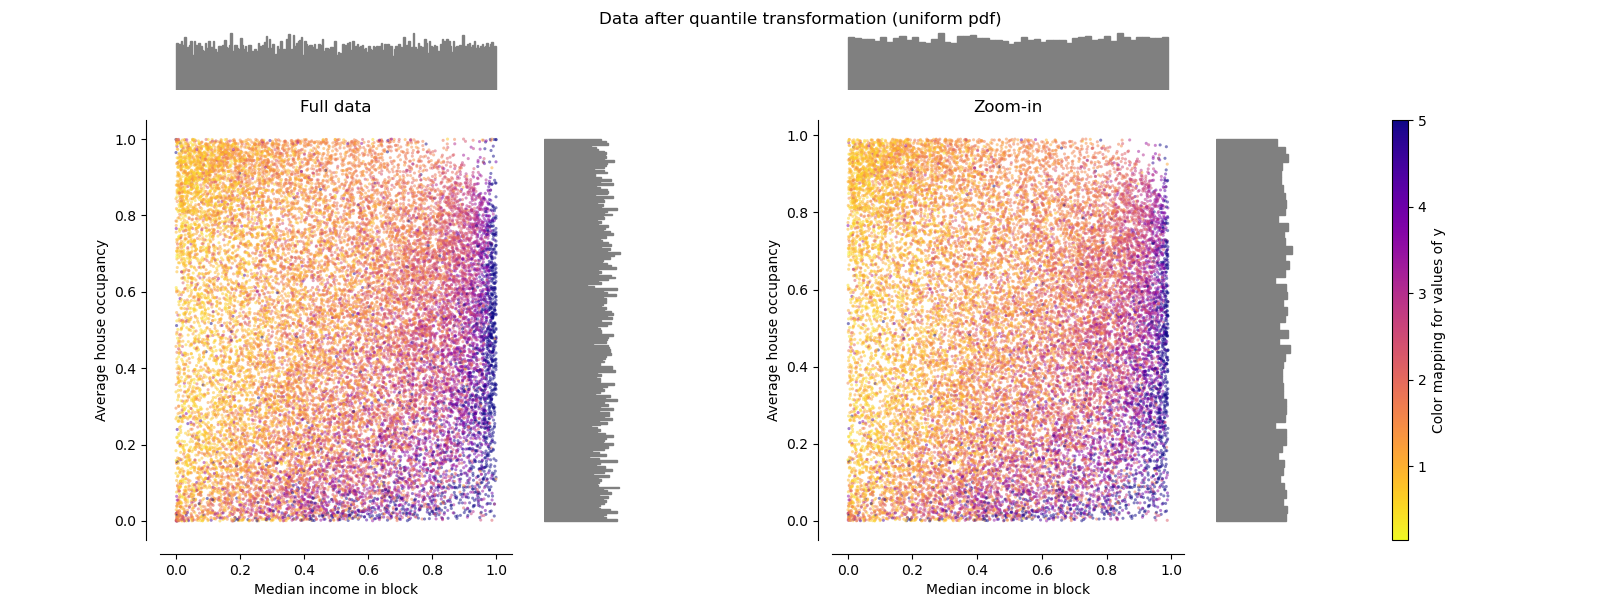
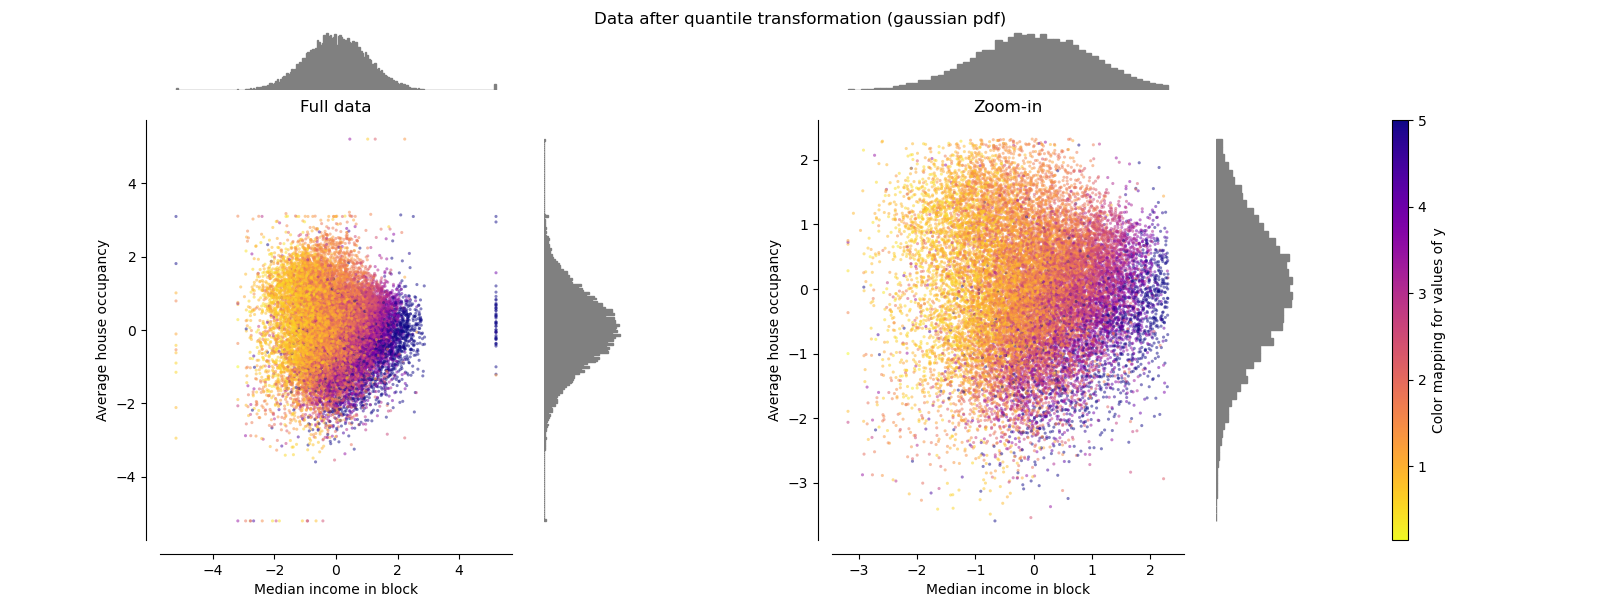
Будут показаны два графика для каждого масштабирующего/нормализующего/преобразующего преобразователя. Левый рисунок покажет диаграмму рассеяния всего набора данных, а правый — исключит крайние значения, учитывая только 99 % набора данных, исключая крайние выбросы. Кроме того, на графиках рассеяния по сторонам будут показаны предельные распределения для каждого признака.
def make_plot(item_idx):
    title, X = distributions[item_idx]
    ax_zoom_out, ax_zoom_in, ax_colorbar = create_axes(title)
    axarr = (ax_zoom_out, ax_zoom_in)
    plot_distribution(
        axarr[0],
        X,
        y,
        hist_nbins=200,
        x0_label=feature_mapping[features[0]],
        x1_label=feature_mapping[features[1]],
        title="Full data",
    )

    # zoom-in
    zoom_in_percentile_range = (0, 99)
    cutoffs_X0 = np.percentile(X[:, 0], zoom_in_percentile_range)
    cutoffs_X1 = np.percentile(X[:, 1], zoom_in_percentile_range)

    non_outliers_mask = np.all(X > [cutoffs_X0[0], cutoffs_X1[0]], axis=1) & np.all(
        X < [cutoffs_X0[1], cutoffs_X1[1]], axis=1
    )
    plot_distribution(
        axarr[1],
        X[non_outliers_mask],
        y[non_outliers_mask],
        hist_nbins=50,
        x0_label=feature_mapping[features[0]],
        x1_label=feature_mapping[features[1]],
        title="Zoom-in",
    )

    norm = mpl.colors.Normalize(y_full.min(), y_full.max())
    mpl.colorbar.ColorbarBase(
        ax_colorbar,
        cmap=cmap,
        norm=norm,
        orientation="vertical",
        label="Color mapping for values of y",
    )
Исходные данные
Каждое преобразование отображается, показывая два преобразованных признака, при этом левый график отображает весь набор данных, а правый увеличивает масштаб, чтобы показать набор данных без крайних выбросов. Большая часть образцов сжимается в определённый диапазон: [0, 10] для медианного дохода и [0, 6] для средней заполняемости домов. Обратите внимание, что есть некоторые крайние выбросы (некоторые кварталы имеют среднюю заполняемость более 1200). Поэтому, конкретная предобработка может быть очень полезна в зависимости от приложения. В дальнейшем мы представляем некоторые идеи и поведение этих методов предобработки при наличии крайних выбросов.
make_plot(0)

StandardScaler
StandardScaler удаляет среднее значение и масштабирует данные до единичной дисперсии. Масштабирование уменьшает диапазон значений признаков, как показано на левом графике ниже. Однако выбросы оказывают влияние при вычислении эмпирического среднего значения и стандартного отклонения. Обратите особое внимание, что поскольку выбросы по каждому признаку имеют разные величины, распространение преобразованных данных по каждому признаку очень различается: большая часть данных лежит в диапазоне [-2, 4] для преобразованного признака медианного дохода, в то время как те же данные сжаты в меньшем диапазоне [-0,2, 0,2] для преобразованной средней заполняемости домов.
StandardScaler поэтому не может гарантировать сбалансированные масштабы признаков в присутствии выбросов.
make_plot(1)

MinMaxScaler
MinMaxScaler масштабирует набор данных таким образом, что все значения признаков находятся в диапазоне [0, 1], как показано на правом графике ниже. Однако это масштабирование сжимает все инлинеры в узкий диапазон [0, 0,005] для преобразованной средней заполняемости домов.
И StandardScaler, и MinMaxScaler очень чувствительны к наличию выбросов.
make_plot(2)

MaxAbsScaler
MaxAbsScaler похож на MinMaxScaler, за исключением того, что значения отображаются в нескольких диапазонах в зависимости от того, присутствуют ли отрицательные ИЛИ положительные значения. Если присутствуют только положительные значения, диапазон составляет [0, 1]. Если присутствуют только отрицательные значения, диапазон составляет [-1, 0]. Если присутствуют и отрицательные, и положительные значения, диапазон составляет [-1, 1]. На данных только с положительными значениями оба MinMaxScaler и MaxAbsScaler ведут себя аналогично. MaxAbsScaler поэтому также страдает от наличия больших выбросов.
make_plot(3)

RobustScaler
В отличие от предыдущих масштабирующих преобразователей, статистические данные центрирования и масштабирования RobustScaler основаны на процентилях и поэтому не зависят от небольшого числа очень больших крайних выбросов. В результате, полученный диапазон преобразованных значений признаков больше, чем у предыдущих масштабирующих преобразователей, и, что более важно, они примерно одинаковы: для обоих признаков большинство преобразованных значений лежат в диапазоне [-2, 3], как видно на увеличенном графике. Обратите внимание, что сами выбросы всё ещё присутствуют в преобразованных данных. Если требуется отдельное удаление выбросов, необходимо выполнить нелинейное преобразование (см. ниже).
make_plot(4)

PowerTransformer
PowerTransformer применяет степенное преобразование к каждому признаку, чтобы сделать данные более похожими на гауссовы, чтобы стабилизировать дисперсию и минимизировать скошенность. В настоящее время поддерживаются преобразования Йео-Джонсона и Бокса-Кокса, а оптимальный масштабный коэффициент определяется с помощью оценки максимального правдоподобия в обоих методах. По умолчанию, PowerTransformer применяет нормализацию с нулевым средним и единичной дисперсией. Обратите внимание, что преобразование Бокса-Кокса может быть применено только к строго положительным данным. Доход и средняя заполняемость домов оказываются строго положительными, но если присутствуют отрицательные значения, предпочтительнее преобразованный Йео-Джонсона.
make_plot(5)
make_plot(6)

QuantileTransformer (равномерный выход)
QuantileTransformer применяет нелинейное преобразование, такое что функция плотности вероятности каждого признака будет отображаться на равномерное или гауссово распределение. В данном случае все данные, включая выбросы, будут отображаться на равномерное распределение с диапазоном [0, 1], что делает выбросы неотличимыми от инлинеров.
RobustScaler и QuantileTransformer устойчивы к выбросам в том смысле, что добавление или удаление выбросов в обучающем наборе приведет к приблизительно одинаковому преобразованию. Но в отличие от RobustScaler, QuantileTransformer также автоматически сжимает любой выброс, устанавливая их на заранее определённые граничные значения диапазона (0 и 1). Это может привести к артефактам насыщения для экстремальных значений.
make_plot(7)
QuantileTransformer (Гауссовский выход)
Для отображения на гауссовом распределении, установите параметр output_distribution='normal'.
make_plot(8)
Нормализующий преобразователь
Преобразователь Normalizer перемасштабирует вектор для каждого образца, чтобы получить единичную норму, независимо от распределения образцов. Это видно на обоих рисунках ниже, где все образцы отображаются на единичной окружности. В нашем примере две выбранные функции имеют только положительные значения; поэтому преобразованные данные лежат только в положительном квадранте. Это не так, если некоторые исходные функции имели смесь положительных и отрицательных значений.
make_plot(9)

plt.show()

Общее время выполнения скрипта: (0 минут 8.591 секунд)


Связанные примеры


© 2007–2025 The scikit-learn developers
Licensed under the 3-clause BSD License.
https://scikit-learn.org/1.6/auto_examples/preprocessing/plot_all_scaling.html


