Подпрограммы и каналы — учебное пособие
В этом учебном пособии вы узнаете, как использовать подпрограммы в IntelliJ IDEA для выполнения сетевых запросов без блокировки потока или обратных вызовов.
Вы узнаете:
Зачем и как использовать приостанавливающие функции для выполнения сетевых запросов.
Как отправлять запросы одновременно, используя подпрограммы.
Как обмениваться информацией между различными подпрограммами, используя каналы.
Для сетевых запросов вам понадобится библиотека Retrofit, но подход, показанный в этом учебном пособии, аналогичен для других библиотек, поддерживающих подпрограммы.
Перед началом
Загрузите и установите последнюю версию IntelliJ IDEA.
-
Скопируйте шаблон проекта шаблон проекта, выбрав Получить из VCS на экране «Добро пожаловать» или выбрав Файл | Новый | Проект из системы контроля версий.
Вы также можете скопировать его из командной строки:
git clone https://github.com/kotlin-hands-on/intro-coroutines
Генерация токена разработчика GitHub
В проекте вы будете использовать API GitHub. Для получения доступа укажите имя вашей учетной записи GitHub и пароль или токен. Если у вас включена двухфакторная аутентификация, токена будет достаточно.
Сгенерируйте новый токен GitHub для использования API GitHub со своей учетной записью:
-
Укажите имя токена, например,
coroutines-tutorial: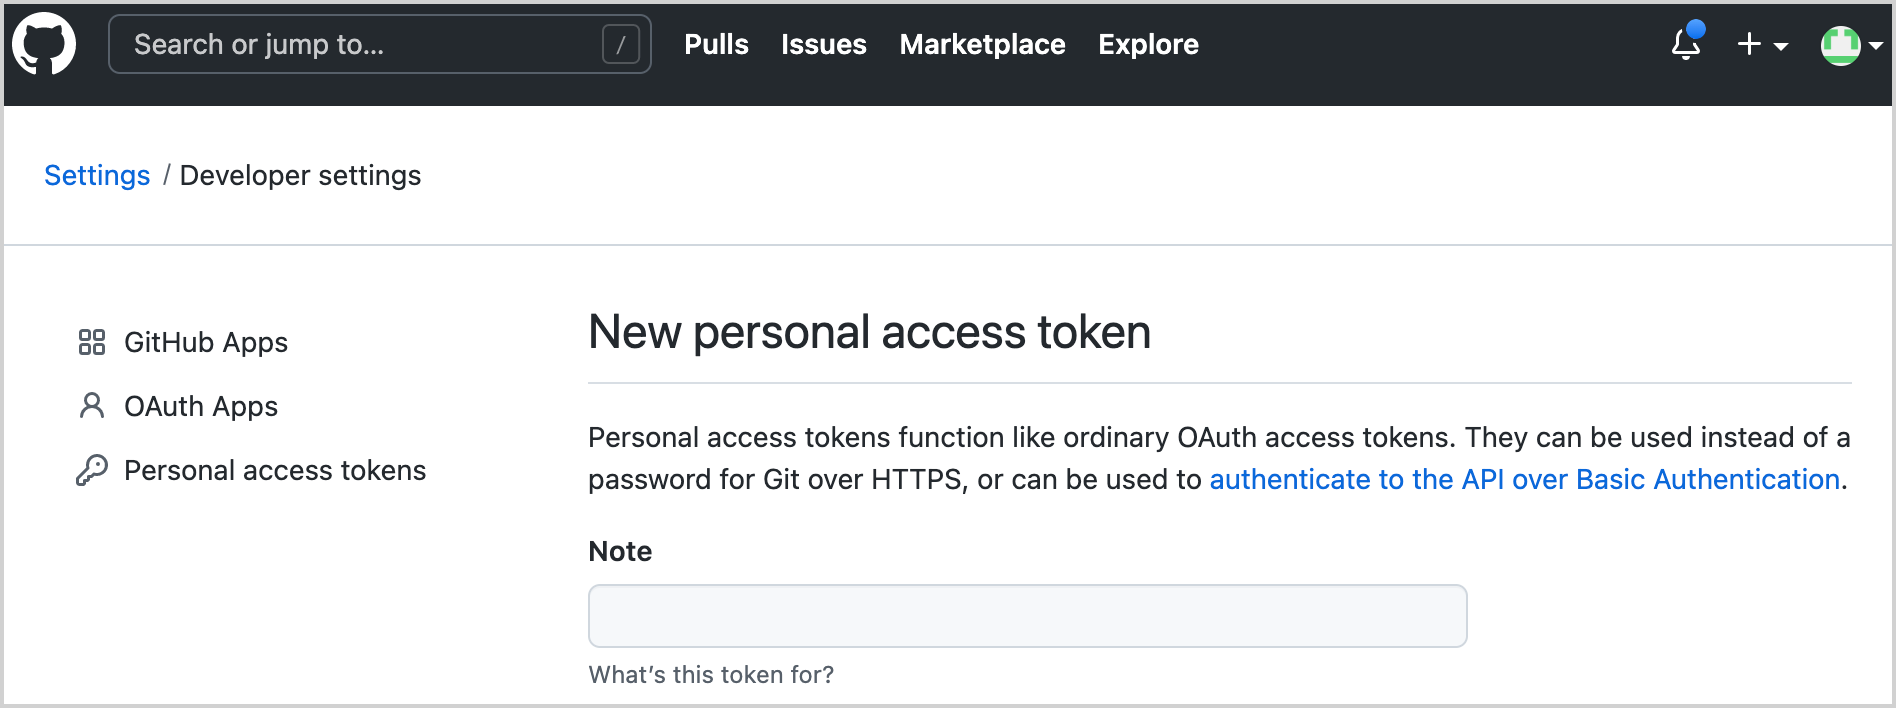
Не выбирайте никакие области. Нажмите Создать токен в нижней части страницы.
Скопируйте сгенерированный токен.
Запуск кода
Программа загружает информацию о всех участниках репозиториев заданной организации (по умолчанию «kotlin»). Позже вы добавите логику для сортировки пользователей по количеству их вкладов.
-
Откройте файл
src/contributors/main.ktи запустите функциюmain(). Вы увидите следующее окно:
Если шрифт слишком мелкий, измените его размер, изменив значение
setDefaultFontSize(18f)в функцииmain(). Укажите имя пользователя GitHub и токен (или пароль) в соответствующих полях.
Убедитесь, что опция БЛОКИРУЮЩИЙ выбрана в раскрывающемся списке Вариант.
Нажмите Загрузить участников. Интерфейс пользователя должен замереть на некоторое время, а затем отобразить список участников.
Откройте вывод программы, чтобы убедиться, что данные загружены. Список участников регистрируется после каждого успешного запроса.
Существует несколько способов реализации этой логики: с использованием блокирующих запросов или обратных вызовов. Вы сравните эти решения с решением, использующим подпрограммы, и увидите, как каналы могут использоваться для обмена данными между различными подпрограммами.
Блокирующие запросы
Для выполнения HTTP-запросов к GitHub вы будете использовать библиотеку Retrofit. Она позволяет запросить список репозиториев в рамках данной организации и список авторов для каждого репозитория:
interface GitHubService {
    @GET("orgs/{org}/repos?per_page=100")
    fun getOrgReposCall(
        @Path("org") org: String
    ): Call<List<Repo>>

    @GET("repos/{owner}/{repo}/contributors?per_page=100")
    fun getRepoContributorsCall(
        @Path("owner") owner: String,
        @Path("repo") repo: String
    ): Call<List<User>>
}
Этот API используется функцией loadContributorsBlocking() для получения списка авторов для данной организации.
-
Откройте
src/tasks/Request1Blocking.ktдля просмотра его реализации:fun loadContributorsBlocking(service: GitHubService, req: RequestData): List<User> { val repos = service .getOrgReposCall(req.org) // #1 .execute() // #2 .also { logRepos(req, it) } // #3 .body() ?: emptyList() // #4 return repos.flatMap { repo -> service .getRepoContributorsCall(req.org, repo.name) // #1 .execute() // #2 .also { logUsers(repo, it) } // #3 .bodyList() // #4 }.aggregate() }Сначала вы получаете список репозиториев для данной организации и сохраняете его в списке
repos. Затем для каждого репозитория запрашивается список авторов, и все списки объединяются в один итоговый список авторов.getOrgReposCall()иgetRepoContributorsCall()оба возвращают экземпляр класса*Call(#1). На этом этапе ни один запрос не отправляется.Затем вызывается
*Call.execute()для выполнения запроса (#2).execute()— это синхронный вызов, который блокирует подлежащую нить.При получении ответа результат регистрируется, вызывая функции
logRepos()иlogUsers()(#3). Если HTTP-ответ содержит ошибку, эта ошибка будет здесь зарегистрирована.Наконец, получите тело ответа, содержащее необходимые данные. Для этого учебника вы будете использовать пустой список в качестве результата в случае ошибки и регистрировать соответствующую ошибку (
#4).
-
Чтобы избежать повторения
.body() ?: emptyList(), объявляется функция-расширениеbodyList().fun <T> Response<List<T>>.bodyList(): List<T> { return body() ?: emptyList() } -
Запустите программу снова и посмотрите вывод системы в IntelliJ IDEA. Он должен выглядеть примерно так:
1770 [AWT-EventQueue-0] INFO  Contributors - kotlin: loaded 40 repos
2025 [AWT-EventQueue-0] INFO  Contributors - kotlin-examples: loaded 23 contributors
2229 [AWT-EventQueue-0] INFO  Contributors - kotlin-koans: loaded 45 contributors
...
Первым элементом в каждой строке является количество миллисекунд, прошедших с момента запуска программы, затем имя потока в квадратных скобках. Вы можете увидеть, из какого потока был вызван запрос загрузки.
Последним элементом в каждой строке является фактическое сообщение: сколько репозиториев или авторов было загружено.
Этот вывод логов демонстрирует, что все результаты были зарегистрированы из основного потока. При запуске кода с параметром БЛОКИРУЮЩИЙ окно замирает и не реагирует на входные данные до завершения загрузки. Все запросы выполняются из того же потока, что и вызов
loadContributorsBlocking(), который является основным потоком пользовательского интерфейса (в Swing это поток диспетчеризации событий AWT). Этот основной поток блокируется, и поэтому пользовательский интерфейс замирает:
После загрузки списка авторов результат обновляется.
-
В
src/contributors/Contributors.kt, найдите функциюloadContributors(), отвечающую за выбор способа загрузки авторов, и посмотрите, как вызываетсяloadContributorsBlocking().when (getSelectedVariant()) { BLOCKING -> { // Blocking UI thread val users = loadContributorsBlocking(service, req) updateResults(users, startTime) } }Вызов
updateResults()идет сразу после вызоваloadContributorsBlocking().updateResults()обновляет пользовательский интерфейс, поэтому его всегда следует вызывать из потока пользовательского интерфейса.Поскольку
loadContributorsBlocking()также вызывается из потока пользовательского интерфейса, поток пользовательского интерфейса блокируется, и пользовательский интерфейс замирает.
Задача 1
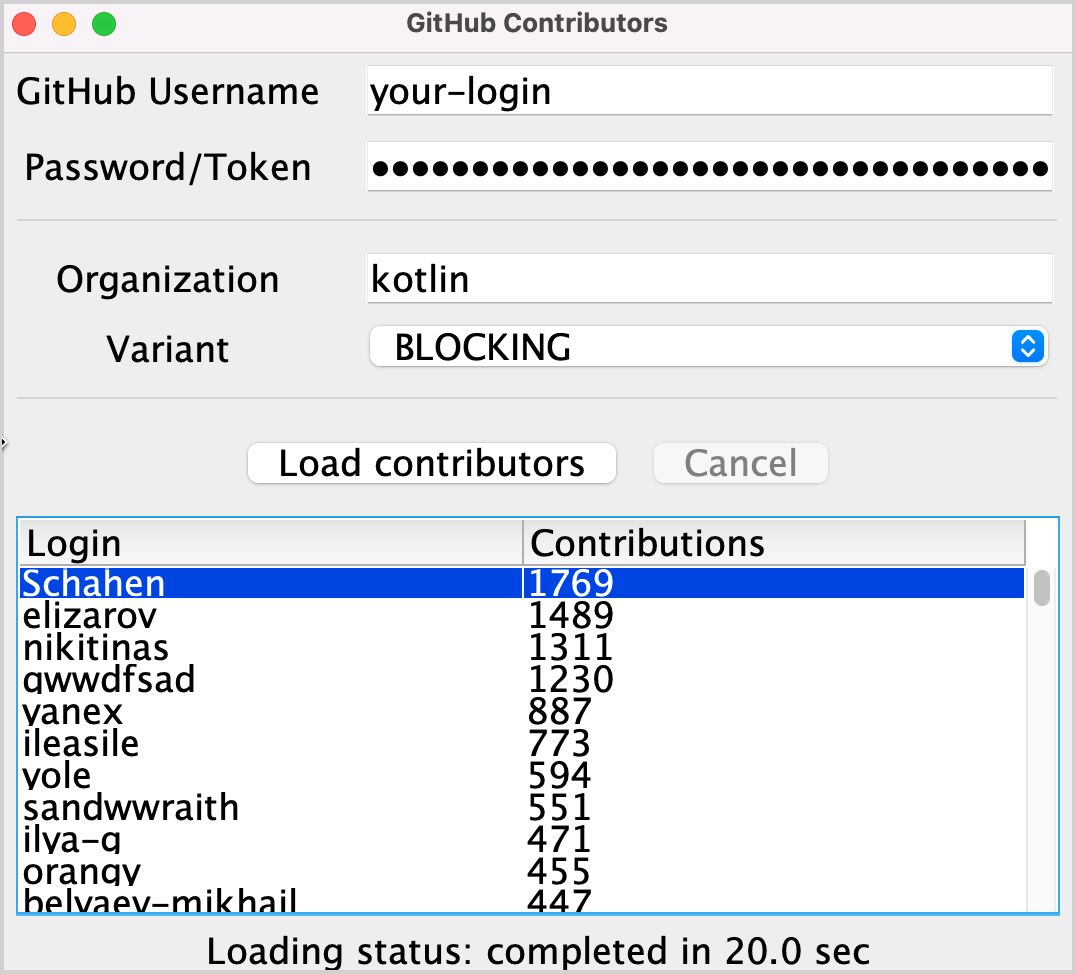
Первая задача поможет вам ознакомиться с областью задачи. В настоящее время имя каждого автора повторяется несколько раз, один раз для каждого проекта, в котором они участвовали. Реализуйте функцию aggregate() для объединения пользователей таким образом, чтобы каждый автор добавлялся только один раз. Свойство User.contributions должно содержать общее количество вкладов данного пользователя во все проекты. Результирующий список должен быть отсортирован по убыванию количества вкладов.
Откройте src/tasks/Aggregation.kt и реализуйте функцию List<User>.aggregate(). Пользователи должны быть отсортированы по общему количеству их вкладов.
Соответствующий тестовый файл test/tasks/AggregationKtTest.kt показывает пример ожидаемого результата.
После выполнения этой задачи результирующий список для организации «kotlin» должен быть похож на следующий:
Решение задачи 1
Чтобы сгруппировать пользователей по логину, используйте
groupBy(), которая возвращает карту из логина к всем появлениям пользователя с этим логином в разных репозиториях.Для каждого элемента карты подсчитайте общее количество вкладов для каждого пользователя и создайте новый экземпляр класса
Userс заданным именем и общим количеством вкладов.-
Отсортируйте результирующий список по убыванию:
fun List<User>.aggregate(): List<User> =
    groupBy { it.login }
        .map { (login, group) -> User(login, group.sumOf { it.contributions }) }
        .sortedByDescending { it.contributions }
Альтернативным решением является использование функции groupingBy() вместо groupBy().
Обработка событий (Callbacks)
Предыдущее решение работает, но блокирует поток, из-за чего интерфейс пользователя зависает. Традиционный подход, который этого избегает, использует обработку событий (callbacks).
Вместо вызова кода, который должен быть выполнен сразу после завершения операции, его можно выделить в отдельный callback, часто в виде лямбда-выражения, и передать этот лямбда-вызов вызывающей стороне для вызова позже.
Для обеспечения отзывчивости интерфейса пользователя, можно либо перенести всю вычисление в отдельный поток, либо переключиться на API Retrofit, который использует обработку событий (callbacks) вместо блокирующих вызовов.
Использование фонового потока
-
Откройте
src/tasks/Request2Background.ktи изучите его реализацию. Сначала вся вычисление перемещается в другой поток. Функцияthread()запускает новый поток:thread { loadContributorsBlocking(service, req) }Теперь, когда вся загрузка перенесена в отдельный поток, основной поток свободен и может быть занят другими задачами:

-
Подпись функции
loadContributorsBackground()меняется. Она принимает callbackupdateResults()в качестве последнего аргумента, чтобы вызвать его после завершения всей загрузки:fun loadContributorsBackground( service: GitHubService, req: RequestData, updateResults: (List<User>) -> Unit ) -
Теперь, когда вызывается
loadContributorsBackground(), вызовupdateResults()попадает в callback, а не сразу после него, как это было раньше:loadContributorsBackground(service, req) { users -> SwingUtilities.invokeLater { updateResults(users, startTime) } }Вызывая
SwingUtilities.invokeLater, вы гарантируете, что вызовupdateResults(), который обновляет результаты, происходит в главном потоке пользовательского интерфейса (поток диспетчеризации событий AWT).
Однако, если вы попытаетесь загрузить участников через опцию BACKGROUND, вы увидите, что список обновляется, но ничего не меняется.
Задача 2
Исправьте функцию loadContributorsBackground() в src/tasks/Request2Background.kt, чтобы результирующий список отображался в пользовательском интерфейсе.
Решение задачи 2
Если вы попытаетесь загрузить участников, вы увидите в логах, что участники загрузились, но результат не отображается. Чтобы исправить это, вызовите updateResults() для результирующего списка пользователей:
thread {
    updateResults(loadContributorsBlocking(service, req))
}
Убедитесь, что вы явно вызываете логику, переданную в callback. В противном случае ничего не произойдет.
Использование API Retrofit с обработкой событий
В предыдущем решении вся логика загрузки перемещена в фоновый поток, но это все еще не самый эффективный способ использования ресурсов. Все запросы загрузки выполняются последовательно, и поток блокируется, ожидая результата загрузки, в то время как он мог бы быть занят другими задачами. В частности, поток мог бы начать загрузку другого запроса, чтобы получить весь результат раньше.
Обработка данных для каждого репозитория должна быть разделена на две части: загрузка и обработка полученного ответа. Вторая часть обработки должна быть выделена в callback.
Загрузку для каждого репозитория можно начать до получения результата для предыдущего репозитория (и вызова соответствующего callback):
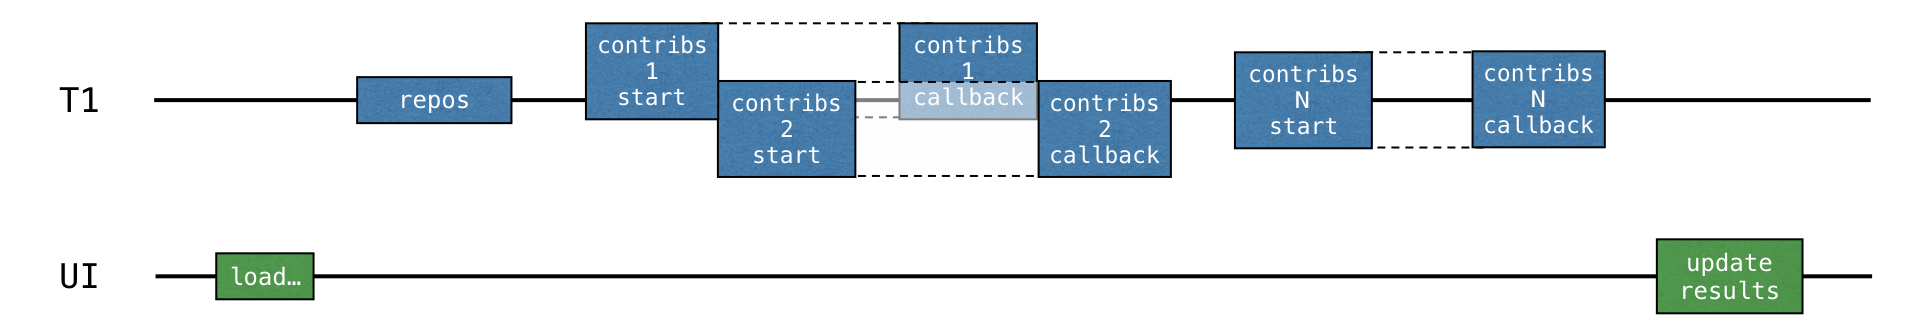
API Retrofit с обработкой событий может помочь в этом. Функция Call.enqueue() запускает HTTP-запрос и принимает callback в качестве аргумента. В этом callback необходимо указать, что нужно сделать после каждого запроса.
Откройте src/tasks/Request3Callbacks.kt и изучите реализацию loadContributorsCallbacks(), которая использует этот API:
fun loadContributorsCallbacks(
    service: GitHubService, req: RequestData,
    updateResults: (List<User>) -> Unit
) {
    service.getOrgReposCall(req.org).onResponse { responseRepos ->  // #1
        logRepos(req, responseRepos)
        val repos = responseRepos.bodyList()

        val allUsers = mutableListOf<User>()
        for (repo in repos) {
            service.getRepoContributorsCall(req.org, repo.name)
                .onResponse { responseUsers ->  // #2
                    logUsers(repo, responseUsers)
                    val users = responseUsers.bodyList()
                    allUsers += users
                }
            }
        }
        // TODO: Why doesn't this code work? How to fix that?
        updateResults(allUsers.aggregate())
    }
Для удобства этот фрагмент кода использует функцию расширения
onResponse(), объявленную в том же файле. Она принимает лямбда-выражение в качестве аргумента вместо объекта выражения.Логика обработки ответов выделена в callbacks: соответствующие лямбда-выражения начинаются на строках
#1и#2.
Однако, приведенное решение не работает. Если вы запустите программу и загрузите участников, выбрав опцию CALLBACKS, ничего не отобразится. Однако тесты, которые сразу возвращают результат, проходят.
Подумайте, почему предоставленный код не работает так, как ожидалось, и попробуйте исправить его, или ознакомьтесь с решениями ниже.
Задача 3 (необязательно)
Перепишите код в файле src/tasks/Request3Callbacks.kt так, чтобы загруженный список участников отображался.
Первое предполагаемое решение для задачи 3
В текущем решении многие запросы запускаются одновременно, что уменьшает общее время загрузки. Однако результат не загружается. Это происходит потому, что callback updateResults() вызывается сразу после запуска всех запросов на загрузку, до того, как список allUsers заполнится данными.
Можно попробовать исправить это таким изменением:
val allUsers = mutableListOf<User>()
for ((index, repo) in repos.withIndex()) {   // #1
    service.getRepoContributorsCall(req.org, repo.name)
        .onResponse { responseUsers ->
            logUsers(repo, responseUsers)
            val users = responseUsers.bodyList()
            allUsers += users
            if (index == repos.lastIndex) {    // #2
                updateResults(allUsers.aggregate())
            }
        }
}
Сначала вы перебираете список репозиториев с индексом (
#1).Затем из каждого callback вы проверяете, является ли это последней итерацией (
#2).И если это так, то результат обновляется.
Однако, и этот код не решает поставленную задачу. Попробуйте найти ответ самостоятельно или ознакомьтесь с решением ниже.
Второе предполагаемое решение для задачи 3
Поскольку запросы на загрузку запускаются одновременно, нет гарантии, что результат последнего придёт последним. Результаты могут приходить в любом порядке.
Таким образом, если вы сравниваете текущий индекс с lastIndex в качестве условия завершения, вы рискуете потерять результаты для некоторых репозиториев.
Если запрос, обрабатывающий последний репозиторий, возвращается быстрее, чем некоторые предыдущие запросы (что, вероятно, произойдет), все результаты запросов, которые занимают больше времени, будут потеряны.
Один из способов исправить это — ввести индекс и проверить, все ли репозитории уже обработаны:
val allUsers = Collections.synchronizedList(mutableListOf<User>())
val numberOfProcessed = AtomicInteger()
for (repo in repos) {
    service.getRepoContributorsCall(req.org, repo.name)
        .onResponse { responseUsers ->
            logUsers(repo, responseUsers)
            val users = responseUsers.bodyList()
            allUsers += users
            if (numberOfProcessed.incrementAndGet() == repos.size) {
                updateResults(allUsers.aggregate())
            }
        }
}
Этот код использует синхронизированный вариант списка и AtomicInteger(), потому что, как правило, нет гарантии, что разные callback'ы, обрабатывающие getRepoContributors() запросы, всегда будут вызваны из одного потока.
Третье предполагаемое решение для задачи 3
Еще более эффективное решение — использовать класс CountDownLatch. Он хранит счетчик, инициализированный количеством репозиториев. Этот счетчик уменьшается после обработки каждого репозитория. Затем он ожидает, пока счетчик latch не станет равным нулю, прежде чем обновить результаты:
val countDownLatch = CountDownLatch(repos.size)
for (repo in repos) {
    service.getRepoContributorsCall(req.org, repo.name)
        .onResponse { responseUsers ->
            // processing repository
            countDownLatch.countDown()
        }
}
countDownLatch.await()
updateResults(allUsers.aggregate())
Результат затем обновляется из главного потока. Это более прямое решение, чем делегирование логики в дочерние потоки.
После рассмотрения этих трёх попыток решения, вы можете видеть, что написание правильного кода с обработкой событий (callbacks) — непростая и подверженная ошибкам задача, особенно при наличии нескольких подпотоков и синхронизации.
Функции приостановки
Вы можете реализовать ту же логику, используя функции приостановки. Вместо возвращения Call<List<Repo>>, определите вызов API как функцию приостановки следующим образом:
interface GitHubService {
    @GET("orgs/{org}/repos?per_page=100")
    suspend fun getOrgRepos(
        @Path("org") org: String
    ): List<Repo>
}
getOrgRepos()определяется как функцияsuspend. Когда вы используете функцию приостановки для выполнения запроса, подлежащая нить не блокируется. Более подробные сведения о том, как это работает, будут представлены в последующих разделах.getOrgRepos()возвращает результат напрямую, вместо возвращенияCall. Если результат неудачный, выбрасывается исключение.
В качестве альтернативы, Retrofit позволяет возвращать результат, обернутый в Response. В этом случае тело результата предоставляется, и можно вручную проверить наличие ошибок. Этот учебник использует версии, которые возвращают Response.
В src/contributors/GitHubService.kt, добавьте следующие объявления в интерфейс GitHubService:
interface GitHubService {
    // getOrgReposCall & getRepoContributorsCall declarations

    @GET("orgs/{org}/repos?per_page=100")
    suspend fun getOrgRepos(
        @Path("org") org: String
    ): Response<List<Repo>>

    @GET("repos/{owner}/{repo}/contributors?per_page=100")
    suspend fun getRepoContributors(
        @Path("owner") owner: String,
        @Path("repo") repo: String
    ): Response<List<User>>
}
Задача 4
Ваша задача — изменить код функции, которая загружает участников, чтобы использовать две новые функции приостановки, getOrgRepos() и getRepoContributors(). Новая функция loadContributorsSuspend() помечена как suspend для использования нового API.
Скопируйте реализацию
loadContributorsBlocking()изsrc/tasks/Request1Blocking.ktвloadContributorsSuspend()изsrc/tasks/Request4Suspend.kt.Измените код так, чтобы вместо функций, возвращающих
Callиспользовались новые функции приостановки.Запустите программу, выбрав опцию ПРИОСТАНОВИТЬ, и убедитесь, что пользовательский интерфейс остается отзывчивым во время выполнения запросов к GitHub.
Решение задачи 4
Замените .getOrgReposCall(req.org).execute() на .getOrgRepos(req.org) и повторите эту же замену для второго запроса "contributors":
suspend fun loadContributorsSuspend(service: GitHubService, req: RequestData): List<User> {
    val repos = service
        .getOrgRepos(req.org)
        .also { logRepos(req, it) }
        .bodyList()

    return repos.flatMap { repo ->
        service.getRepoContributors(req.org, repo.name)
            .also { logUsers(repo, it) }
            .bodyList()
    }.aggregate()
}
loadContributorsSuspend()должна быть определена как функцияsuspend.Вам больше не нужно вызывать
execute, которая ранее возвращалаResponse, так как теперь функции API возвращаютResponseнапрямую. Обратите внимание, что эта деталь специфична для библиотеки Retrofit. С другими библиотеками API будет отличаться, но концепция остается той же.
Сопрограммы
Код с функциями приостановки выглядит схоже с "блокирующей" версией. Основное отличие от блокирующей версии заключается в том, что вместо блокирования нити сопрограмма приостанавливается:
block -> suspend
thread -> coroutine
Запуск новой сопрограммы
Если вы посмотрите, как loadContributorsSuspend() используется в src/contributors/Contributors.kt, вы увидите, что она вызывается внутри launch . launch — это функция библиотеки, которая принимает лямбда-выражение в качестве аргумента:
launch {
    val users = loadContributorsSuspend(req)
    updateResults(users, startTime)
}
Здесь launch запускает новую вычислительную задачу, ответственную за загрузку данных и отображение результатов. Вычисление является приостанавливаемым — при выполнении сетевых запросов оно приостанавливается и освобождает подлежащую нить. При возвращении результата сетевого запроса вычисление возобновляется.
Такое приостанавливаемое вычисление называется сопрограммой. Таким образом, в этом случае launch запускает новую сопрограмму, ответственного за загрузку данных и отображение результатов.
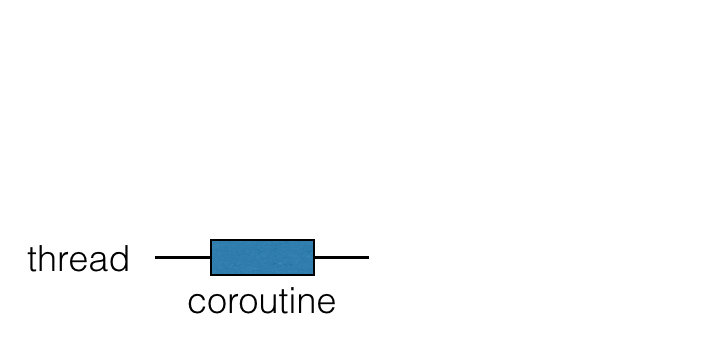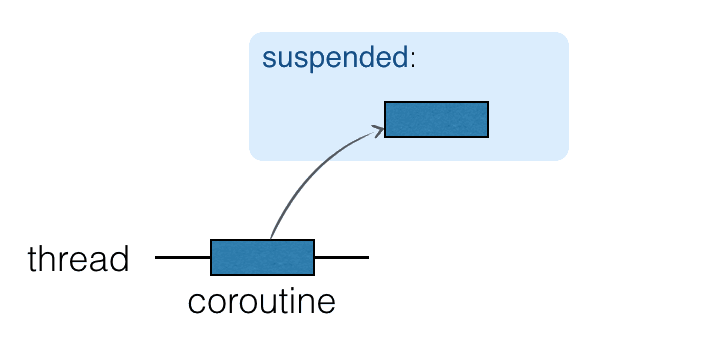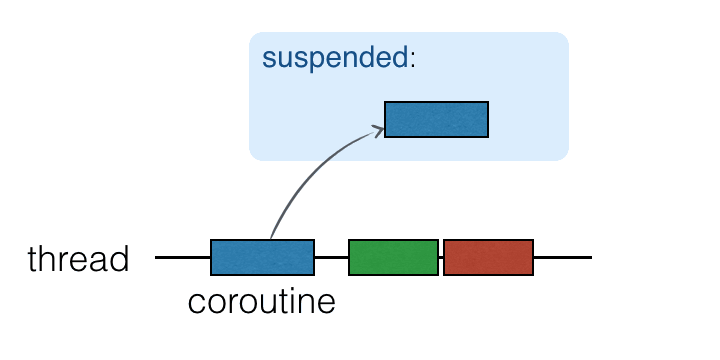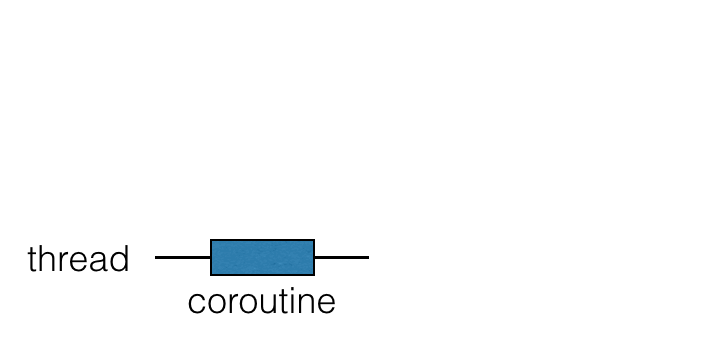
Сопрограммы работают поверх нитей и могут быть приостановлены. Когда сопрограмма приостанавливается, соответствующее вычисление приостанавливается, удаляется из нити и сохраняется в памяти. Тем временем нить свободна для выполнения других задач:
Когда вычисление готово к продолжению, оно возвращается в нить (не обязательно в ту же самую).
В примере loadContributorsSuspend() каждый запрос "contributors" теперь ожидает результата, используя механизм приостановки. Сначала отправляется новый запрос. Затем, в ожидании ответа, вся сопрограмма "загрузка участников", запущенная функцией launch , приостанавливается.
Сопрограмма возобновляется только после получения соответствующего ответа:
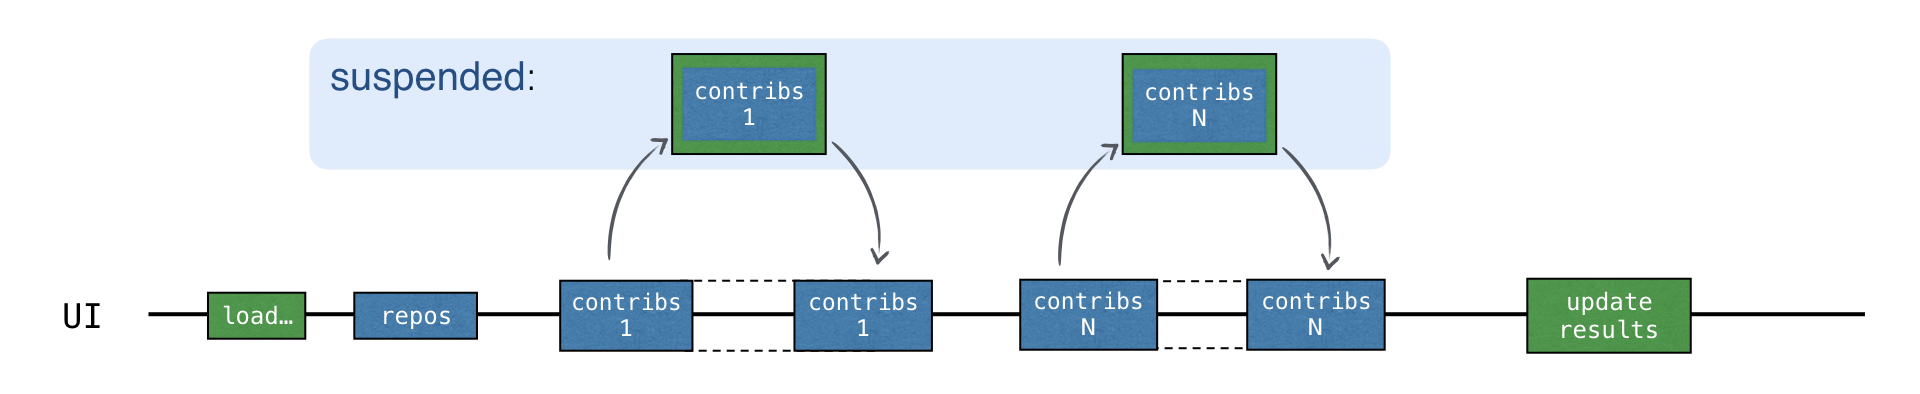
Пока ответ ожидает получения, нить свободна для выполнения других задач. Пользовательский интерфейс остается отзывчивым, несмотря на все запросы, выполняемые в основной нити пользовательского интерфейса:
-
Запустите программу, используя опцию ПРИОСТАНОВИТЬ. Лог подтверждает, что все запросы отправляются в основную нить пользовательского интерфейса:
2538 [AWT-EventQueue-0 @coroutine#1] INFO  Contributors - kotlin: loaded 30 repos
2729 [AWT-EventQueue-0 @coroutine#1] INFO  Contributors - ts2kt: loaded 11 contributors
3029 [AWT-EventQueue-0 @coroutine#1] INFO  Contributors - kotlin-koans: loaded 45 contributors
...
11252 [AWT-EventQueue-0 @coroutine#1] INFO  Contributors - kotlin-coroutines-workshop: loaded 1 contributors
-
Лог может показать, в какой сопрограмме выполняется соответствующий код. Для этого откройте Запуск | Редактировать конфигурации и добавьте параметр VM
-Dkotlinx.coroutines.debug: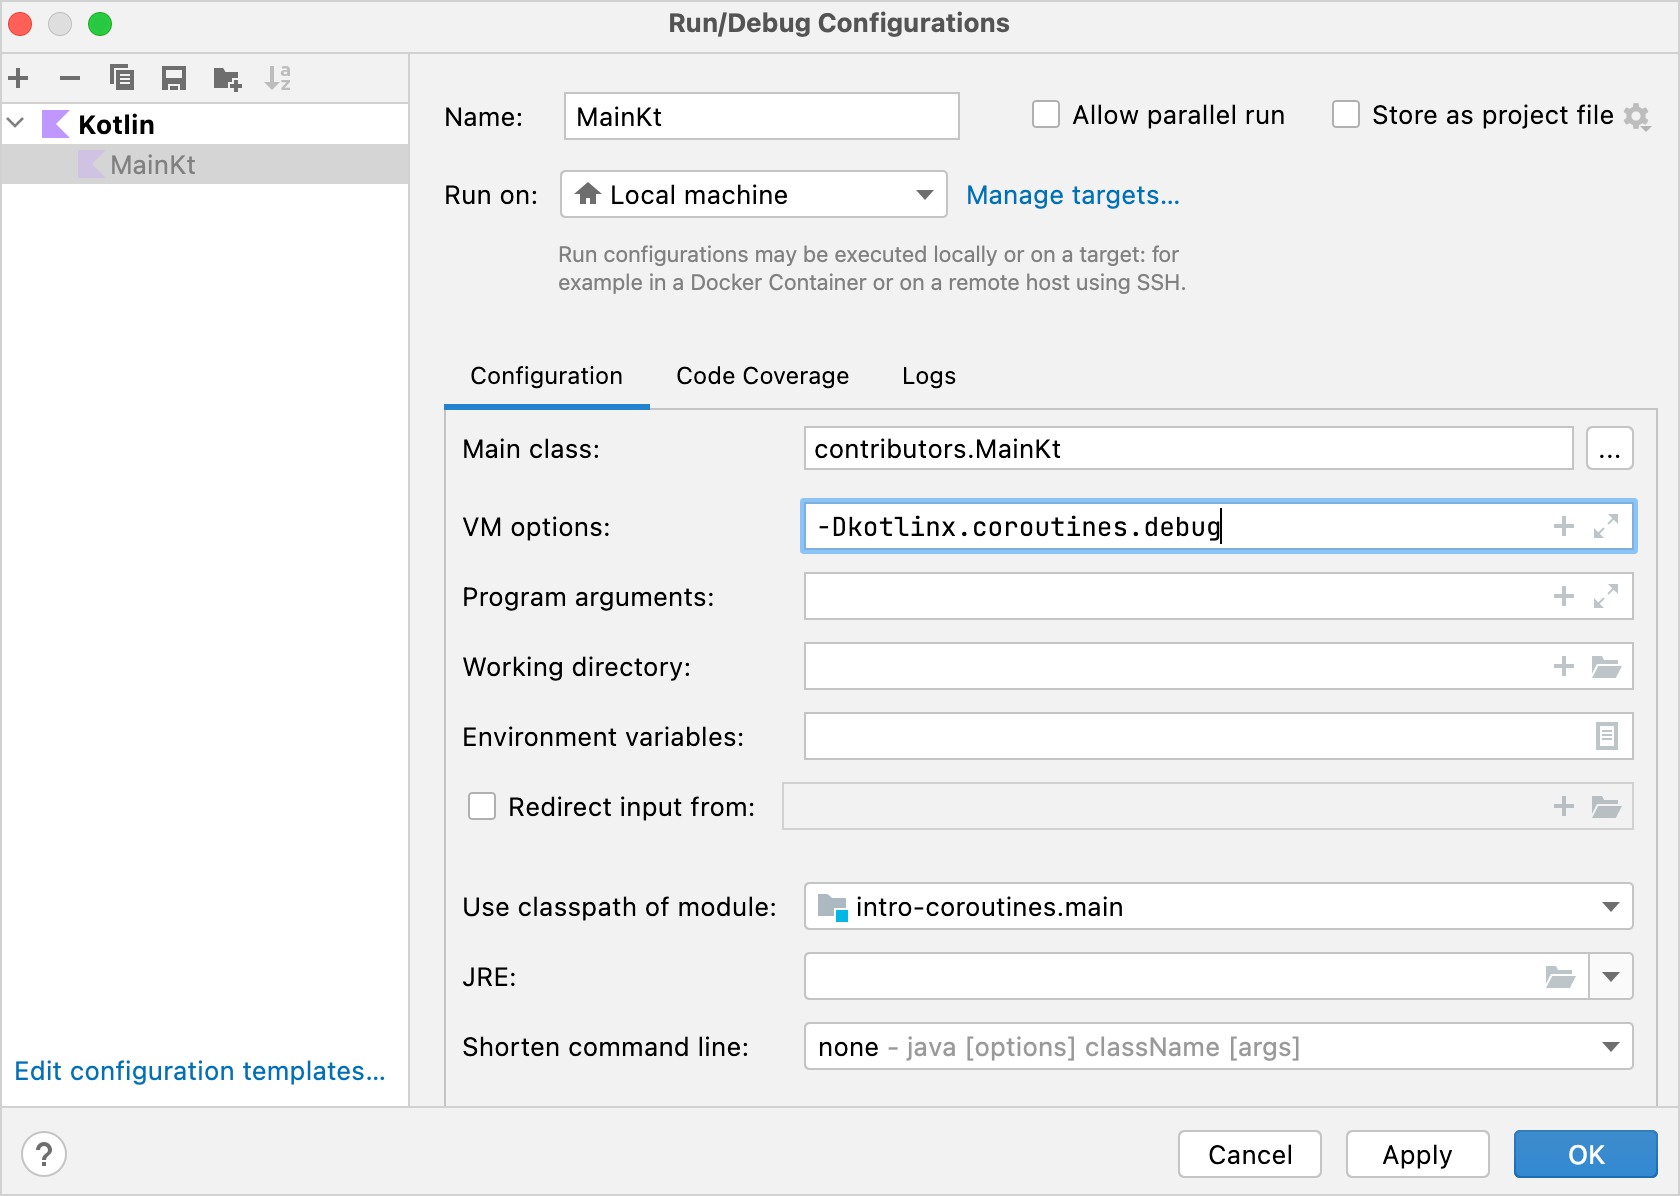
Имя сопрограммы будет добавлено к имени нити при запуске
main()с этим параметром. Вы также можете изменить шаблон запуска всех файлов Kotlin и включить этот параметр по умолчанию.
Теперь весь код выполняется в одной сопрограмме, "загрузке участников" упомянутой выше, обозначенной как @coroutine#1 . Ожидая результата, не следует повторно использовать нить для отправки других запросов, так как код написан последовательно. Новый запрос отправляется только после получения предыдущего результата.
Функции приостановки обращаются с нитью справедливо и не блокируют ее в ожидании. Однако это пока не вносит никакой параллельности.
Асинхронность
Kotlin-корутины потребляют гораздо меньше ресурсов, чем потоки. Каждый раз, когда вам нужно запустить новое асинхронное вычисление, вы можете создать новую корутину.
Чтобы запустить новую корутину, используйте один из основных строителей корутин: launch, async, или runBlocking. Различные библиотеки могут определять дополнительные строители корутин.
async запускает новую корутину и возвращает объект Deferred. Deferred представляет собой концепцию, известную и другими названиями, такими как Future или Promise. Она хранит вычисление, но откладывает момент получения конечного результата; она обещает результат в некотором будущем.
Основное отличие между async и launch заключается в том, что launch используется для запуска вычисления, от которого не ожидается получения конкретного результата. launch возвращает Job, представляющую корутину. Можно дождаться её завершения, вызвав Job.join().
Deferred — это универсальный тип, который расширяет Job. Вызов async может вернуть Deferred<Int> или Deferred<CustomType>, в зависимости от того, что возвращает лямбда-выражение (последнее выражение внутри лямбды — результат).
Чтобы получить результат корутины, можно вызвать await() на экземпляре Deferred. Пока ожидается результат, корутина, из которой вызван этот await(), приостанавливается:
import kotlinx.coroutines.*

fun main() = runBlocking {
    val deferred: Deferred<Int> = async {
        loadData()
    }
    println("waiting...")
    println(deferred.await())
}

suspend fun loadData(): Int {
    println("loading...")
    delay(1000L)
    println("loaded!")
    return 42
}
runBlocking используется как мост между обычными и приостанавливаемыми функциями, или между блокирующим и неблокирующим мирами. Он работает как адаптер для запуска главной корутины верхнего уровня. Он предназначен в основном для использования в функциях и тестах main().
Если есть список объектов отложенного выполнения, можно вызвать awaitAll() для ожидания результатов всех из них:
import kotlinx.coroutines.*

fun main() = runBlocking {
    val deferreds: List<Deferred<Int>> = (1..3).map {
        async {
            delay(1000L * it)
            println("Loading $it")
            it
        }
    }
    val sum = deferreds.awaitAll().sum()
    println("$sum")
}
Когда каждый запрос «contributors» запускается в новой корутине, все запросы запускаются асинхронно. Новый запрос может быть отправлен до получения результата по предыдущему:
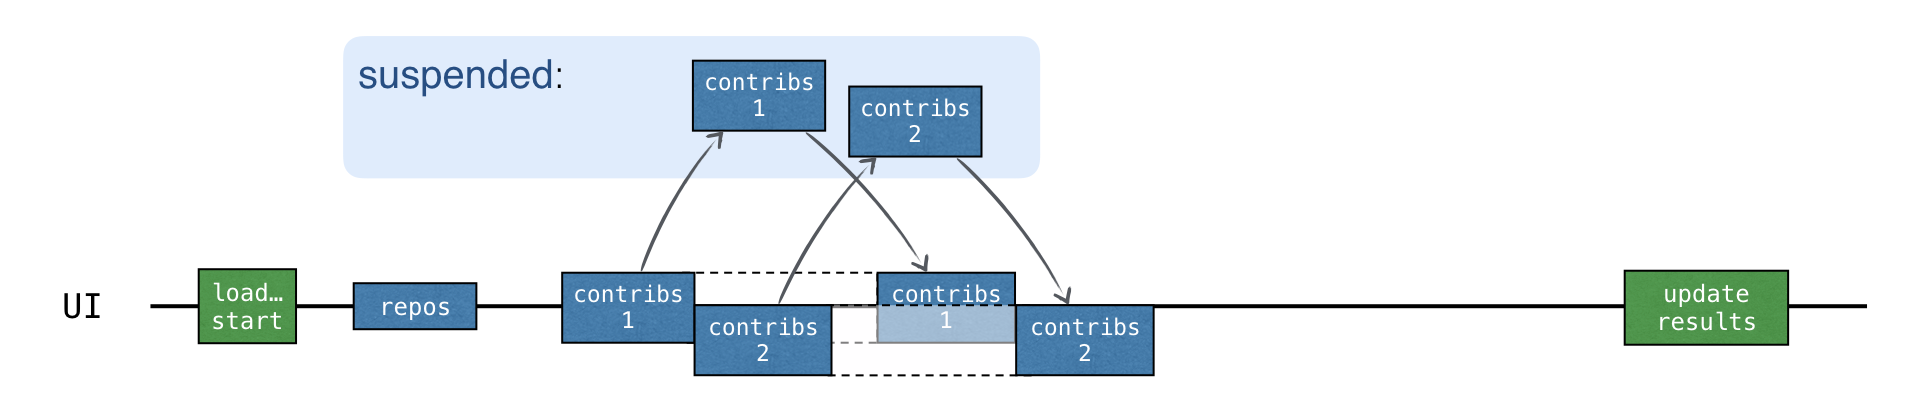
Общее время загрузки примерно такое же, как в версии CALLBACKS, но она не требует никаких обратных вызовов. Более того, async чётко выделяет части кода, выполняющиеся параллельно.
Задача 5
В файле Request5Concurrent.kt реализуйте функцию loadContributorsConcurrent(), используя предыдущую функцию loadContributorsSuspend().
Подсказка к задаче 5
Вы можете запускать новые корутины только внутри области видимости корутины. Скопируйте содержимое из loadContributorsSuspend() в вызов coroutineScope, чтобы вы могли там вызывать функции async:
suspend fun loadContributorsConcurrent(
    service: GitHubService,
    req: RequestData
): List<User> = coroutineScope {
    // ...
}
Основывайтесь на следующей схеме:
val deferreds: List<Deferred<List<User>>> = repos.map { repo ->
    async {
        // load contributors for each repo
    }
}
deferreds.awaitAll() // List<List<User>>
Решение для задачи 5
Оборачивайте каждый запрос «contributors» с помощью async, чтобы создать столько корутин, сколько репозиториев. async возвращает Deferred<List<User>>. Это не проблема, потому что создание новых корутин не сильно нагружает ресурсы, так что можно создавать столько, сколько нужно.
-
Вы больше не можете использовать
flatMap, потому что результатmapтеперь представляет собой список объектовDeferred, а не список списков.awaitAll()возвращаетList<List<User>>, поэтому вызовитеflatten().aggregate()для получения результата:suspend fun loadContributorsConcurrent( service: GitHubService, req: RequestData ): List<User> = coroutineScope { val repos = service .getOrgRepos(req.org) .also { logRepos(req, it) } .bodyList() val deferreds: List<Deferred<List<User>>> = repos.map { repo -> async { service.getRepoContributors(req.org, repo.name) .also { logUsers(repo, it) } .bodyList() } } deferreds.awaitAll().flatten().aggregate() } Запустите код и проверьте лог. Все корутины всё ещё выполняются в главном потоке пользовательского интерфейса, потому что многопоточность ещё не использована, но вы уже можете увидеть преимущества одновременного выполнения корутин.
-
Чтобы изменить этот код на выполнение корутин «contributors» в разных потоках из общего пула потоков, укажите
Dispatchers.Defaultв качестве аргумента контекста для функцииasync:async(Dispatchers.Default) { }CoroutineDispatcherопределяет, на каком или каких потоках должна выполняться соответствующая корутина. Если вы не укажете его в качестве аргумента,asyncбудет использовать диспетчер из внешней области видимости.Dispatchers.Defaultпредставляет собой общий пул потоков в JVM. Этот пул предоставляет возможность параллельного выполнения. Он состоит из потоков, соответствующих количеству доступных ядер процессора, но он по-прежнему будет иметь два потока, если ядро только одно.
-
Измените код в функции
loadContributorsConcurrent()для запуска новых корутин в разных потоках из общего пула потоков. Также добавьте дополнительную запись в лог перед отправкой запроса:async(Dispatchers.Default) { log("starting loading for ${repo.name}") service.getRepoContributors(req.org, repo.name) .also { logUsers(repo, it) } .bodyList() } -
Запустите программу ещё раз. В логе вы сможете увидеть, что каждая корутина может быть запущена на одном потоке из пула потоков и продолжена на другом:
1946 [DefaultDispatcher-worker-2 @coroutine#4] INFO  Contributors - starting loading for kotlin-koans
1946 [DefaultDispatcher-worker-3 @coroutine#5] INFO  Contributors - starting loading for dokka
1946 [DefaultDispatcher-worker-1 @coroutine#3] INFO  Contributors - starting loading for ts2kt
...
2178 [DefaultDispatcher-worker-1 @coroutine#4] INFO  Contributors - kotlin-koans: loaded 45 contributors
2569 [DefaultDispatcher-worker-1 @coroutine#5] INFO  Contributors - dokka: loaded 36 contributors
2821 [DefaultDispatcher-worker-2 @coroutine#3] INFO  Contributors - ts2kt: loaded 11 contributors
Например, в этом фрагменте лога,
coroutine#4запускается в потокеworker-2и продолжается в потокеworker-1.
В src/contributors/Contributors.kt, проверьте реализацию опции CONCURRENT:
-
Чтобы запустить корутину только в главном потоке пользовательского интерфейса, укажите
Dispatchers.Mainв качестве аргумента:launch(Dispatchers.Main) { updateResults() }Если главный поток занят при запуске новой корутины на нём, корутина приостанавливается и планируется для выполнения в этом потоке. Корутина возобновится только когда поток станет свободным.
Принято использовать диспетчер из внешней области видимости вместо явного указания его в каждом конечном пункте. Если вы определяет
loadContributorsConcurrent()без передачиDispatchers.Defaultв качестве аргумента, вы можете вызвать эту функцию в любом контексте: с диспетчеромDefault, с главным потоком пользовательского интерфейса или с настраиваемым диспетчером.Как вы увидите позже, при вызове
loadContributorsConcurrent()из тестов, вы можете вызывать её в контексте сTestDispatcher, что упрощает тестирование. Это делает решение гораздо более гибким.
-
Для указания диспетчера со стороны вызывающего приложения, внесите следующие изменения в проект, разрешая
loadContributorsConcurrentзапускать корутины в унаследованном контексте:launch(Dispatchers.Default) { val users = loadContributorsConcurrent(service, req) withContext(Dispatchers.Main) { updateResults(users, startTime) } }updateResults()должна вызываться в главном потоке пользовательского интерфейса, поэтому вы вызываете её с контекстомDispatchers.Main.withContext()вызывает указанный код с заданным контекстом корутины, приостанавливается до его завершения и возвращает результат. Альтернативный, но более подробный способ выразить это — запустить новую корутину и явно дождаться (приостановившись), пока она завершится:launch(context) { ... }.join().
Запустите код и убедитесь, что корутины выполняются в потоках из пула потоков.
Структурированная конкуратность
Область корутины отвечает за структуру и отношения «родитель-потомок» между различными корутинами. Новые корутины обычно необходимо запускать внутри области.
Контекст корутины хранит дополнительную техническую информацию, используемую для запуска данной корутины, например, пользовательское имя корутины или диспетчер, определяющий потоки, на которых корутина должна планироваться.
При использовании launch, async, или runBlocking для запуска новой корутины, они автоматически создают соответствующую область. Все эти функции принимают лямбда-выражение с получателем в качестве аргумента, и CoroutineScope является неявным типом получателя:
launch { /* this: CoroutineScope */ }
Новые корутины могут запускаться только внутри области.
launchиasyncобъявляются как расширения дляCoroutineScope, поэтому неявный или явный получатель всегда должен передаваться при их вызове.Корутина, запущенная с помощью
runBlocking, является единственным исключением, потому чтоrunBlockingопределена как функция верхнего уровня. Но поскольку она блокирует текущий поток, она предназначена в основном для использования в функцияхmain()и тестах в качестве мостовой функции.
Новая корутина внутри runBlocking, launch, или async запускается автоматически внутри области:
import kotlinx.coroutines.*

fun main() = runBlocking { /* this: CoroutineScope */
    launch { /* ... */ }
    // the same as:
    this.launch { /* ... */ }
}
При вызове launch внутри runBlocking, она вызывается как расширение для неявного получателя типа CoroutineScope. В качестве альтернативы, вы можете явно написать this.launch.
Вложенная корутина (запущенная с помощью launch в этом примере) может рассматриваться как дочерняя корутина внешней корутины (запущенной с помощью runBlocking). Это отношение «родитель-потомок» реализуется через области; дочерняя корутина запускается из области, соответствующей родительской корутине.
Можно создать новую область без запуска новой корутины, используя функцию coroutineScope. Чтобы структурированно запускать новые корутины внутри функции suspend без доступа к внешней области, вы можете создать новую область корутины, которая автоматически становится дочерней областью внешней области, из которой вызывается функция suspend. loadContributorsConcurrent() - хороший пример.
Вы также можете запустить новую корутину из глобальной области, используя GlobalScope.async или GlobalScope.launch. Это создаст независимую корутину верхнего уровня.
Механизм структуры корутин называется структурированной конкуратностью. Она предоставляет следующие преимущества по сравнению с глобальными областями:
Область, как правило, отвечает за дочерние корутины, срок жизни которых привязан к сроку жизни области.
Область может автоматически отменять дочерние корутины, если что-то идет не так или пользователь меняет решение и решает отменить операцию.
Область автоматически ожидает завершения всех дочерних корутин. Поэтому, если область соответствует корутине, родительская корутина не завершается до тех пор, пока все корутины, запущенные в ее области, не завершатся.
При использовании GlobalScope.async, нет структуры, которая связывает несколько корутин в более узкой области. Корутины, запущенные из глобальной области, являются независимыми - их срок жизни ограничен только сроком жизни всего приложения. Можно сохранить ссылку на запущенную из глобальной области корутину и дождаться ее завершения или явно отменить ее, но это не произойдет автоматически, как в случае со структурированной конкуратностью.
Отмена загрузки участников
Создайте две версии функции, которая загружает список участников. Сравните, как ведут себя обе версии, когда вы пытаетесь отменить родительскую корутину. Первая версия будет использовать coroutineScope для запуска всех дочерних корутин, а вторая - GlobalScope.
-
В
Request5Concurrent.kt, добавьте задержку в 3 секунды в функциюloadContributorsConcurrent().suspend fun loadContributorsConcurrent( service: GitHubService, req: RequestData ): List<User> = coroutineScope { // ... async { log("starting loading for ${repo.name}") delay(3000) // load repo contributors } // ... }Задержка влияет на все корутины, которые отправляют запросы, чтобы было достаточно времени для отмены загрузки после запуска корутин, но до отправки запросов.
Создайте вторую версию функции загрузки: скопируйте реализацию
loadContributorsConcurrent()вloadContributorsNotCancellable()вRequest5NotCancellable.ktи удалите создание новойcoroutineScope.-
Вызовы
asyncтеперь не разрешаются, поэтому запустите их с помощьюGlobalScope.async.suspend fun loadContributorsNotCancellable( service: GitHubService, req: RequestData ): List<User> { // #1 // ... GlobalScope.async { // #2 log("starting loading for ${repo.name}") // load repo contributors } // ... return deferreds.awaitAll().flatten().aggregate() // #3 }Функция теперь возвращает результат напрямую, а не как последнее выражение внутри лямбда-выражения (строки
#1и#3).Все корутины «contributors» запускаются внутри
GlobalScope, а не как дочерние корутины области корутины (строка#2).
Запустите программу и выберите вариант CONCURRENT для загрузки участников.
-
Дождитесь запуска всех корутин «contributors», а затем нажмите Отмена. В логе нет новых результатов, что означает, что все запросы были действительно отменены:
2896 [AWT-EventQueue-0 @coroutine#1] INFO  Contributors - kotlin: loaded 40 repos
2901 [DefaultDispatcher-worker-2 @coroutine#4] INFO  Contributors - starting loading for kotlin-koans
...
2909 [DefaultDispatcher-worker-5 @coroutine#36] INFO  Contributors - starting loading for mpp-example
/* click on 'cancel' */
/* no requests are sent */
-
Повторите шаг 5, но на этот раз выберите вариант
NOT_CANCELLABLE:2570 [AWT-EventQueue-0 @coroutine#1] INFO Contributors - kotlin: loaded 30 repos 2579 [DefaultDispatcher-worker-1 @coroutine#4] INFO Contributors - starting loading for kotlin-koans ... 2586 [DefaultDispatcher-worker-6 @coroutine#36] INFO Contributors - starting loading for mpp-example /* click on 'cancel' */ /* but all the requests are still sent: */ 6402 [DefaultDispatcher-worker-5 @coroutine#4] INFO Contributors - kotlin-koans: loaded 45 contributors ... 9555 [DefaultDispatcher-worker-8 @coroutine#36] INFO Contributors - mpp-example: loaded 8 contributors
В этом случае никакие корутины не отменяются, и все запросы по-прежнему отправляются.
-
Проверьте, как происходит отмена в программе «contributors». Когда нажимается кнопка Отмена, главная корутина «загрузки» отменяется явно, а дочерние корутины отменяются автоматически:
interface Contributors {

    fun loadContributors() {
        // ...
        when (getSelectedVariant()) {
            CONCURRENT -> {
                launch {
                    val users = loadContributorsConcurrent(service, req)
                    updateResults(users, startTime)
                }.setUpCancellation()      // #1
            }
        }
    }

    private fun Job.setUpCancellation() {
        val loadingJob = this              // #2

        // cancel the loading job if the 'cancel' button was clicked:
        val listener = ActionListener {
            loadingJob.cancel()            // #3
            updateLoadingStatus(CANCELED)
        }
        // add a listener to the 'cancel' button:
        addCancelListener(listener)

        // update the status and remove the listener
        // after the loading job is completed
    }
}
Функция launch возвращает экземпляр Job. Job хранит ссылку на «корутину загрузки», которая загружает все данные и обновляет результаты. Вы можете вызвать функцию-расширение setUpCancellation() для нее (строка #1). передав экземпляр Job в качестве получателя.
Другой способ выразить это - написать явно:
val job = launch { }
job.setUpCancellation()
Для удобочитаемости вы можете обратиться к получателю функции
setUpCancellation()внутри функции с новой переменнойloadingJob(строка#2).Затем вы можете добавить обработчик нажатия кнопки Отмена, чтобы при нажатии корутина
loadingJobотменялась (строка#3).
При использовании структурированной конкуратности достаточно отменить родительскую корутину, что автоматически распространяет отмену на все дочерние корутины.
Использование контекста внешней области
При запуске новых корутин внутри заданной области намного проще гарантировать, что все они выполняются с одним и тем же контекстом. Также намного проще заменить контекст при необходимости.
Теперь пришло время узнать, как работает использование диспетчера из внешней области. Новая область, созданная функцией coroutineScope или конструкторами корутин, всегда наследует контекст из внешней области. В этом случае внешняя область - это область, из которой была вызвана функция suspend loadContributorsConcurrent():
launch(Dispatchers.Default) {  // outer scope
    val users = loadContributorsConcurrent(service, req)
    // ...
}
Все вложенные корутины автоматически запускаются с унаследованным контекстом. Диспетчер является частью этого контекста. Поэтому все корутины, запущенные функцией async, запускаются с контекстом по умолчанию диспетчера:
suspend fun loadContributorsConcurrent(
    service: GitHubService, req: RequestData
): List<User> = coroutineScope {
    // this scope inherits the context from the outer scope
    // ...
    async {   // nested coroutine started with the inherited context
        // ...
    }
    // ...
}
При использовании структурированной конкуратности вы можете указать основные элементы контекста (например, диспетчер) один раз при создании корутины верхнего уровня. Все вложенные корутины затем наследуют контекст и изменяют его только при необходимости.
Отображение прогресса
Несмотря на то, что информация для некоторых репозиториев загружается довольно быстро, пользователь видит итоговый список только после загрузки всех данных. До этого момента значок загрузчика отображается, показывая прогресс, но нет информации о текущем состоянии или уже загруженных участниках.
Вы можете отобразить промежуточные результаты раньше и отобразить всех участников после загрузки данных для каждого репозитория:
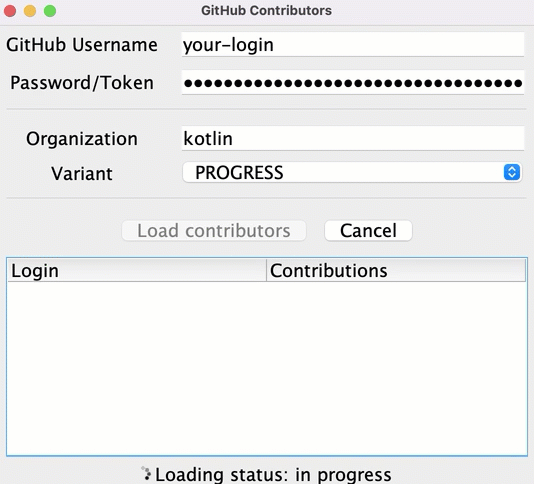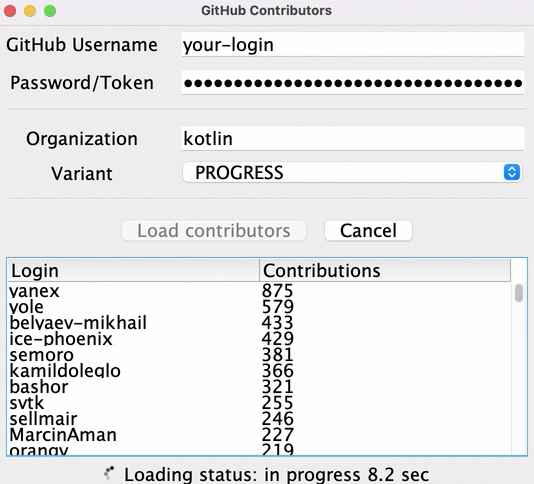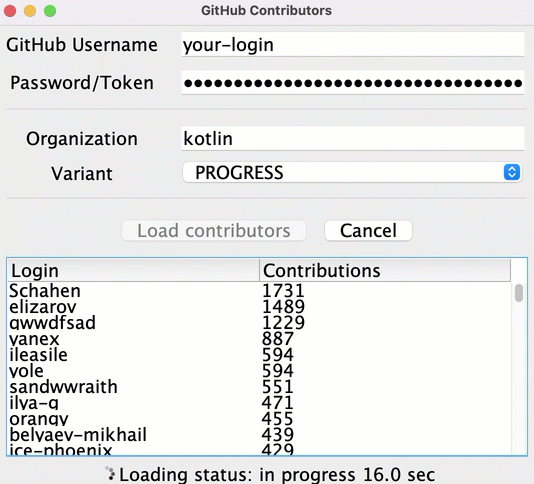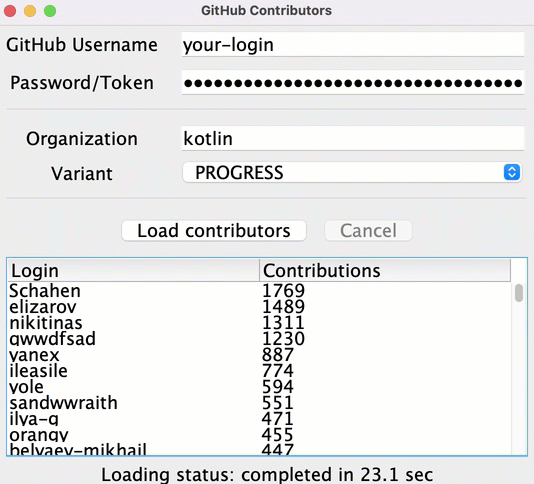
Для реализации этой функциональности в src/tasks/Request6Progress.kt, вам необходимо передать логику обновления интерфейса в качестве обратного вызова, чтобы он вызывался на каждом промежуточном шаге:
suspend fun loadContributorsProgress(
    service: GitHubService,
    req: RequestData,
    updateResults: suspend (List<User>, completed: Boolean) -> Unit
) {
    // loading the data
    // calling `updateResults()` on intermediate states
}
В месте вызова в Contributors.kt, обратный вызов передается для обновления результатов из потока Main для опции PROGRESS:
launch(Dispatchers.Default) {
    loadContributorsProgress(service, req) { users, completed ->
        withContext(Dispatchers.Main) {
            updateResults(users, startTime, completed)
        }
    }
}
Параметр
updateResults()объявлен какsuspendвloadContributorsProgress(). Необходимо вызватьwithContext, которая является функциейsuspendвнутри соответствующего лямбда-аргумента.Обратный вызов
updateResults()принимает дополнительный булевый параметр в качестве аргумента, указывающий, завершена ли загрузка и являются ли результаты окончательными.
Задача 6
В файле Request6Progress.kt реализуйте функцию loadContributorsProgress(), которая показывает промежуточный прогресс. Основывайтесь на функции loadContributorsSuspend() из Request4Suspend.kt.
Используйте простую версию без конкурентности; вы добавите её позже в следующем разделе.
Промежуточный список участников должен отображаться в «агрегированном» состоянии, а не только список пользователей, загруженных для каждого репозитория.
Общее количество вкладов для каждого пользователя должно увеличиваться при загрузке данных для каждого нового репозитория.
Решение задачи 6
Для хранения промежуточного списка загруженных участников в «агрегированном» состоянии определите переменную allUsers, которая хранит список пользователей, а затем обновите её после загрузки участников для каждого нового репозитория:
suspend fun loadContributorsProgress(
    service: GitHubService,
    req: RequestData,
    updateResults: suspend (List<User>, completed: Boolean) -> Unit
) {
    val repos = service
        .getOrgRepos(req.org)
        .also { logRepos(req, it) }
        .bodyList()

    var allUsers = emptyList<User>()
    for ((index, repo) in repos.withIndex()) {
        val users = service.getRepoContributors(req.org, repo.name)
            .also { logUsers(repo, it) }
            .bodyList()

        allUsers = (allUsers + users).aggregate()
        updateResults(allUsers, index == repos.lastIndex)
    }
}
Последовательное против параллельного
Обратный вызов updateResults() вызывается после завершения каждого запроса:
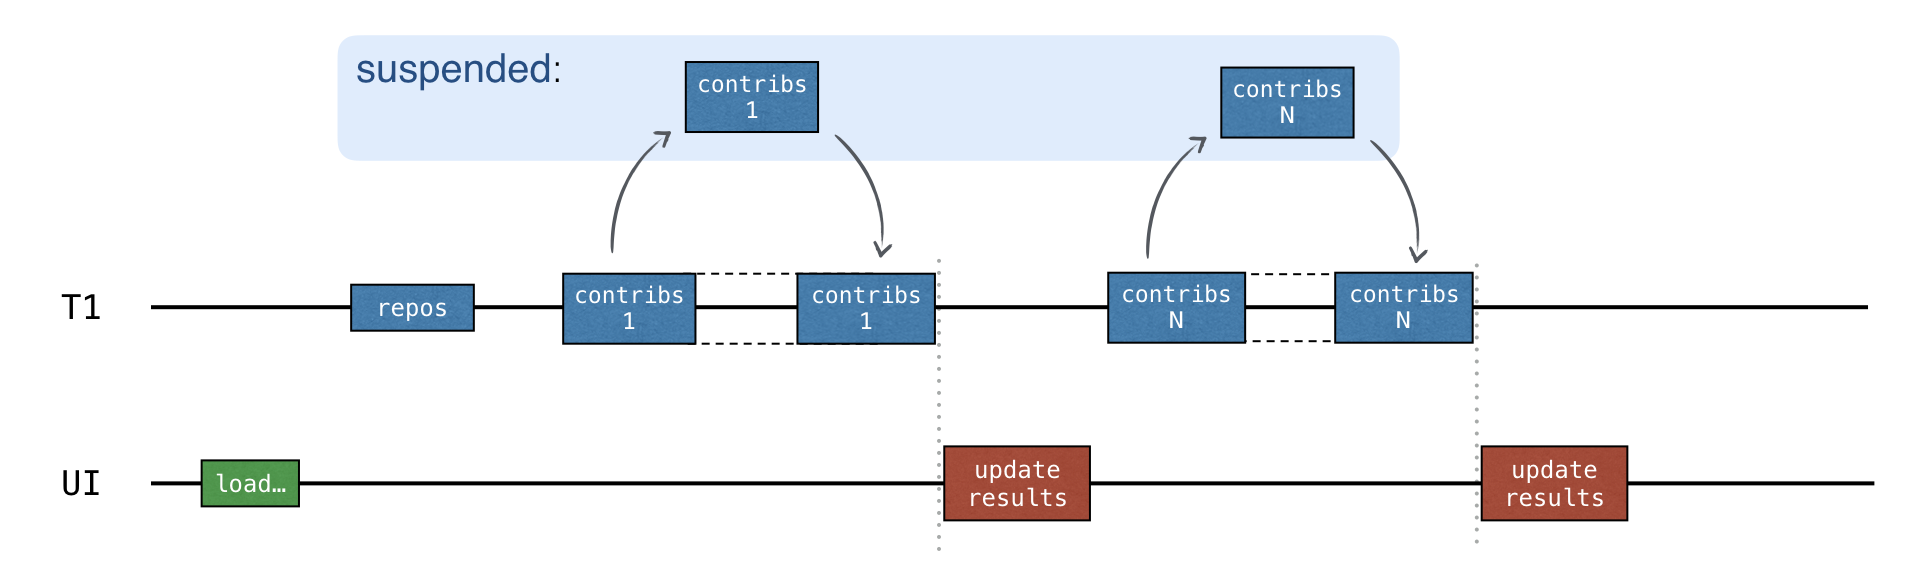
Этот код не включает конкурентности. Он последовательный, поэтому вам не нужна синхронизация.
Лучшим вариантом было бы отправить запросы параллельно и обновить промежуточные результаты после получения ответа для каждого репозитория:
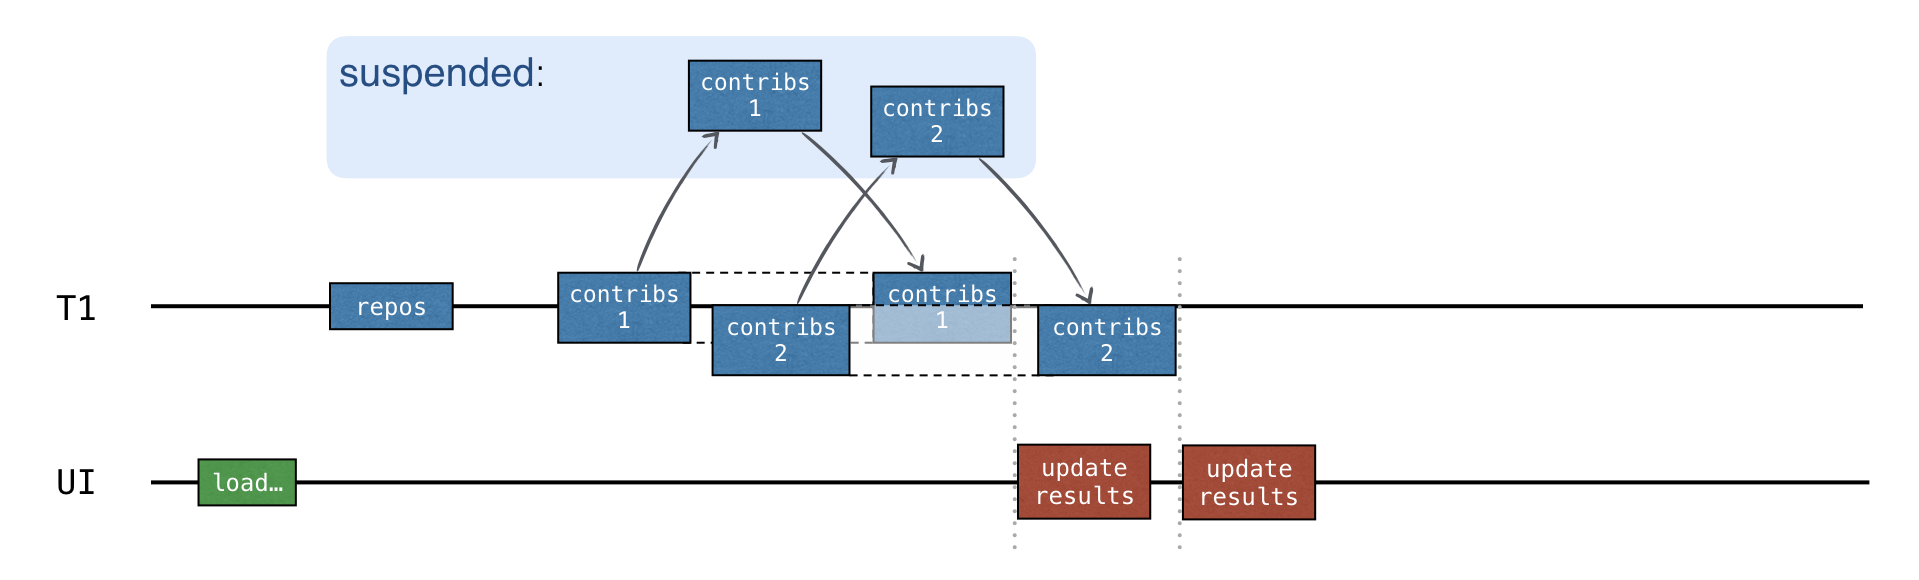
Для добавления конкурентности используйте каналы.
Каналы
Написание кода с общей изменяемой областью состояния довольно сложно и подвержено ошибкам (как в решении с обратными вызовами). Более простой способ — передавать информацию посредством связи, а не с помощью общей изменяемой области. Корутины могут обмениваться данными через каналы.
Каналы — это примитивы связи, которые позволяют передавать данные между корутинами. Одна корутина может отправить некоторую информацию в канал, а другая может получить эту информацию из него:

Корутина, которая отправляет (производит) информацию, часто называется производителем, а корутина, которая получает (потребляет) информацию, называется потребителем. Одна или несколько корутин могут отправить информацию в один и тот же канал, и одна или несколько корутин могут получить данные из него:

Когда много корутин получают информацию из одного и того же канала, каждый элемент обрабатывается только один раз одной из корутин-потребителей. После обработки элемент немедленно удаляется из канала.
Вы можете представить канал как нечто подобное набору элементов или, точнее, очереди, в которой элементы добавляются с одного конца и извлекаются с другого. Однако есть важное различие: в отличие от коллекций, даже в их синхронизированных версиях, канал может подвешиваться send() и receive() операциями. Это происходит, когда канал пуст или полон. Канал может быть полным, если размер канала имеет верхнюю границу.
Channel представлен тремя различными интерфейсами: SendChannel, ReceiveChannel, и Channel, причём последний расширяет первые два. Обычно вы создаёте канал и передаёте его производителям как SendChannel экземпляр, чтобы только они могли отправлять информацию в канал. Вы передаёте канал потребителям как ReceiveChannel экземпляр, чтобы только они могли получать из него. Оба send и receive метода объявлены как suspend.
interface SendChannel<in E> {
    suspend fun send(element: E)
    fun close(): Boolean
}

interface ReceiveChannel<out E> {
    suspend fun receive(): E
}

interface Channel<E> : SendChannel<E>, ReceiveChannel<E>
Производитель может закрыть канал, чтобы указать, что больше элементов не поступает.
В библиотеке определены несколько типов каналов. Они различаются тем, сколько элементов они могут хранить внутри и может ли вызов send() быть приостановлен или нет. Для всех типов каналов вызов receive() ведёт себя аналогично: он получает элемент, если канал не пуст; в противном случае он приостанавливается.
- Неограниченный канал
-
Неограниченный канал — это ближайший аналог очереди: производители могут отправлять элементы в этот канал, и он будет неограниченно расти. Вызов
send()никогда не будет приостановлен. Если программе не хватит памяти, вы получитеOutOfMemoryException. Различие между неограниченным каналом и очередью состоит в том, что когда потребитель пытается получить из пустого канала, он приостанавливается до тех пор, пока какие-либо новые элементы не будут отправлены.
- Буферизованный канал
-
Размер буферизованного канала ограничен указанным числом. Производители могут отправлять элементы в этот канал до тех пор, пока не будет достигнут предел размера. Все элементы хранятся внутри. Когда канал полон, следующий вызов `send` на нём приостанавливается до тех пор, пока не станет доступно больше свободного места.

- Канал "Rendezvous"
-
Канал "Rendezvous" — это канал без буфера, такой же, как буферизованный канал с нулевым размером. Одна из функций (
send()илиreceive()) всегда приостанавливается, пока не будет вызвана другая.Если функция
send()вызывается, и нет приостановленного вызоваreceive, готового обработать элемент, тоsend()приостанавливается. Аналогично, если функцияreceiveвызывается, и канал пуст, или, другими словами, нет приостановленного вызоваsend(), готового отправить элемент, то вызовreceive()приостанавливается.Название "rendezvous" ("встреча в оговоренное время и месте") относится к тому, что
send()иreceive()должны "встретиться вовремя".
- Конфлюэнтный канал
-
Новый элемент, отправленный в конфлюэнтный канал, перезапишет ранее отправленный элемент, поэтому получатель всегда получит только последний элемент. Вызов
send()никогда не приостанавливается.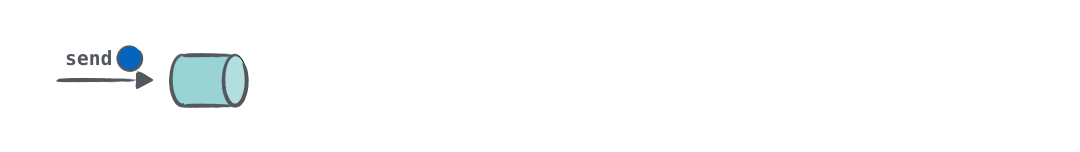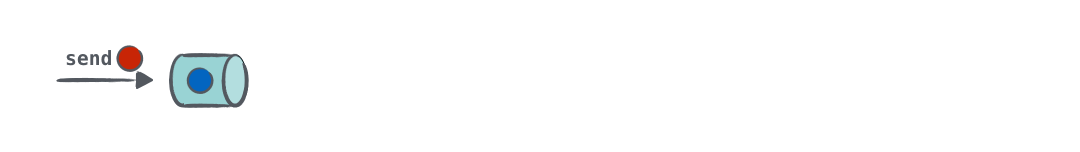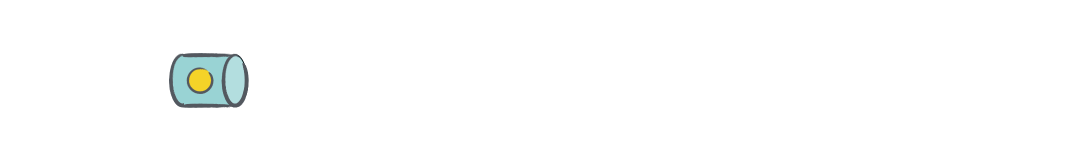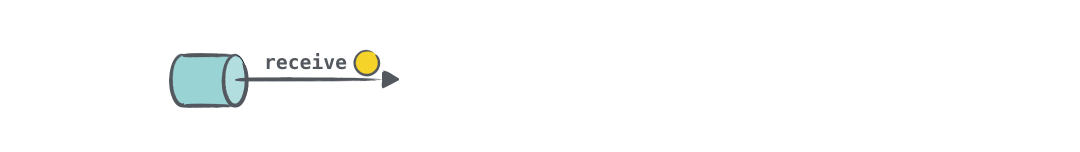
При создании канала укажите его тип или размер буфера (если вам нужен буферизованный канал):
val rendezvousChannel = Channel<String>()
val bufferedChannel = Channel<String>(10)
val conflatedChannel = Channel<String>(CONFLATED)
val unlimitedChannel = Channel<String>(UNLIMITED)
По умолчанию создаётся канал "Rendezvous".
В следующем задании вы создадите канал "Rendezvous", две корутины-производителя и корутину-потребителя:
import kotlinx.coroutines.channels.Channel
import kotlinx.coroutines.*

fun main() = runBlocking<Unit> {
    val channel = Channel<String>()
    launch {
        channel.send("A1")
        channel.send("A2")
        log("A done")
    }
    launch {
        channel.send("B1")
        log("B done")
    }
    launch {
        repeat(3) {
            val x = channel.receive()
            log(x)
        }
    }
}

fun log(message: Any?) {
    println("[${Thread.currentThread().name}] $message")
}
Задача 7
В src/tasks/Request7Channels.kt, реализуйте функцию loadContributorsChannels(), которая запрашивает всех участников GitHub одновременно и показывает промежуточный прогресс одновременно.
Используйте предыдущие функции, loadContributorsConcurrent() из Request5Concurrent.kt и loadContributorsProgress() из Request6Progress.kt.
Подсказка к задаче 7
Разные корутины, которые одновременно получают списки участников для разных репозиториев, могут отправлять все полученные результаты в один и тот же канал:
val channel = Channel<List<User>>()
for (repo in repos) {
    launch {
        val users = TODO()
        // ...
        channel.send(users)
    }
}
Затем элементы из этого канала могут быть получены по одному и обработаны:
repeat(repos.size) {
    val users = channel.receive()
    // ...
}
Поскольку вызовы receive() являются последовательными, дополнительная синхронизация не требуется.
Решение задачи 7
Как и с функцией loadContributorsProgress(), вы можете создать переменную allUsers для хранения промежуточных состояний списка "все участники". Каждый новый список, полученный из канала, добавляется в список всех пользователей. Вы агрегируете результат и обновляете состояние с помощью обратного вызова updateResults.
suspend fun loadContributorsChannels(
    service: GitHubService,
    req: RequestData,
    updateResults: suspend (List<User>, completed: Boolean) -> Unit
) = coroutineScope {

    val repos = service
        .getOrgRepos(req.org)
        .also { logRepos(req, it) }
        .bodyList()

    val channel = Channel<List<User>>()
    for (repo in repos) {
        launch {
            val users = service.getRepoContributors(req.org, repo.name)
                .also { logUsers(repo, it) }
                .bodyList()
            channel.send(users)
        }
    }
    var allUsers = emptyList<User>()
    repeat(repos.size) {
        val users = channel.receive()
        allUsers = (allUsers + users).aggregate()
        updateResults(allUsers, it == repos.lastIndex)
    }
}
Результаты для разных репозиториев добавляются в канал, как только они готовы. Сначала, когда все запросы отправлены, и данные не получены, вызов
receive()приостанавливается. В этом случае вся корутина "загрузка участников" приостанавливается.Затем, когда список пользователей отправляется в канал, корутина "загрузка участников" возобновляется, вызов
receive()возвращает этот список, и результаты немедленно обновляются.
Теперь вы можете запустить программу и выбрать опцию КАНАЛЫ, чтобы загрузить участников и увидеть результат.
Хотя ни корутины, ни каналы не устраняют полностью сложности, связанные с параллелизмом, они делают жизнь проще, когда вам нужно понять, что происходит.
Тестирование сопроцедур
Теперь давайте протестируем все решения, чтобы проверить, что решение с конкурентными сопроцедурами быстрее, чем решение с функциями suspend, и что решение с каналами быстрее, чем простое решение «прогресс».
В следующей задаче вы сравните общее время выполнения решений. Вы будете имитировать службу GitHub и заставлять эту службу возвращать результаты после заданных таймаутов:
repos request - returns an answer within 1000 ms delay
repo-1 - 1000 ms delay
repo-2 - 1200 ms delay
repo-3 - 800 ms delay
Последовательное решение с функциями suspend должно занимать около 4000 мс (4000 = 1000 + (1000 + 1200 + 800)). Конкурентное решение должно занимать около 2200 мс (2200 = 1000 + max(1000, 1200, 800)).
Для решений, которые показывают прогресс, вы также можете проверить промежуточные результаты с отметками времени.
Соответствующие тестовые данные определены в test/contributors/testData.kt, а файлы Request4SuspendKtTest, Request7ChannelsKtTest и так далее содержат простые тесты, которые используют вызовы имитируемой службы.
Однако здесь есть две проблемы:
Эти тесты занимают слишком много времени для выполнения. Каждый тест занимает около 2–4 секунд, и вам нужно каждый раз ждать результатов. Это не очень эффективно.
Вы не можете полагаться на точное время выполнения решения, потому что оно все равно занимает дополнительное время на подготовку и выполнение кода. Вы могли бы добавить константу, но тогда время будет отличаться от машины к машине. Задержки имитируемой службы должны быть больше этой константы, чтобы вы могли увидеть разницу. Если константа составляет 0,5 секунды, то задержки в 0,1 секунды будут недостаточными.
Лучшим способом было бы использовать специальные фреймворки для тестирования времени выполнения, выполняя тот же код несколько раз (что увеличивает общее время еще больше), но это сложно изучить и настроить.
Чтобы решить эти проблемы и убедиться, что решения с заданными задержками тестирования ведут себя как ожидается, одно быстрее другого, используйте виртуальное время с особым диспетчером тестов. Этот диспетчер отслеживает прошедшее виртуальное время с начала и выполняет все немедленно в реальном времени. При запуске сопроцедур на этом диспетчере delay вернется немедленно и переведет виртуальное время.
Тесты, использующие этот механизм, выполняются быстро, но вы все равно можете проверить, что происходит в разные моменты виртуального времени. Общее время выполнения резко уменьшается:
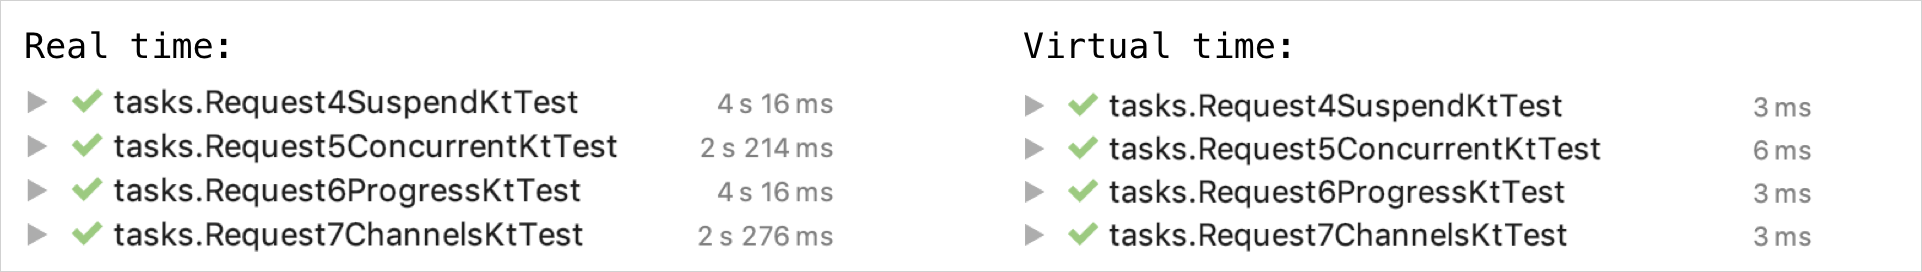
Чтобы использовать виртуальное время, замените вызов runBlocking на runTest. runTest принимает лямбда-расширение для TestScope в качестве аргумента. Когда вы вызываете delay в функции suspend внутри этого специального области действия, delay увеличит виртуальное время вместо задержки в реальном времени:
@Test
fun testDelayInSuspend() = runTest {
    val realStartTime = System.currentTimeMillis()
    val virtualStartTime = currentTime

    foo()
    println("${System.currentTimeMillis() - realStartTime} ms") // ~ 6 ms
    println("${currentTime - virtualStartTime} ms")             // 1000 ms
}

suspend fun foo() {
    delay(1000)    // auto-advances without delay
    println("foo") // executes eagerly when foo() is called
}
Текущее виртуальное время можно проверить, используя свойство currentTime объекта TestScope.
Фактическое время выполнения в этом примере составляет несколько миллисекунд, тогда как виртуальное время равно аргументу задержки, которое равно 1000 миллисекундам.
Чтобы получить полный эффект «виртуального» delay в дочерних сопроцедурах, запустите все дочерние сопроцедуры с помощью TestDispatcher. В противном случае это не сработает. Этот диспетчер автоматически наследуется от других TestScope, если вы не укажете другой диспетчер:
@Test
fun testDelayInLaunch() = runTest {
    val realStartTime = System.currentTimeMillis()
    val virtualStartTime = currentTime

    bar()

    println("${System.currentTimeMillis() - realStartTime} ms") // ~ 11 ms
    println("${currentTime - virtualStartTime} ms")             // 1000 ms
}

suspend fun bar() = coroutineScope {
    launch {
        delay(1000)    // auto-advances without delay
        println("bar") // executes eagerly when bar() is called
    }
}
Если launch вызывается в контексте Dispatchers.Default в приведенном выше примере, тест завершится неудачно. Вы получите исключение, говорящее о том, что задача еще не завершена.
Вы можете протестировать функцию loadContributorsConcurrent() таким образом только в том случае, если она запускает дочерние сопроцедуры с унаследованным контекстом, не изменяя его с помощью диспетчера Dispatchers.Default.
Вы можете указывать элементы контекста, такие как диспетчер, при вызове функции, а не при определении, что обеспечивает большую гибкость и простоту тестирования.
По умолчанию компилятор выводит предупреждения, если вы используете экспериментальный API тестирования. Чтобы подавить эти предупреждения, аннотируйте функцию теста или весь класс, содержащий тесты, с помощью @OptIn(ExperimentalCoroutinesApi::class). Добавьте аргумент компилятора, указывающий компилятору, что вы используете экспериментальный API:
compileTestKotlin {
    kotlinOptions {
        freeCompilerArgs += "-Xuse-experimental=kotlin.Experimental"
    }
}
В проекте, соответствующем этому учебнику, аргумент компилятора уже добавлен в скрипт Gradle.
Задача 8
Переработайте следующие тесты в tests/tasks/ для использования виртуального времени вместо реального времени:
Request4SuspendKtTest.kt
Request5ConcurrentKtTest.kt
Request6ProgressKtTest.kt
Request7ChannelsKtTest.kt
Сравните общее время выполнения до и после применения вашей переработки.
Подсказка для задачи 8
-
Замените вызов
runBlockingнаrunTest, аSystem.currentTimeMillis()наcurrentTime.@Test fun test() = runTest { val startTime = currentTime // action val totalTime = currentTime - startTime // testing result } Разкомментируйте утверждения, которые проверяют точное виртуальное время.
Не забудьте добавить
@UseExperimental(ExperimentalCoroutinesApi::class).
Решение задачи 8
Вот решения для конкурентных и канальных случаев:
fun testConcurrent() = runTest {
    val startTime = currentTime
    val result = loadContributorsConcurrent(MockGithubService, testRequestData)
    Assert.assertEquals("Wrong result for 'loadContributorsConcurrent'", expectedConcurrentResults.users, result)
    val totalTime = currentTime - startTime

    Assert.assertEquals(
        "The calls run concurrently, so the total virtual time should be 2200 ms: " +
                "1000 for repos request plus max(1000, 1200, 800) = 1200 for concurrent contributors requests)",
        expectedConcurrentResults.timeFromStart, totalTime
    )
}
Сначала убедитесь, что результаты доступны ровно в ожидаемое виртуальное время, а затем проверьте сами результаты:
fun testChannels() = runTest {
    val startTime = currentTime
    var index = 0
    loadContributorsChannels(MockGithubService, testRequestData) { users, _ ->
        val expected = concurrentProgressResults[index++]
        val time = currentTime - startTime
        Assert.assertEquals(
            "Expected intermediate results after ${expected.timeFromStart} ms:",
            expected.timeFromStart, time
        )
        Assert.assertEquals("Wrong intermediate results after $time:", expected.users, users)
    }
}
Первый промежуточный результат для последней версии с каналами становится доступным раньше, чем версия прогресса, и вы можете увидеть разницу в тестах, использующих виртуальное время.
Что дальше
Посмотрите мастер-класс Асинхронное программирование с Kotlin на KotlinConf.
Узнайте больше об использовании виртуального времени и экспериментального пакета тестирования.
© 2010–2023 JetBrains s.r.o. and Kotlin Programming Language contributors
Licensed under the Apache License, Version 2.0.
https://kotlinlang.org/docs/coroutines-and-channels.html


