Индексирование
ndarrays можно индексировать, используя стандартный синтаксис Python x[obj], где x – это массив, а obj – выборка. Доступны три типа индексирования: доступ к полю, базовое срезание, расширенное индексирование. Какой из них используется, зависит от obj.
Примечание
В Python x[(exp1, exp2, ..., expN)] эквивалентно x[exp1, exp2, ..., expN]; последнее является просто синтаксическим сахаром для первого.
Базовое срезание и индексирование
Базовое срезание расширяет базовое понятие срезания Python до N измерений. Базовое срезание происходит, когда obj является объектом slice (созданный с помощью start:stop:step обозначения в скобках), целым числом или кортежем из объектов среза и целых чисел. Ellipsis и newaxis объекты также могут быть вставлены в эти последовательности. Для обеспечения обратной совместимости с распространенным использованием в Numeric, базовое срезание также инициируется, если объект выбора — это любая последовательность, не являющаяся массивом ndarray (например, list), содержащая slice объекты, Ellipsis объект или newaxis объект, но не для массивов целых чисел или других вложенных последовательностей.
В самом простом случае индексирования с N целыми числами возвращается массив скаляр, представляющий соответствующий элемент. Как и в Python, все индексы основаны на нуле: для i-го индекса  , допустимый диапазон составляет
 , где
 — это i-й элемент формы массива. Отрицательные индексы интерпретируются как подсчет с конца массива (т.е., если
 , это означает
 ).
Все массивы, сгенерированные с помощью базового срезания, всегда являются views исходного массива.
Стандартные правила срезания последовательностей применяются к базовому срезанию на основе каждого измерения (включая использование индекса шага). Некоторые полезные понятия, которые следует помнить:
-
Синтаксис базового среза —
i:j:k, где i — начальный индекс, j — конечный индекс, а k — шаг ( ). Это выбирает m элементов (в соответствующем измерении) с индексами i, i + k, ..., i + (m - 1) k, где
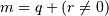 , а q и r — частное и остаток, полученные при делении j - i на k: j - i = q k + r, так что i + (m - 1) k < j.
Пример
>>> x = np.array([0, 1, 2, 3, 4, 5, 6, 7, 8, 9])
>>> x[1:7:2]
array([1, 3, 5])
-
Отрицательные i и j интерпретируются как n + i и n + j, где n — количество элементов в соответствующем измерении. Отрицательный k изменяет направление шага к меньшим индексам.
Пример
>>> x[-2:10]
array([8, 9])
>>> x[-3:3:-1]
array([7, 6, 5, 4])
-
Предположим, что n — количество элементов в измерении, которое подлежит срезанию. Если i не указан, он по умолчанию равен 0 для k > 0 и n - 1 для k < 0. Если j не указан, он по умолчанию равен n для k > 0 и -1 для k < 0. Если k не указан, он по умолчанию равен 1. Обратите внимание, что
::эквивалентно:и означает выбор всех индексов вдоль этой оси.Пример
>>> x[5:]
array([5, 6, 7, 8, 9])
-
Если число объектов в кортеже выбора меньше, чем N, то
:предполагается для последующих измерений.Пример
>>> x = np.array([[[1],[2],[3]], [[4],[5],[6]]]) >>> x.shape (2, 3, 1) >>> x[1:2] array([[[4], [5], [6]]]) -
Ellipsisрасширяется до необходимого числа:объектов, чтобы сформировать кортеж выбора той же длины, что иx.ndim. Может присутствовать только один многоточие.Пример
>>> x[...,0] array([[1, 2, 3], [4, 5, 6]]) -
Каждый
newaxisобъект в кортеже выбора служит для расширения измерений результирующей выборки на одну единицу длины измерения. Добавляемое измерение является позициейnewaxisобъекта в кортеже выбора.Пример
>>> x[:,np.newaxis,:,:].shape
(2, 1, 3, 1)
- Целое число i возвращает те же значения, что и
i:i+1за исключением того, что размерность возвращаемого объекта уменьшается на 1. В частности, кортеж выбора с p-м элементом целым числом (и все другие записи:) возвращает соответствующий подмассив с размерностью N - 1. Если N = 1, то возвращаемый объект — это скаляр массива. Эти объекты описаны в Скаляры. - Если кортеж выбора содержит все записи
:за исключением p-й записи, которая является объектом срезаi:j:k, то возвращаемый массив имеет размерность N, сформированную путем конкатенации подмассивов, возвращаемых индексированием целыми числами элементов i, i + k, ..., i + (m - 1) k < j, -
Базовое срезание с более чем одной не-
:записью в кортеже срезания действует как многократное применение срезания с использованием одной не-:записи, где не-:записи последовательно берутся (при этом все другие не-:записи заменяются:). Таким образом,x[ind1,...,ind2,:]действует какx[ind1][...,ind2,:]при базовом срезании.Предупреждение
Вышесказанное не верно для расширенного индексирования.
- Вы можете использовать срезание для задания значений в массиве, но (в отличие от списков) вы никогда не сможете увеличить массив. Размер значения, которое нужно задать в
x[obj] = value, должен быть (совместимым по передаче) с той же формой, что иx[obj].
Примечание
Помните, что кортеж среза всегда можно создать как obj и использовать в x[obj] обозначении. Объекты среза можно использовать в структуре вместо [start:stop:step] обозначения. Например, x[1:10:5,::-1] также можно реализовать как obj = (slice(1,10,5), slice(None,None,-1)); x[obj]. Это может быть полезно для создания универсального кода, работающего с массивами произвольной размерности.
-
numpy.newaxis -
Объект
newaxisможно использовать во всех операциях срезания для создания оси длиной один.newaxisявляется псевдонимом для ‘None’, и ‘None’ можно использовать вместо этого с тем же результатом.
Расширенное индексирование
Расширенное индексирование активируется, когда объект выбора obj является объектом последовательности, не являющимся кортежем, массивом ndarray (типа данных целое число или логическое значение) или кортежем по крайней мере с одним объектом последовательности или массивом ndarray (типа данных целое число или логическое значение). Существуют два типа расширенного индексирования: целочисленное и булево.
Расширенное индексирование всегда возвращает копию данных (в отличие от базового срезания, которое возвращает view).
Предупреждение
Определение расширенного индексирования означает, что x[(1,2,3),] фундаментально отличается от x[(1,2,3)]. Последнее эквивалентно x[1,2,3], что вызовет базовую выборку, в то время как первое вызовет расширенное индексирование. Убедитесь, что вы понимаете, почему это происходит.
Также обратите внимание, что x[[1,2,3]] вызовет расширенное индексирование, а x[[1,2,slice(None)]] вызовет базовое срезание.
Индексирование массивом целых чисел
Индексирование массивом целых чисел позволяет выбирать произвольные элементы в массиве на основе их N-мерных индексов. Каждый массив целых чисел представляет ряд индексов в этом измерении.
Индексирование исключительно массивом целых чисел
Когда индекс состоит из тех же массивов целых чисел, что и массив, который индексируется, индексирование прямолинейно, но отличается от срезания.
Расширенные индексы всегда расширяются и обрабатываются как единое:
result[i_1, ..., i_M] == x[ind_1[i_1, ..., i_M], ind_2[i_1, ..., i_M],
                           ..., ind_N[i_1, ..., i_M]]
Обратите внимание, что форма результата идентична форме массива индексов (с расширением) ind_1, ..., ind_N.
Пример
Из каждой строки необходимо выбрать определенный элемент. Индекс строки — это просто [0, 1, 2], а индекс столбца указывает элемент для выбора в соответствующей строке, здесь [0, 1, 0]. Используя их вместе, задача может быть решена с помощью расширенного индексирования:
>>> x = np.array([[1, 2], [3, 4], [5, 6]])
>>> x[[0, 1, 2], [0, 1, 0]]
array([1, 4, 5])
Для достижения поведения, аналогичного базовому срезанию, можно использовать передачу. Функция ix_ может помочь с этой передачей. Это лучше всего понять на примере.
Пример
Из массива 4x3 должны быть выбраны угловые элементы с использованием расширенного индексирования. Таким образом, необходимо выбрать все элементы, для которых столбец является одним из [0, 2] и строка — одним из [0, 3]. Чтобы использовать расширенное индексирование, необходимо выбрать все элементы явно. Используя описанный ранее метод, можно написать:
>>> x = array([[ 0,  1,  2],
...            [ 3,  4,  5],
...            [ 6,  7,  8],
...            [ 9, 10, 11]])
>>> rows = np.array([[0, 0],
...                  [3, 3]], dtype=np.intp)
>>> columns = np.array([[0, 2],
...                     [0, 2]], dtype=np.intp)
>>> x[rows, columns]
array([[ 0,  2],
       [ 9, 11]])
Однако, поскольку индексирующие массивы выше просто повторяют сами себя, для упрощения можно использовать вещание (сравнение операций, таких как rows[:, np.newaxis] + columns) :
>>> rows = np.array([0, 3], dtype=np.intp)
>>> columns = np.array([0, 2], dtype=np.intp)
>>> rows[:, np.newaxis]
array([[0],
       [3]])
>>> x[rows[:, np.newaxis], columns]
array([[ 0,  2],
       [ 9, 11]])
Это вещание также можно получить с помощью функции ix_:
>>> x[np.ix_(rows, columns)]
array([[ 0,  2],
       [ 9, 11]])
Обратите внимание, что без вызова np.ix_, будут выбраны только диагональные элементы, как и в предыдущем примере. Это различие является наиболее важным, что нужно запомнить об индексировании с помощью нескольких продвинутых индексов.
Объединение продвинутого и базового индексирования
Когда в индексе есть хотя бы один срез (:), эллипсис (...) или np.newaxis, или массив имеет больше измерений, чем продвинутых индексов, поведение может быть более сложным. Это похоже на конкатенацию результата индексирования для каждого элемента продвинутого индекса
В самом простом случае есть только один продвинутый индекс. Один продвинутый индекс, например, может заменить срез, и массив результата будет таким же, однако, это копия, и она может иметь другое расположение памяти. Срез предпочтительнее, когда это возможно.
Пример
>>> x[1:2, 1:3]
array([[4, 5]])
>>> x[1:2, [1, 2]]
array([[4, 5]])
Самый простой способ понять ситуацию — это подумать о форме результата. Операция индексирования состоит из двух частей: подпространство, определённое базовым индексированием (исключая целые числа), и подпространство от продвинутой части индексирования. Необходимо различать два случая комбинации индексов:
- Продвинутые индексы разделены срезом, эллипсисом или newaxis. Например,
x[arr1, :, arr2]. - Продвинутые индексы расположены друг за другом. Например,
x[..., arr1, arr2, :], но неx[arr1, :, 1], так как1является продвинутым индексом в этом смысле.
В первом случае измерения, полученные в результате операции продвинутого индексирования, появляются первыми в результирующем массиве, а измерения подпространства после этого. Во втором случае измерения из операций продвинутого индексирования вставляются в результирующий массив в том же месте, что и в исходном массиве (последняя логика делает простое продвинутое индексирование таким же, как и срезы).
Пример
Предположим, что x.shape имеет форму (10,20,30), а ind — это (2,3,4)-массив индексирования intp, тогда result = x[...,ind,:] имеет форму (10,2,3,4,30), потому что (20,)-образное подпространство было заменено на (2,3,4)-образное вещательное индексирующее подпространство. Если мы запустим цикл i, j, k по (2,3,4)-образному подпространству, то result[...,i,j,k,:] = x[...,ind[i,j,k],:]. Этот пример даёт тот же результат, что и x.take(ind, axis=-2).
Пример
Пусть x.shape будет (10,20,30,40,50), и предположим, что ind_1 и ind_2 могут быть вещаемы до формы (2,3,4). Тогда x[:,ind_1,ind_2] имеет форму (10,2,3,4,40,50), потому что (20,30)-образное подпространство из X было заменено на (2,3,4)-образное подпространство из индексов. Однако, x[:,ind_1,:,ind_2] имеет форму (2,3,4,10,30,50), потому что нет однозначного места для вставки индексирующего подпространства, поэтому оно присоединяется к началу. Всегда можно использовать .transpose(), чтобы переместить подпространство куда угодно. Обратите внимание, что этот пример нельзя воспроизвести с помощью take.
Индексирование булевыми массивами
Это продвинутое индексирование происходит, когда obj — это массив объекта булевого типа, такой как может быть возвращён операторами сравнения. Один булев массив индексов практически идентичен x[obj.nonzero()], где, как описано выше, obj.nonzero() возвращает кортеж (длины obj.ndim) целочисленных массивов индексов, показывающих True элементы obj. Однако это быстрее, когда obj.shape == x.shape.
Если obj.ndim == x.ndim, x[obj] возвращает одномерный массив, заполненный элементами x, соответствующими True значениям obj. Порядок поиска будет row-major, C-подобный. Если obj имеет True значения в записях, которые находятся вне границ x, то будет выброшено исключение индекса. Если obj меньше x, то это идентично заполнению его False.
Пример
Распространённое использование этого — фильтрация для желаемых значений элементов. Например, можно выбрать все записи из массива, которые не являются NaN:
>>> x = np.array([[1., 2.], [np.nan, 3.], [np.nan, np.nan]])
>>> x[~np.isnan(x)]
array([ 1.,  2.,  3.])
Или добавить константу ко всем отрицательным элементам:
>>> x = np.array([1., -1., -2., 3])
>>> x[x < 0] += 20
>>> x
array([  1.,  19.,  18.,   3.])
В общем случае, если индекс включает булев массив, результат будет идентичен вставке obj.nonzero() в то же положение и использованию механизма индексирования целочисленного массива, описанного выше. x[ind_1, boolean_array, ind_2] эквивалентно x[(ind_1,) + boolean_array.nonzero() + (ind_2,)].
Если присутствует только один булев массив и нет массива целочисленных индексов, это просто. Нужно только убедиться, что булев индекс имеет ровно столько измерений, сколько предполагается.
Пример
Из массива выберите все строки, сумма которых меньше или равна двум:
>>> x = np.array([[0, 1], [1, 1], [2, 2]])
>>> rowsum = x.sum(-1)
>>> x[rowsum <= 2, :]
array([[0, 1],
       [1, 1]])
Но если rowsum будет также иметь два измерения:
>>> rowsum = x.sum(-1, keepdims=True)
>>> rowsum.shape
(3, 1)
>>> x[rowsum <= 2, :]    # fails
IndexError: too many indices
>>> x[rowsum <= 2]
array([0, 1])
Последнее даёт только первые элементы из-за дополнительного измерения. Сравните rowsum.nonzero() для понимания этого примера.
Объединение нескольких булевых массивов индексирования или булева с массивом целочисленного индексирования лучше всего понять с помощью аналогии obj.nonzero(). Функция ix_ также поддерживает булевы массивы и будет работать без неожиданностей.
Пример
Используйте булевое индексирование для выбора всех строк, сумма которых является чётным числом. В то же время столбцы 0 и 2 должны быть выбраны с помощью продвинутого целочисленного индекса. С помощью функции ix_ это можно сделать так:
>>> x = array([[ 0,  1,  2],
...            [ 3,  4,  5],
...            [ 6,  7,  8],
...            [ 9, 10, 11]])
>>> rows = (x.sum(-1) % 2) == 0
>>> rows
array([False,  True, False,  True], dtype=bool)
>>> columns = [0, 2]
>>> x[np.ix_(rows, columns)]
array([[ 3,  5],
       [ 9, 11]])
Без вызова np.ix_ или только диагональные элементы были бы выбраны.
Или без np.ix_ (сравните примеры с целочисленным массивом):
>>> rows = rows.nonzero()[0]
>>> x[rows[:, np.newaxis], columns]
array([[ 3,  5],
       [ 9, 11]])
Подробные заметки
Это некоторые подробные заметки, которые не важны для ежедневного индексирования (в произвольном порядке):
- Родной тип индексирования NumPy —
intp, и он может отличаться от типа целочисленного массива по умолчанию.intp— наименьший тип данных, достаточный для безопасного индексирования любого массива; для продвинутого индексирования он может быть быстрее, чем другие типы. - Для продвинутых присваиваний, в общем случае, нет гарантии порядка итераций. Это означает, что если элемент устанавливается более одного раза, то конечный результат невозможно предсказать.
- Пустой (кортеж) индекс — это полный скалярный индекс в нулемерный массив.
x[()]возвращает скаляр, еслиxимеет нулевое измерение, и представление в противном случае. С другой стороны,x[...]всегда возвращает представление. - Если нулемерный массив присутствует в индексе и это полный целочисленный индекс, результат будет скалярным, а не нулемерным массивом. (Продвинутое индексирование не запускается.)
- Когда эллипсис (
...) присутствует, но не имеет размера (т. е. заменяет ноль:), результат по-прежнему всегда будет массивом. Представление, если нет продвинутого индекса, в противном случае копия. - Эквивалентность
nonzeroдля булевых массивов не выполняется для нулемерных булевых массивов. - Когда результат операции продвинутого индексирования не имеет элементов, но отдельный индекс выходит за пределы, то, будет ли выброшено исключение
IndexError, не определено (например,x[[], [123]]с123выходящим за пределы). - Когда возникает ошибка преобразования при присваивании (например, обновление числового массива с помощью последовательности строк), массив, которому присваивается значение, может оказаться в непредсказуемом частично обновлённом состоянии. Однако, если возникает любая другая ошибка (например, индекс выходит за пределы), массив останется неизменным.
- Расположение памяти результата продвинутого индексирования оптимизируется для каждой операции индексирования, и нельзя предположить какой-либо конкретный порядок памяти.
- При использовании подкласса (особенно того, который управляет своей формой), стандартное поведение
ndarray.__setitem__вызовет__getitem__для базового индексирования, но не для продвинутого индексирования. Для такого подкласса предпочтительнее вызватьndarray.__setitem__с представлением ndarray базового класса на данных. Это должно быть выполнено, если подклассы__getitem__не возвращают представления.
Доступ к полям массива
См. также
Если объект ndarray является структурированным массивом, то к fields массива можно получить доступ, индексируя массив строками, как словарь.
Индексирование x['field-name'] возвращает новое view к массиву, форма которого такая же, как и у x (кроме случаев, когда поле является подмассивом), но тип данных x.dtype['field-name'] и содержит только часть данных в указанном поле. Также скаляры массива записей могут быть «индексированы» таким образом.
Индексирование в структурированный массив также можно выполнить со списком имён полей, например x[['field-name1','field-name2']]. В настоящее время это возвращает новый массив, содержащий копию значений в указанных полях. С NumPy 1.7 возвращение копии устаревает в пользу возвращения представления. Копия по-прежнему будет возвращаться, но будет выведено предупреждение FutureWarning при записи в копию. Если вы зависите от текущего поведения, то мы рекомендуем скопировать возвращаемый массив явно, т. е. используйте x[[‘field-name1’,’field-name2’]].copy(). Это будет работать как с прошлыми, так и с будущими версиями NumPy.
Если доступное поле является подмассивом, то измерения подмассива добавляются к форме результата.
Пример
>>> x = np.zeros((2,2), dtype=[('a', np.int32), ('b', np.float64, (3,3))])
>>> x['a'].shape
(2, 2)
>>> x['a'].dtype
dtype('int32')
>>> x['b'].shape
(2, 2, 3, 3)
>>> x['b'].dtype
dtype('float64')
Индексирование плоского итератора
x.flat возвращает итератор, который будет перебирать весь массив (в стиле C-непрерывности, где последний индекс изменяется быстрее всего). Этот объект итератора также может быть индексирован с использованием базовых срезов или расширенного индексирования, если объект выбора не является кортежем. Это должно быть понятно из того факта, что x.flat представляет собой одномерный вид. Он может использоваться для целочисленной индексации с одномерными индексами в стиле C. Таким образом, форма любого возвращаемого массива соответствует форме объекта целочисленного индексирования.
© 2008–2017 NumPy Developers
Licensed under the NumPy License.
https://docs.scipy.org/doc/numpy-1.12.0/reference/arrays.indexing.html


