Запрос или чтение данных
OpenTSDB предоставляет несколько способов извлечения данных, таких как инструменты командной строки, HTTP-API и графики GnuPlot. Запросы с использованием системы тегов OpenTSDB могут быть немного сложными, поэтому ознакомьтесь с этим документом и проверьте следующие страницы для более подробной информации. Примеры запросов на этой странице следуют формату HTTP-API.
Компоненты запроса
Язык запросов OpenTSDB довольно прост, но гибкий. Каждый запрос состоит из следующих компонентов:
| Параметр | Тип данных | Обязательно | Описание | Пример |
|---|---|---|---|---|
| Начальное время | Строка или целое число | Да | Начальное время для запроса. Это может быть абсолютное или относительное время. Подробности см. в разделе Даты и время | 24h-ago |
| Конечное время | Строка или целое число | Нет | Конечное время для запроса. Если конечное время не указано, используется текущее время на TSD. Подробности см. в разделе Даты и время. | 1h-ago |
| Метрика | Строка | Да | Полное имя метрики в системе. Должно быть полным именем. Чувствительно к регистру | sys.cpu.user |
| Функция агрегации | Строка | Да | Математическая функция для объединения нескольких временных рядов | sum |
| Теги | Строка | Нет | Необязательный набор тегов для фильтрации или группировки | host=*,dc=lax |
| Ресамплер | Строка | Нет | Необязательный интервал и функция для уменьшения количества возвращаемых точек данных | 1h-avg |
| Скорость | Строка | Нет | Необязательный флаг для расчета скорости изменения результата | rate |
Временные метки
Абсолютные временные метки поддерживаются в удобочитаемом формате или в виде целых чисел Unix-стиля. Для обновления панелей мониторинга могут использоваться относительные временные метки. В настоящее время все запросы способны охватывать один временной интервал. В будущем мы надеемся предоставить параметр смещения запроса, который позволит производить агрегацию или построение графиков метрики за разные временные интервалы, например, сравнивая прошлую неделю с прошлым годом. Подробности см. в разделе Даты и время.
Хотя OpenTSDB может хранить данные с разрешением миллисекунды, большинство запросов будут возвращать данные с разрешением секунды для обеспечения обратной совместимости с существующими инструментами. Если в запросе не указан алгоритм ресемплинга, данные автоматически ресемплируются до 1 секунды с использованием той же функции агрегации, что и в запросе. Таким образом, если для данного интервала секунды хранится несколько точек данных, они будут агрегированы и корректно возвращены в обычном запросе.
Для извлечения данных с разрешением миллисекунды используйте конечную точку /api/query и укажите параметр JSON msResolution (ms` также допустимо, но не рекомендуется) или флаг строки запроса, чтобы обойти ресемплирование (если не указано) и вернуть все временные метки с разрешением миллисекунды эпохи Unix. Кроме того, утилита командной строки scan вернёт временную метку в формате, используемом для хранения.
Теги
Каждый временной ряд состоит из метрики и одной или нескольких пар имя/значение тегов. Поскольку теги необязательны в запросах, если вы запросите только имя метрики, то будут возвращены все метрики с любым количеством или значениями тегов в агрегированных результатах. Например, если у нас есть набор хранимых данных:
sys.cpu.user host=webserver01,cpu=0  1356998400  1
sys.cpu.user host=webserver01,cpu=1  1356998400  4
sys.cpu.user host=webserver02,cpu=0  1356998400  2
sys.cpu.user host=webserver02,cpu=1  1356998400  1
и мы просто создадим запрос start=1356998400&m=sum:sys.cpu.user, мы получим значение 8 в момент 1356998400, включающее все 4 временных ряда.
Если мы хотим агрегировать результаты для конкретной группы, мы можем отфильтровать по тегу host. Запрос start=1356998400&m=sum:sys.cpu.user{host=webserver01} вернёт значение 5, включающее только временные ряды, где host=webserver01. Для детализации по конкретному временному ряду необходимо указать все теги для ряда, например, start=1356998400&m=sum:sys.cpu.user{host=webserver01,cpu=0} вернёт 1.
Примечание
Несогласованные теги могут привести к непредсказуемым результатам при запросе. Подробности см. в ../writing.
Группировка
Запрос также может агрегировать временные ряды с несколькими тегами в группы на основе значения тега. Можно использовать два специальных символа справа от знака равенства в запросе:
- * - Звездочка вернёт отдельный результат для каждого уникального значения тега.
- | - Пайп вернёт отдельный результат *только* для указанных точных значений тегов.
Рассмотрим следующий набор данных в качестве примера:
sys.cpu.user host=webserver01,cpu=0  1356998400  1
sys.cpu.user host=webserver01,cpu=1  1356998400  4
sys.cpu.user host=webserver02,cpu=0  1356998400  2
sys.cpu.user host=webserver02,cpu=1  1356998400  1
sys.cpu.user host=webserver03,cpu=0  1356998400  5
sys.cpu.user host=webserver03,cpu=1  1356998400  3
Если мы хотим запросить среднее время работы ЦП для каждого сервера, мы можем создать запрос типа start=1356998400&m=avg:sys.cpu.user{host=*}. Это даст нам три результата:
- Агрегированное среднее значение для
sys.cpu.user host=webserver01,cpu=0иsys.cpu.user host=webserver01,cpu=1 - Агрегированное среднее значение для
sys.cpu.user host=webserver02,cpu=0иsys.cpu.user host=webserver02,cpu=1 - Агрегированное среднее значение для
sys.cpu.user host=webserver03,cpu=0иsys.cpu.user host=webserver03,cpu=1
Однако, если в системе много веб-серверов, это может привести к большому количеству результатов. Чтобы отфильтровать только нужные хосты, вы можете использовать оператор пайпа для выбора подмножества временных рядов. Например, start=1356998400&m=avg:sys.cpu.user{host=webserver01|webserver03} вернёт результаты только для webserver01 и webserver03.
С версии 2.2 можно включить или отключить группировку по тегам фильтра. Доступны дополнительные фильтры, включая подстановочные знаки и регулярные выражения.
Явные теги
Начиная с версии 2.3 и выше, если вы знаете все ключи тегов для данного запроса метрики, задержка запроса может быть значительно улучшена, если использовать функцию explicitTags и убедиться, что tsd.query.enable_fuzzy_filter включена в конфигурации. Для HBase задаётся специальный фильтр, который позволяет пропустить строки, которые нам нужны для запроса, вместо итерирования по каждому ключу строки и сравнения с регулярным выражением.
Например, используя набор данных выше, если нас интересуют только метрики, где host=webserver02, и есть сотни хостов, вы можете создать запрос, например, start=1356998400&m=avg:explicit_tags:sys.cpu.user{host=webserver02,cpu=*}. Обратите внимание, что вы должны указать каждый тег, присутствующий во временном ряде, для корректной работы, и вы можете решить, нужно ли группировать по дополнительным тегам.
Агрегация
Мощная функция OpenTSDB — возможность выполнения агрегации нескольких временных рядов на лету, объединяя их в один набор данных. Исходные данные всегда доступны в хранилище, но мы можем быстро извлечь их осмысленным образом. Функции агрегации — это способ объединения двух или более точек данных для одной временной метки в одно значение. Подробности см. в разделе Агрегаторы.
Интерполяция
При выполнении агрегации, что происходит, если временные метки точек данных для каждого временного ряда не совпадают? Допустим, мы фиксируем температуру каждые 5 минут в разных регионах мира. Датчик в Париже может сообщить температуру 27c в 1356998400. Затем датчик в Сан-Франциско может сообщить значение 18c через 30 секунд в 1356998430. Антарктида может сообщить -29c в 1356998529. Если мы выполним запрос, запрашивающий среднюю температуру, мы хотим, чтобы все точки данных были усреднены в одну точку. Здесь на помощь приходит **интерполяция**. Подробности см. в разделе Агрегаторы.
Ресемплирование
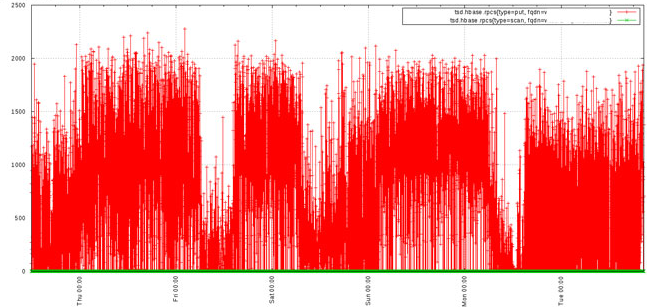
OpenTSDB может принимать большое количество данных, даже точки данных каждую секунду для данного временного ряда. Таким образом, запросы могут возвращать большое количество точек данных. Доступ к результатам запроса с большим количеством точек из API может съесть пропускную способность. Высокая частота данных может легко перегрузить графические библиотеки Javascript, поэтому используется GnuPlot. Графики, созданные с помощью интерфейса, могут быть трудночитаемыми, что приводит к толстым линиям, таким как график ниже:
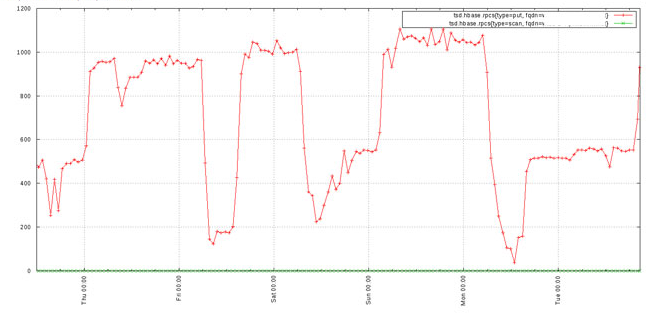
Ресемплирование можно использовать во время запроса для уменьшения количества возвращаемых точек данных, чтобы можно было извлечь более полезную информацию из графика или передать меньше данных по соединению. Ресемплирование требует **функции агрегации** и **временного интервала**. Функция агрегации используется для вычисления новой точки данных по всем точкам данных в указанном интервале с помощью соответствующей математической функции. Например, если используется функция агрегации sum, то все точки данных в интервале суммируются в одно значение. Если выбрана функция avg, то возвращается среднее значение всех точек данных в интервале.
Интервалы задаются числом и единицей времени. Например, 30m агрегирует точки данных каждые 30 минут. 1h агрегирует за час. Допустимые единицы относительного времени см. в разделе Даты и время. Не добавляйте -ago к запросу ресемплирования.
Используя ресемплирование, мы можем очистить предыдущий график, чтобы получить что-то гораздо более полезное:
Начиная с версии 2.1, временные метки ресемплированных данных нормализуются на основе остатка от деления исходной временной метки точки данных на интервал ресемплирования в миллисекундах, т.е. модуля. В Java код выглядит так timestamp - (timestamp % interval_ms). Например, при временной метке 1388550980000, или 1/1/2014 04:36:20 UTC и часовом интервале, равном 3600000 миллисекундам, результирующая временная метка будет округляться до 1388548800000. Все точки данных между 4 и 5 часами UTC попадут в корзину 4 часов.
Нормализация работает очень хорошо для обычных запросов, таких как сведение данных за день с шагом в 1 минуту или 1 час. Однако, если вы попытаетесь выполнить сведение с нестандартным интервалом, например, 36 минут, то отметки времени могут выглядеть немного странно из-за особенностей вычисления остатка. При интервале в 36 минут и нашем примере выше, интервал будет 2160000 миллисекунд, а результирующая отметка времени 1388549520 или 04:12:00 UTC. Все точки данных между 04:12 и 04:48 попадут в один и тот же блок. Обратите также внимание, что OpenTSDB в настоящее время не может нормализовать данные по временным зонам, отличным от UTC, и не может нормализовать данные по еженедельным или ежемесячным границам.
В версии 2.2 запрос сведения может генерировать NaN или null, когда в блоке сведения отсутствует значение для всех участвующих рядов. Поскольку OpenTSDB в настоящее время не позволяет хранить явные NaN-значения и не накладывает конкретные интервалы на хранение, это можно использовать для имитации систем, которые это делают, таких как RRD.
Примечание
До версии 2.1 отметки времени не нормализовались. Блоки рассчитывались на основе начального времени первой точки данных, полученной для каждого ряда, а затем ряд подвергался интерполяции. Это означает, что на графике могут быть различные пробелы между значениями и возвращаться больше значений, чем ожидалось.
Скорость
Некоторые источники данных возвращают значения в виде постоянно увеличивающихся счетчиков. Примером является счетчик посещений веб-сайта. Когда вы запускаете веб-сервер, счетчик посещений может быть равен 0. Через пять минут значение может составить 1024. Через ещё пять минут – 2048. График для счетчика будет представлять собой приблизительно прямую линию, наклоненную вверх вправо, и не всегда бывает очень полезным. OpenTSDB предоставляет ключевое слово rate, которое рассчитывает скорость изменения значений во времени. Это позволит преобразовать счетчики в линии с пиками, показывающими моменты активности, что может быть гораздо полезнее.
Скорость является первой производной значений. Она определяется как (v2 - v1) / (t2 - t1). Поэтому вы получите скорость изменения в секунду. В настоящее время скорость изменения между значениями миллисекунд по умолчанию вычисляется в секундах.
OpenTSDB 2.0 поддерживает обработку данных специальных счетчиков с монотонным увеличением, включая возможность установки значения «переполнения» и подавление аномальных колебаний. При указании значения counterMax в запросе, если значение точки данных приближается к этому значению, а последующая точка меньше предыдущей, для расчета точной скорости используется максимальное значение, исходя из этих двух точек. Например, если мы записывали целочисленный счетчик в 2 байта, максимальное значение составило бы 65535. Если значение в t0 равно 64000, а значение в t1 равно 1000, результирующая скорость в секунду будет вычислена как -63000. Однако, мы знаем, что счетчик, скорее всего, переполнился, поэтому мы можем установить максимум в 65535, и теперь вычисление будет 65535 - t0 + t1, что даст нам 2535.
Системы, которые отслеживают данные в виде счетчиков, часто возвращаются к 0 при перезапуске. Когда это происходит, при использовании функции максимального счетчика мы можем получить ложный результат. Например, если счетчик достиг значения 2000 в t0, и кто-то перезапустил сервер, следующее значение может быть 500 в t1. Если мы установим наш максимум в 65535, результат будет 65535 - 2000 + 500, что даст нам 64035. Если обычная скорость составляет несколько точек в секунду, этот конкретный скачок, с 30s между точками, создаст пик скорости 2,134.5! Чтобы избежать этого, мы можем установить resetValue, которое, когда скорость превысит это значение, вернет значение 0, чтобы избежать пиков в любом направлении. Для примера выше, если мы знаем, что наша скорость почти никогда не превышает 100, мы можем настроить resetValue на 100, и когда будет рассчитана точка данных выше, она вернет 0 вместо 2,134.5. Значение по умолчанию 0 означает, что значение сброса будет проигнорировано, никакие скорости не будут подавлены.
Порядок операций
Понимание порядка операций важно. При возврате результатов запроса следующий порядок обработки:
- Группировка
- Сведение
- Интерполяция
- Агрегирование
- Расчёт скорости
© 2010–2016 The OpenTSDB Authors
Licensed under the GNU LGPLv2.1+ and GPLv3+ licenses.
http://opentsdb.net/docs/build/html/user_guide/query/index.html


