статистики — Функции математической статистики
Добавлен в версии 3.4.
Исходный код: Lib/statistics.py
Этот модуль предоставляет функции для вычисления математических статистик числовых (Real-значных) данных.
Модуль не предназначен для конкуренции с сторонними библиотеками, такими как NumPy, SciPy, или специализированными статистическими пакетами, предназначенными для профессиональных статистиков, такими как Minitab, SAS и Matlab. Он нацелен на уровень графиков и научных калькуляторов.
За исключением явно указанного, эти функции поддерживают int, float, Decimal и Fraction. Поведение с другими типами (как в числовой иерархии, так и вне её) в настоящее время не поддерживается. Сборники с комбинацией типов также не определены и зависят от реализации. Если ваши входные данные содержат смешанные типы, вы можете использовать map(), чтобы гарантировать согласованный результат, например: map(float, input_data).
В некоторых наборах данных используются значения NaN (не число) для представления отсутствующих данных. Поскольку NaN имеют необычные семантики сравнения, они вызывают неожиданное или неопределённое поведение в статистических функциях, которые сортируют данные или подсчитывают случаи. Затронутыми функциями являются median(), median_low(), median_high(), median_grouped(), mode(), multimode(), и quantiles(). Значения NaN должны быть удалены перед вызовом этих функций:
>>> from statistics import median
>>> from math import isnan
>>> from itertools import filterfalse

>>> data = [20.7, float('NaN'),19.2, 18.3, float('NaN'), 14.4]
>>> sorted(data)  # This has surprising behavior
[20.7, nan, 14.4, 18.3, 19.2, nan]
>>> median(data)  # This result is unexpected
16.35

>>> sum(map(isnan, data))    # Number of missing values
2
>>> clean = list(filterfalse(isnan, data))  # Strip NaN values
>>> clean
[20.7, 19.2, 18.3, 14.4]
>>> sorted(clean)  # Sorting now works as expected
[14.4, 18.3, 19.2, 20.7]
>>> median(clean)       # This result is now well defined
18.75
Средние значения и меры центральной тенденции
Эти функции вычисляют среднее или типичное значение из генеральной совокупности или выборки.
Среднее арифметическое (“среднее”) данных. | |
Быстрое среднее значение с плавающей запятой, с опциональным весом. | |
Геометрическое среднее данных. | |
Гармоническое среднее данных. | |
Медиана (среднее значение) данных. | |
Нижняя медиана данных. | |
Верхняя медиана данных. | |
Медиана (50-й перцентиль) сгруппированных данных. | |
Единственная мода (наиболее часто встречающееся значение) дискретных или номинальных данных. | |
Список мод (наиболее часто встречающихся значений) дискретных или номинальных данных. | |
Разделение данных на интервалы с равной вероятностью. |
Меры разброса
Эти функции вычисляют меру того, насколько генеральная совокупность или выборка имеют тенденцию отклоняться от типичных или средних значений.
Стандартное отклонение генеральной совокупности данных. | |
Дисперсия генеральной совокупности данных. | |
Стандартное отклонение выборки данных. | |
Дисперсия выборки данных. |
Статистики для взаимосвязи двух входов
Эти функции вычисляют статистику, касающуюся взаимосвязей между двумя входами.
Выборочная ковариация для двух переменных. | |
Коэффициенты корреляции Пирсона и Спирмена. | |
Наклон и точка пересечения для линейной регрессии. |
Подробности функций
Примечание: Функции не требуют, чтобы данные, которые им предоставляются, были отсортированы. Однако для удобства чтения большинство примеров демонстрируют отсортированные последовательности.
-
statistics.mean(data) -
Возвращает выборочное среднее арифметическое данных, которые могут быть последовательностью или итерируемым объектом.
Арифметическое среднее — это сумма данных, деленная на количество точек данных. Оно обычно называется «средним значением», хотя это лишь одно из многих математических средних значений. Это мера центральной тенденции данных.
Если данные пустые, будет поднято исключение
StatisticsError.Некоторые примеры использования:
>>> mean([1, 2, 3, 4, 4])
2.8
>>> mean([-1.0, 2.5, 3.25, 5.75])
2.625

>>> from fractions import Fraction as F
>>> mean([F(3, 7), F(1, 21), F(5, 3), F(1, 3)])
Fraction(13, 21)

>>> from decimal import Decimal as D
>>> mean([D("0.5"), D("0.75"), D("0.625"), D("0.375")])
Decimal('0.5625')
Примечание
Среднее значение сильно зависит от выбросов и не обязательно является типичным примером точек данных. Для более устойчивой, хотя и менее эффективной, меры центральной тенденции см.
median().Выборочное среднее дает несмещенную оценку истинного среднего значения генеральной совокупности, так что при усреднении по всем возможным выборкам оно сходится к истинному среднему значению всей генеральной совокупности. Если данные представляют собой всю генеральную совокупность, а не выборку, то
mean(data)эквивалентно вычислению истинного среднего значения генеральной совокупности μ.
-
statistics.fmean(data, weights=None) -
Преобразует данные в числа с плавающей точкой и вычисляет арифметическое среднее.
Эта функция работает быстрее, чем функция
mean(), и всегда возвращает значение типаfloat. Данные могут быть последовательностью или итерируемым объектом. Если входной набор данных пустой, будет поднято исключениеStatisticsError.>>> fmean([3.5, 4.0, 5.25]) 4.25
Поддерживается необязательное взвешивание. Например, преподаватель определяет оценку за курс, присваивая весовые коэффициенты: 20% за викторины, 20% за домашние задания, 30% за контрольную работу и 30% за итоговый экзамен:
>>> grades = [85, 92, 83, 91]
>>> weights = [0.20, 0.20, 0.30, 0.30]
>>> fmean(grades, weights)
87.6
Если weights (веса) указан, он должен иметь такую же длину, как и data (данные), иначе будет поднято исключение
ValueError.Добавлен в версии 3.8.
Изменено в версии 3.11: Добавлена поддержка weights.
-
statistics.geometric_mean(data) -
Преобразует данные в числа с плавающей точкой и вычисляет геометрическое среднее.
Геометрическое среднее показывает центральную тенденцию или типичное значение данных, используя произведение значений (в отличие от арифметического среднего, которое использует их сумму).
Поднимает исключение
StatisticsError, если входной набор данных пустой, содержит ноль или отрицательное значение. Данные могут быть последовательностью или итерируемым объектом.Не предпринимаются специальные усилия для достижения точных результатов. (Однако это может измениться в будущем.)
>>> round(geometric_mean([54, 24, 36]), 1)
36.0
Добавлен в версии 3.8.
-
statistics.harmonic_mean(data, weights=None) -
Возвращает гармоническое среднее данных, последовательности или итерируемого объекта действительных чисел. Если weights (веса) опущено или
None, предполагается равное взвешивание.Гармоническое среднее — это обратная величина арифметического
mean()обратных величин данных. Например, гармоническое среднее трёх значений a, b и c эквивалентно3/(1/a + 1/b + 1/c). Если одно из значений равно нулю, результат будет нулём.Гармоническое среднее — это тип среднего значения, мера центральной тенденции данных. Оно часто подходит при усреднении отношений или скоростей, например, скоростей.
Предположим, что автомобиль проехал 10 км со скоростью 40 км/ч, а затем ещё 10 км со скоростью 60 км/ч. Какова средняя скорость?
>>> harmonic_mean([40, 60])
48.0
Предположим, что автомобиль ехал со скоростью 40 км/ч в течение 5 км, а когда движение прояснилось, ускорился до 60 км/ч на оставшихся 30 км пути. Какова средняя скорость?
>>> harmonic_mean([40, 60], weights=[5, 30])
56.0
Исключение
StatisticsErrorподнимается, если data пустая, любое значение меньше нуля или взвешенная сумма не положительна.Текущий алгоритм имеет выходной момент, когда он встречает ноль в вводе. Это означает, что последующие входные данные не проверяются на валидность. (Это поведение может измениться в будущем.)
Добавлен в версии 3.6.
Изменено в версии 3.10: Добавлена поддержка weights.
-
statistics.median(data) -
Возвращает медиану (значение посередине) числовых данных, используя общий метод «среднее двух средних». Если data пустая, поднимается исключение
StatisticsError. data может быть последовательностью или итерируемым объектом.Медиана является устойчивой мерой центральной тенденции и меньше зависит от наличия выбросов. Когда количество точек данных нечётное, возвращается средняя точка данных:
>>> median([1, 3, 5])
3
Когда количество точек данных чётное, медиана интерполируется путём усреднения двух средних значений:
>>> median([1, 3, 5, 7])
4.0
Это подходит для случаев, когда ваши данные дискретные, и вас не беспокоит, что медиана может не быть фактической точкой данных.
Если данные упорядочены (поддерживают операции сравнения), но не числовые (не поддерживают сложение), рассмотрите использование
median_low()илиmedian_high().
-
statistics.median_low(data) -
Возвращает нижнюю медиану числовых данных. Если data пустая, поднимается исключение
StatisticsError. data может быть последовательностью или итерируемым объектом.Нижняя медиана всегда является членом набора данных. Когда количество точек данных нечётное, возвращается среднее значение. Когда оно чётное, возвращается меньшее из двух средних значений.
>>> median_low([1, 3, 5])
3
>>> median_low([1, 3, 5, 7])
3
Используйте нижнюю медиану, когда ваши данные дискретные и вы предпочитаете, чтобы медиана была фактической точкой данных, а не интерполированной.
-
statistics.median_high(data) -
Возвращает верхнюю медиану данных. Если data пустая, поднимается исключение
StatisticsError. data может быть последовательностью или итерируемым объектом.Верхняя медиана всегда является членом набора данных. Когда количество точек данных нечётное, возвращается среднее значение. Когда оно чётное, возвращается большее из двух средних значений.
>>> median_high([1, 3, 5])
3
>>> median_high([1, 3, 5, 7])
5
Используйте верхнюю медиану, когда ваши данные дискретные и вы предпочитаете, чтобы медиана была фактической точкой данных, а не интерполированной.
-
statistics.median_grouped(data, interval=1.0) -
Оценивает медиану для числовых данных, которые были сгруппированы или разбиты на интервалы вокруг середин последовательных интервалов с фиксированной шириной.
Данные могут быть любым итерируемым объектом числовых данных, где каждое значение является точно серединой интервала. Должно быть присутствовать по крайней мере одно значение.
interval (интервал) — это ширина каждого интервала.
Например, демографическая информация может быть сведена в последовательные десятилетние возрастные группы, каждая из которых представлена серединами интервалов 5 лет:
>>> from collections import Counter
>>> demographics = Counter({
...    25: 172,   # 20 to 30 years old
...    35: 484,   # 30 to 40 years old
...    45: 387,   # 40 to 50 years old
...    55:  22,   # 50 to 60 years old
...    65:   6,   # 60 to 70 years old
... })
...
50-й процентиль (медиана) — это 536-й человек из когорты из 1071 члена. Этот человек входит в группу от 30 до 40 лет.
Обычная функция
median()предполагала бы, что все люди в тридцатилетнем возрасте были ровно 35 лет. Более правдоподобное предположение состоит в том, что 484 члена этой возрастной группы равномерно распределены между 30 и 40 годами. Для этого мы используемmedian_grouped():>>> data = list(demographics.elements()) >>> median(data) 35 >>> round(median_grouped(data, interval=10), 1) 37.5
Ответственный за обеспечение того, чтобы точки данных были разделены точными кратными interval. Это важно для получения правильного результата. Функция не проверяет это предварительное условие.
Входные данные могут быть любого числового типа, который может быть преобразован в число с плавающей точкой во время шага интерполяции.
-
statistics.mode(data) -
Возвращает единственное наиболее часто встречающееся значение в дискретных или номинальных данных. Мода (если она существует) — это наиболее типичное значение и служит мерой центральной тенденции.
Если существует несколько мод с одинаковой частотой, возвращается первая из встретившихся в данных. Если требуется наименьшее или наибольшее из них, используйте
min(multimode(data))илиmax(multimode(data)). Если входные данные пусты, генерируется исключениеStatisticsError.modeпредполагает дискретные данные и возвращает одно значение. Это стандартная интерпретация моды, как обычно преподают в школах:>>> mode([1, 1, 2, 3, 3, 3, 3, 4]) 3
Мода уникальна тем, что она единственная статистика в этом пакете, которая также применима к номинальным (нечисловым) данным:
>>> mode(["red", "blue", "blue", "red", "green", "red", "red"])
'red'
Поддерживаются только хэшируемые входные данные. Для обработки типа
setрассмотрите возможность преобразования вfrozenset. Для обработки типаlistрассмотрите возможность преобразования вtuple. Для смешанных или вложенных входных данных рассмотрите использование этого медленного квадратичного алгоритма, который зависит только от тестов равенства:max(data, key=data.count).Изменено в версии 3.8: Теперь обрабатывает многомодальные наборы данных, возвращая первую встреченную моду. Раньше при обнаружении более одной моды генерировалось исключение
StatisticsError.
-
statistics.multimode(data) -
Возвращает список наиболее часто встречающихся значений в порядке их первого появления в данных. Будет возвращать более одного результата, если существуют несколько мод, или пустой список, если данные пусты:
>>> multimode('aabbbbccddddeeffffgg')
['b', 'd', 'f']
>>> multimode('')
[]
Добавлена в версии 3.8.
-
statistics.pstdev(data, mu=None) -
Возвращает среднее квадратическое отклонение генеральной совокупности (корень из дисперсии генеральной совокупности). См.
pvariance()для аргументов и других подробностей.>>> pstdev([1.5, 2.5, 2.5, 2.75, 3.25, 4.75]) 0.986893273527251
-
statistics.pvariance(data, mu=None) -
Возвращает дисперсию генеральной совокупности data, непустой последовательности или итерируемого объекта вещественных чисел. Дисперсия, или второй центральный момент, является мерой изменчивости (разброса или рассеяния) данных. Большая дисперсия указывает на то, что данные разбросаны; малая дисперсия указывает на то, что они сгруппированы близко вокруг среднего значения.
Если задан необязательный второй аргумент mu, он должен быть средним значением генеральной совокупности data. Его также можно использовать для вычисления второго момента относительно точки, которая не является средним значением. Если он отсутствует или
None(по умолчанию), среднее арифметическое вычисляется автоматически.Используйте эту функцию для вычисления дисперсии по всей генеральной совокупности. Для оценки дисперсии по выборке обычно лучше использовать функцию
variance().Возникает исключение
StatisticsError, если data пуста.Примеры:
>>> data = [0.0, 0.25, 0.25, 1.25, 1.5, 1.75, 2.75, 3.25]
>>> pvariance(data)
1.25
Если вы уже вычислили среднее значение своих данных, вы можете передать его как необязательный второй аргумент mu, чтобы избежать повторного вычисления:
>>> mu = mean(data)
>>> pvariance(data, mu)
1.25
Десятичные и дробные числа поддерживаются:
>>> from decimal import Decimal as D
>>> pvariance([D("27.5"), D("30.25"), D("30.25"), D("34.5"), D("41.75")])
Decimal('24.815')

>>> from fractions import Fraction as F
>>> pvariance([F(1, 4), F(5, 4), F(1, 2)])
Fraction(13, 72)
Примечание
При вызове со всей генеральной совокупностью это дает дисперсию генеральной совокупности σ². При вызове по выборке это является смещенной дисперсией выборки s², также известной как дисперсия с N степенями свободы.
Если вы каким-то образом знаете истинное среднее значение генеральной совокупности μ, вы можете использовать эту функцию для вычисления дисперсии выборки, передав известное среднее значение генеральной совокупности в качестве второго аргумента. При условии, что данные представляют собой случайную выборку из генеральной совокупности, результат будет смещенной оценкой дисперсии генеральной совокупности.
-
statistics.stdev(data, xbar=None) -
Возвращает среднее квадратическое отклонение выборки (корень из дисперсии выборки). См.
variance()для аргументов и других подробностей.>>> stdev([1.5, 2.5, 2.5, 2.75, 3.25, 4.75]) 1.0810874155219827
-
statistics.variance(data, xbar=None) -
Возвращает дисперсию выборки data, итерируемого объекта по меньшей мере из двух вещественных чисел. Дисперсия, или второй центральный момент, является мерой изменчивости (разброса или рассеяния) данных. Большая дисперсия указывает на то, что данные разбросаны; малая дисперсия указывает на то, что они сгруппированы близко вокруг среднего значения.
Если задан необязательный второй аргумент xbar, он должен быть средним значением выборки data. Если он отсутствует или
None(по умолчанию), среднее значение вычисляется автоматически.Используйте эту функцию, когда ваши данные являются выборкой из генеральной совокупности. Для вычисления дисперсии по всей генеральной совокупности см.
pvariance().Возникает исключение
StatisticsError, если data содержит менее двух значений.Примеры:
>>> data = [2.75, 1.75, 1.25, 0.25, 0.5, 1.25, 3.5]
>>> variance(data)
1.3720238095238095
Если вы уже вычислили среднее значение выборки, вы можете передать его как необязательный второй аргумент xbar, чтобы избежать повторного вычисления:
>>> m = mean(data)
>>> variance(data, m)
1.3720238095238095
Функция не проверяет, что вы передали фактическое среднее значение как xbar. Использование произвольных значений для xbar может привести к недопустимым или невозможным результатам.
Десятичные и дробные значения поддерживаются:
>>> from decimal import Decimal as D
>>> variance([D("27.5"), D("30.25"), D("30.25"), D("34.5"), D("41.75")])
Decimal('31.01875')

>>> from fractions import Fraction as F
>>> variance([F(1, 6), F(1, 2), F(5, 3)])
Fraction(67, 108)
Примечание
Это дисперсия выборки s² с поправкой Бесселя, также известная как дисперсия с N-1 степенями свободы. При условии, что данные являются репрезентативными (например, независимыми и одинаково распределёнными), результат должен быть несмещенной оценкой истинной дисперсии генеральной совокупности.
Если вы каким-то образом знаете фактическое среднее значение генеральной совокупности μ, вы должны передать его функции
pvariance()в качестве параметра mu, чтобы получить дисперсию выборки.
-
statistics.quantiles(data, *, n=4, method='exclusive') -
Разбивает data на n непрерывных интервалов с равной вероятностью. Возвращает список точек
n - 1разбиения, разделяющих интервалы.Установите n равным 4 для квартилей (по умолчанию). Установите n равным 10 для децилей. Установите n равным 100 для перцентилей, что даёт 99 точек разбиения, которые разделяют data на 100 равных групп. Возникает исключение
StatisticsError, если n не меньше 1.Data может быть любым итерируемым объектом, содержащим данные выборки. Для осмысленных результатов число точек данных в data должно быть больше, чем n. Возникает исключение
StatisticsError, если точек данных не менее двух.Точки разбиения линейно интерполируются из двух ближайших точек данных. Например, если точка разбиения падает на одну треть расстояния между двумя значениями выборки,
100и112, точка разбиения будет равна104.Метод вычисления квантилей может варьироваться в зависимости от того, содержит ли data наименьшие и наибольшие возможные значения из генеральной совокупности или нет.
По умолчанию method равен “исключительному” и используется для данных, взятых из генеральной совокупности, которая может иметь более экстремальные значения, чем обнаруженные в выборках. Доля генеральной совокупности, попадающая ниже i-й из m отсортированных точек данных, вычисляется как
i / (m + 1). Для девяти значений выборки метод сортирует их и присваивает следующие перцентили: 10%, 20%, 30%, 40%, 50%, 60%, 70%, 80%, 90%.Установка method на “включительно” используется для описания данных генеральной совокупности или для выборок, которые, как известно, включают самые экстремальные значения из генеральной совокупности. Минимальное значение в data обрабатывается как 0-й перцентиль, а максимальное значение — как 100-й перцентиль. Доля генеральной совокупности, попадающая ниже i-й из m отсортированных точек данных, вычисляется как
(i - 1) / (m - 1). Для 11 значений выборки метод сортирует их и присваивает следующие перцентили: 0%, 10%, 20%, 30%, 40%, 50%, 60%, 70%, 80%, 90%, 100%.# Decile cut points for empirically sampled data >>> data = [105, 129, 87, 86, 111, 111, 89, 81, 108, 92, 110, ... 100, 75, 105, 103, 109, 76, 119, 99, 91, 103, 129, ... 106, 101, 84, 111, 74, 87, 86, 103, 103, 106, 86, ... 111, 75, 87, 102, 121, 111, 88, 89, 101, 106, 95, ... 103, 107, 101, 81, 109, 104] >>> [round(q, 1) for q in quantiles(data, n=10)] [81.0, 86.2, 89.0, 99.4, 102.5, 103.6, 106.0, 109.8, 111.0]
Добавлена в версии 3.8.
-
statistics.covariance(x, y, /) -
Возвращает выборочную ковариацию двух входных данных x и y. Ковариация является мерой совместной изменчивости двух входных данных.
Оба входных данных должны иметь одинаковую длину (не менее двух), в противном случае генерируется исключение
StatisticsError.Примеры:
>>> x = [1, 2, 3, 4, 5, 6, 7, 8, 9]
>>> y = [1, 2, 3, 1, 2, 3, 1, 2, 3]
>>> covariance(x, y)
0.75
>>> z = [9, 8, 7, 6, 5, 4, 3, 2, 1]
>>> covariance(x, z)
-7.5
>>> covariance(z, x)
-7.5
Добавлена в версии 3.10.
-
statistics.correlation(x, y, /, *, method='linear') -
Возвращает коэффициент корреляции Пирсона для двух входных данных. Коэффициент корреляции Пирсона r принимает значения от -1 до +1. Он измеряет силу и направление линейной зависимости.
Если method равно “ranked”, вычисляет коэффициент ранговой корреляции Спирмена для двух входных данных. Данные заменяются рангами. Связи усредняются, так что равные значения получают один и тот же ранг. Полученный коэффициент измеряет силу монотонной зависимости.
Коэффициент корреляции Спирмена подходит для порядковых данных или для непрерывных данных, которые не удовлетворяют требованию линейного пропорционального соотношения для коэффициента корреляции Пирсона.
Оба входных данных должны иметь одинаковую длину (не менее двух) и не обязательно быть постоянными, иначе возбуждается исключение
StatisticsError.Пример с законами Кеплера о движении планет:
>>> # Mercury, Venus, Earth, Mars, Jupiter, Saturn, Uranus, and  Neptune
>>> orbital_period = [88, 225, 365, 687, 4331, 10_756, 30_687, 60_190]    # days
>>> dist_from_sun = [58, 108, 150, 228, 778, 1_400, 2_900, 4_500] # million km

>>> # Show that a perfect monotonic relationship exists
>>> correlation(orbital_period, dist_from_sun, method='ranked')
1.0

>>> # Observe that a linear relationship is imperfect
>>> round(correlation(orbital_period, dist_from_sun), 4)
0.9882

>>> # Demonstrate Kepler's third law: There is a linear correlation
>>> # between the square of the orbital period and the cube of the
>>> # distance from the sun.
>>> period_squared = [p * p for p in orbital_period]
>>> dist_cubed = [d * d * d for d in dist_from_sun]
>>> round(correlation(period_squared, dist_cubed), 4)
1.0
Добавлен в версии 3.10.
Изменён в версии 3.12: Добавлена поддержка коэффициента ранговой корреляции Спирмена.
-
statistics.linear_regression(x, y, /, *, proportional=False) -
Возвращает наклон и отрезок прямой простой линейной регрессии, параметры которой оценены с использованием обычного метода наименьших квадратов. Простая линейная регрессия описывает зависимость между независимой переменной x и зависимой переменной y с помощью этого линейного уравнения:
y = наклон * x + отрезок + шум
где
slopeиintercept— параметры регрессии, которые оцениваются, аnoiseпредставляет собой изменчивость данных, которая не была объяснена линейной регрессией (она равна разнице между предсказанными и фактическими значениями зависимой переменной).Оба входных данных должны иметь одинаковую длину (не менее двух), а независимая переменная x не может быть постоянной; в противном случае возбуждается исключение
StatisticsError.Например, мы можем использовать даты выхода фильмов Монти Пайтона, чтобы предсказать общее количество фильмов Монти Пайтона, которые были бы произведены к 2019 году, предполагая, что они сохранили темп.
>>> year = [1971, 1975, 1979, 1982, 1983]
>>> films_total = [1, 2, 3, 4, 5]
>>> slope, intercept = linear_regression(year, films_total)
>>> round(slope * 2019 + intercept)
16
Если proportional равно true, независимая переменная x и зависимая переменная y предполагаются прямо пропорциональными. Данные подгоняются к прямой, проходящей через начало координат. Поскольку отрезок всегда будет равен 0.0, базовое линейное уравнение упрощается до:
y = наклон * x + шум
Продолжая пример из
correlation(), мы смотрим, насколько хорошо модель, основанная на основных планетах, может предсказать орбитальные расстояния для карликовых планет:>>> model = linear_regression(period_squared, dist_cubed, proportional=True) >>> slope = model.slope >>> # Dwarf planets: Pluto, Eris, Makemake, Haumea, Ceres >>> orbital_periods = [90_560, 204_199, 111_845, 103_410, 1_680] # days >>> predicted_dist = [math.cbrt(slope * (p * p)) for p in orbital_periods] >>> list(map(round, predicted_dist)) [5912, 10166, 6806, 6459, 414] >>> [5_906, 10_152, 6_796, 6_450, 414] # actual distance in million km [5906, 10152, 6796, 6450, 414]
Добавлен в версии 3.10.
Изменён в версии 3.11: Добавлена поддержка proportional.
Исключения
Определено одно исключение:
-
exception statistics.StatisticsError -
Подкласс
ValueErrorдля исключений, связанных со статистикой.
Объекты NormalDist
NormalDist — инструмент для создания и обработки нормальных распределений случайной переменной. Это класс, который рассматривает среднее значение и стандартное отклонение измерений данных как единое целое.
Нормальные распределения возникают из Центральной предельной теоремы и имеют широкое применение в статистике.
-
class statistics.NormalDist(mu=0.0, sigma=1.0) -
Возвращает новый объект NormalDist, где mu представляет собой среднее арифметическое, а sigma — стандартное отклонение.
Если sigma отрицательно, возбуждается исключение
StatisticsError.-
mean -
Только для чтения свойство для среднего арифметического нормального распределения.
-
median -
Только для чтения свойство для медианы нормального распределения.
-
mode -
Только для чтения свойство для моды нормального распределения.
-
stdev -
Только для чтения свойство для стандартного отклонения нормального распределения.
-
variance -
Только для чтения свойство для дисперсии нормального распределения. Равно квадрату стандартного отклонения.
-
classmethod from_samples(data) -
Создаёт экземпляр нормального распределения с параметрами mu и sigma, оценёнными из data с помощью
fmean()иstdev().data может быть любым итерируемым объектом и должно состоять из значений, которые могут быть преобразованы к типу
float. Если data не содержит по крайней мере двух элементов, возбуждается исключениеStatisticsError, так как для оценки центральной величины требуется не менее одной точки, а для оценки дисперсии — не менее двух.
-
samples(n, *, seed=None) -
Генерирует n случайных выборок для заданного среднего значения и стандартного отклонения. Возвращает
listзначений типаfloat.Если задан seed, создаётся новый экземпляр генератора псевдослучайных чисел. Это полезно для создания воспроизводимых результатов, даже в контексте многопоточности.
-
pdf(x) -
Используя функцию плотности вероятности (pdf), вычисляет относительную вероятность того, что случайная величина X будет близка к заданному значению x. Математически это предел отношения
P(x <=
X < x+dx) / dx
при стремлении dx к нулю.Относительная вероятность вычисляется как вероятность появления выборки в узком интервале, делённая на ширину интервала (отсюда и слово «плотность»). Поскольку вероятность относительна к другим точкам, её значение может быть больше, чем
1.0.
-
cdf(x) -
Используя функцию распределения (cdf), вычисляет вероятность того, что случайная величина X будет меньше или равна x. Математически это записывается как
P(X <= x).
-
inv_cdf(p) -
Вычисляет обратную функцию распределения, также известную как функция квантиля или функция процентиля. Математически это записывается как
x : P(X <= x) = p.Находит значение x случайной величины X такое, что вероятность того, что величина будет меньше или равна этому значению, равна заданной вероятности p.
-
overlap(other) -
Измеряет степень согласованности между двумя нормальными распределениями вероятностей. Возвращает значение от 0,0 до 1,0, представляющее собой перекрывающуюся площадь для двух функций плотности вероятностей.
-
quantiles(n=4) -
Делит нормальное распределение на n непрерывных интервалов с равной вероятностью. Возвращает список (n - 1) точек раздела, разделяющих интервалы.
Установите n в 4 для квартилей (по умолчанию). Установите n в 10 для децилей. Установите n в 100 для перцентилей, которые дают 99 точек раздела, разделяющих нормальное распределение на 100 равных групп.
-
zscore(x) -
Вычисляет стандартное отклонение, описывающее x в терминах числа стандартных отклонений выше или ниже среднего значения нормального распределения:
(x - mean) / stdev.Добавлен в версии 3.9.
Экземпляры
NormalDistподдерживают сложение, вычитание, умножение и деление на константу. Эти операции используются для сдвига и масштабирования. Например:>>> temperature_february = NormalDist(5, 2.5) # Celsius >>> temperature_february * (9/5) + 32 # Fahrenheit NormalDist(mu=41.0, sigma=4.5)
Деление константы на экземпляр
NormalDistне поддерживается, так как результат не будет нормально распределённым.Поскольку нормальные распределения возникают из аддитивных эффектов независимых переменных, можно сложить и вычесть две независимые нормально распределённые случайные величины, представленные как экземпляры
NormalDist. Например:>>> birth_weights = NormalDist.from_samples([2.5, 3.1, 2.1, 2.4, 2.7, 3.5]) >>> drug_effects = NormalDist(0.4, 0.15) >>> combined = birth_weights + drug_effects >>> round(combined.mean, 1) 3.1 >>> round(combined.stdev, 1) 0.5
Добавлен в версии 3.8.
-
Примеры и рецепты
Классические задачи теории вероятностей
NormalDist легко решает классические задачи теории вероятностей.
Например, зная исторические данные по экзаменам SAT, показывающие, что баллы распределены нормально со средним значением 1060 и стандартным отклонением 195, определите процент студентов с результатами тестов между 1100 и 1200, округлив до ближайшего целого числа:
>>> sat = NormalDist(1060, 195)
>>> fraction = sat.cdf(1200 + 0.5) - sat.cdf(1100 - 0.5)
>>> round(fraction * 100.0, 1)
18.4
Найдите квартили и децили для баллов SAT:
>>> list(map(round, sat.quantiles()))
[928, 1060, 1192]
>>> list(map(round, sat.quantiles(n=10)))
[810, 896, 958, 1011, 1060, 1109, 1162, 1224, 1310]
Входные данные Монте-Карло для симуляций
Для оценки распределения для модели, которую нелегко решить аналитически, NormalDist может генерировать входные выборки для симуляции Монте-Карло:
>>> def model(x, y, z):
...     return (3*x + 7*x*y - 5*y) / (11 * z)
...
>>> n = 100_000
>>> X = NormalDist(10, 2.5).samples(n, seed=3652260728)
>>> Y = NormalDist(15, 1.75).samples(n, seed=4582495471)
>>> Z = NormalDist(50, 1.25).samples(n, seed=6582483453)
>>> quantiles(map(model, X, Y, Z))
[1.4591308524824727, 1.8035946855390597, 2.175091447274739]
Приближение биномиальных распределений
Нормальные распределения могут использоваться для приближения биномиальных распределений, когда размер выборки велик, а вероятность успешного испытания близка к 50%.
Например, на конференции с открытым исходным кодом 750 участников и двумя залами вместимостью 500 человек. Есть доклад о Python и другой о Ruby. На предыдущих конференциях 65% участников предпочитали слушать доклады о Python. При предположении, что предпочтения населения не изменились, какова вероятность того, что зал для докладов о Python останется в пределах своих лимитов вместимости?
>>> n = 750             # Sample size
>>> p = 0.65            # Preference for Python
>>> q = 1.0 - p         # Preference for Ruby
>>> k = 500             # Room capacity

>>> # Approximation using the cumulative normal distribution
>>> from math import sqrt
>>> round(NormalDist(mu=n*p, sigma=sqrt(n*p*q)).cdf(k + 0.5), 4)
0.8402

>>> # Exact solution using the cumulative binomial distribution
>>> from math import comb, fsum
>>> round(fsum(comb(n, r) * p**r * q**(n-r) for r in range(k+1)), 4)
0.8402

>>> # Approximation using a simulation
>>> from random import seed, binomialvariate
>>> seed(8675309)
>>> mean(binomialvariate(n, p) <= k for i in range(10_000))
0.8406
Наивный байесовский классификатор
Нормальные распределения часто встречаются в задачах машинного обучения.
В Википедии есть хороший пример наивного байесовского классификатора. Задача состоит в том, чтобы предсказать пол человека по измерениям нормально распределенных признаков, включая рост, вес и размер ноги.
Нам дан обучающий набор данных с измерениями для восьми человек. Измерения предполагаются нормально распределенными, поэтому мы обобщаем данные с помощью NormalDist:
>>> height_male = NormalDist.from_samples([6, 5.92, 5.58, 5.92])
>>> height_female = NormalDist.from_samples([5, 5.5, 5.42, 5.75])
>>> weight_male = NormalDist.from_samples([180, 190, 170, 165])
>>> weight_female = NormalDist.from_samples([100, 150, 130, 150])
>>> foot_size_male = NormalDist.from_samples([12, 11, 12, 10])
>>> foot_size_female = NormalDist.from_samples([6, 8, 7, 9])
Затем мы сталкиваемся с новым человеком, чьи измерения признаков известны, но пол неизвестен:
>>> ht = 6.0        # height
>>> wt = 130        # weight
>>> fs = 8          # foot size
Начиная с 50%-ной априорной вероятности быть мужчиной или женщиной, мы вычисляем апостериорную вероятность как априорную вероятность, умноженную на произведение вероятностей для измерений признаков, учитывая пол:
>>> prior_male = 0.5
>>> prior_female = 0.5
>>> posterior_male = (prior_male * height_male.pdf(ht) *
...                   weight_male.pdf(wt) * foot_size_male.pdf(fs))

>>> posterior_female = (prior_female * height_female.pdf(ht) *
...                     weight_female.pdf(wt) * foot_size_female.pdf(fs))
Окончательное предсказание переходит к наибольшей апостериорной вероятности. Это известно как максимальное апостериорное или MAP:
>>> 'male' if posterior_male > posterior_female else 'female'
'female'
Оценивание плотности ядра
Возможно оценить непрерывное распределение вероятностей по фиксированному числу дискретных выборок.
Основная идея заключается в сглаживании данных с помощью функции ядра, такой как нормальное распределение, треугольное распределение или равномерное распределение. Степень сглаживания контролируется параметром масштабирования, h, который называется шириной полосы.
from random import choice, random

def kde_normal(data, h):
    "Create a continuous probability distribution from discrete samples."

    # Smooth the data with a normal distribution kernel scaled by h.
    K_h = NormalDist(0.0, h)

    def pdf(x):
        'Probability density function.  P(x <= X < x+dx) / dx'
        return sum(K_h.pdf(x - x_i) for x_i in data) / len(data)

    def cdf(x):
        'Cumulative distribution function.  P(X <= x)'
        return sum(K_h.cdf(x - x_i) for x_i in data) / len(data)

    def rand():
        'Random selection from the probability distribution.'
        return choice(data) + K_h.inv_cdf(random())

    return pdf, cdf, rand
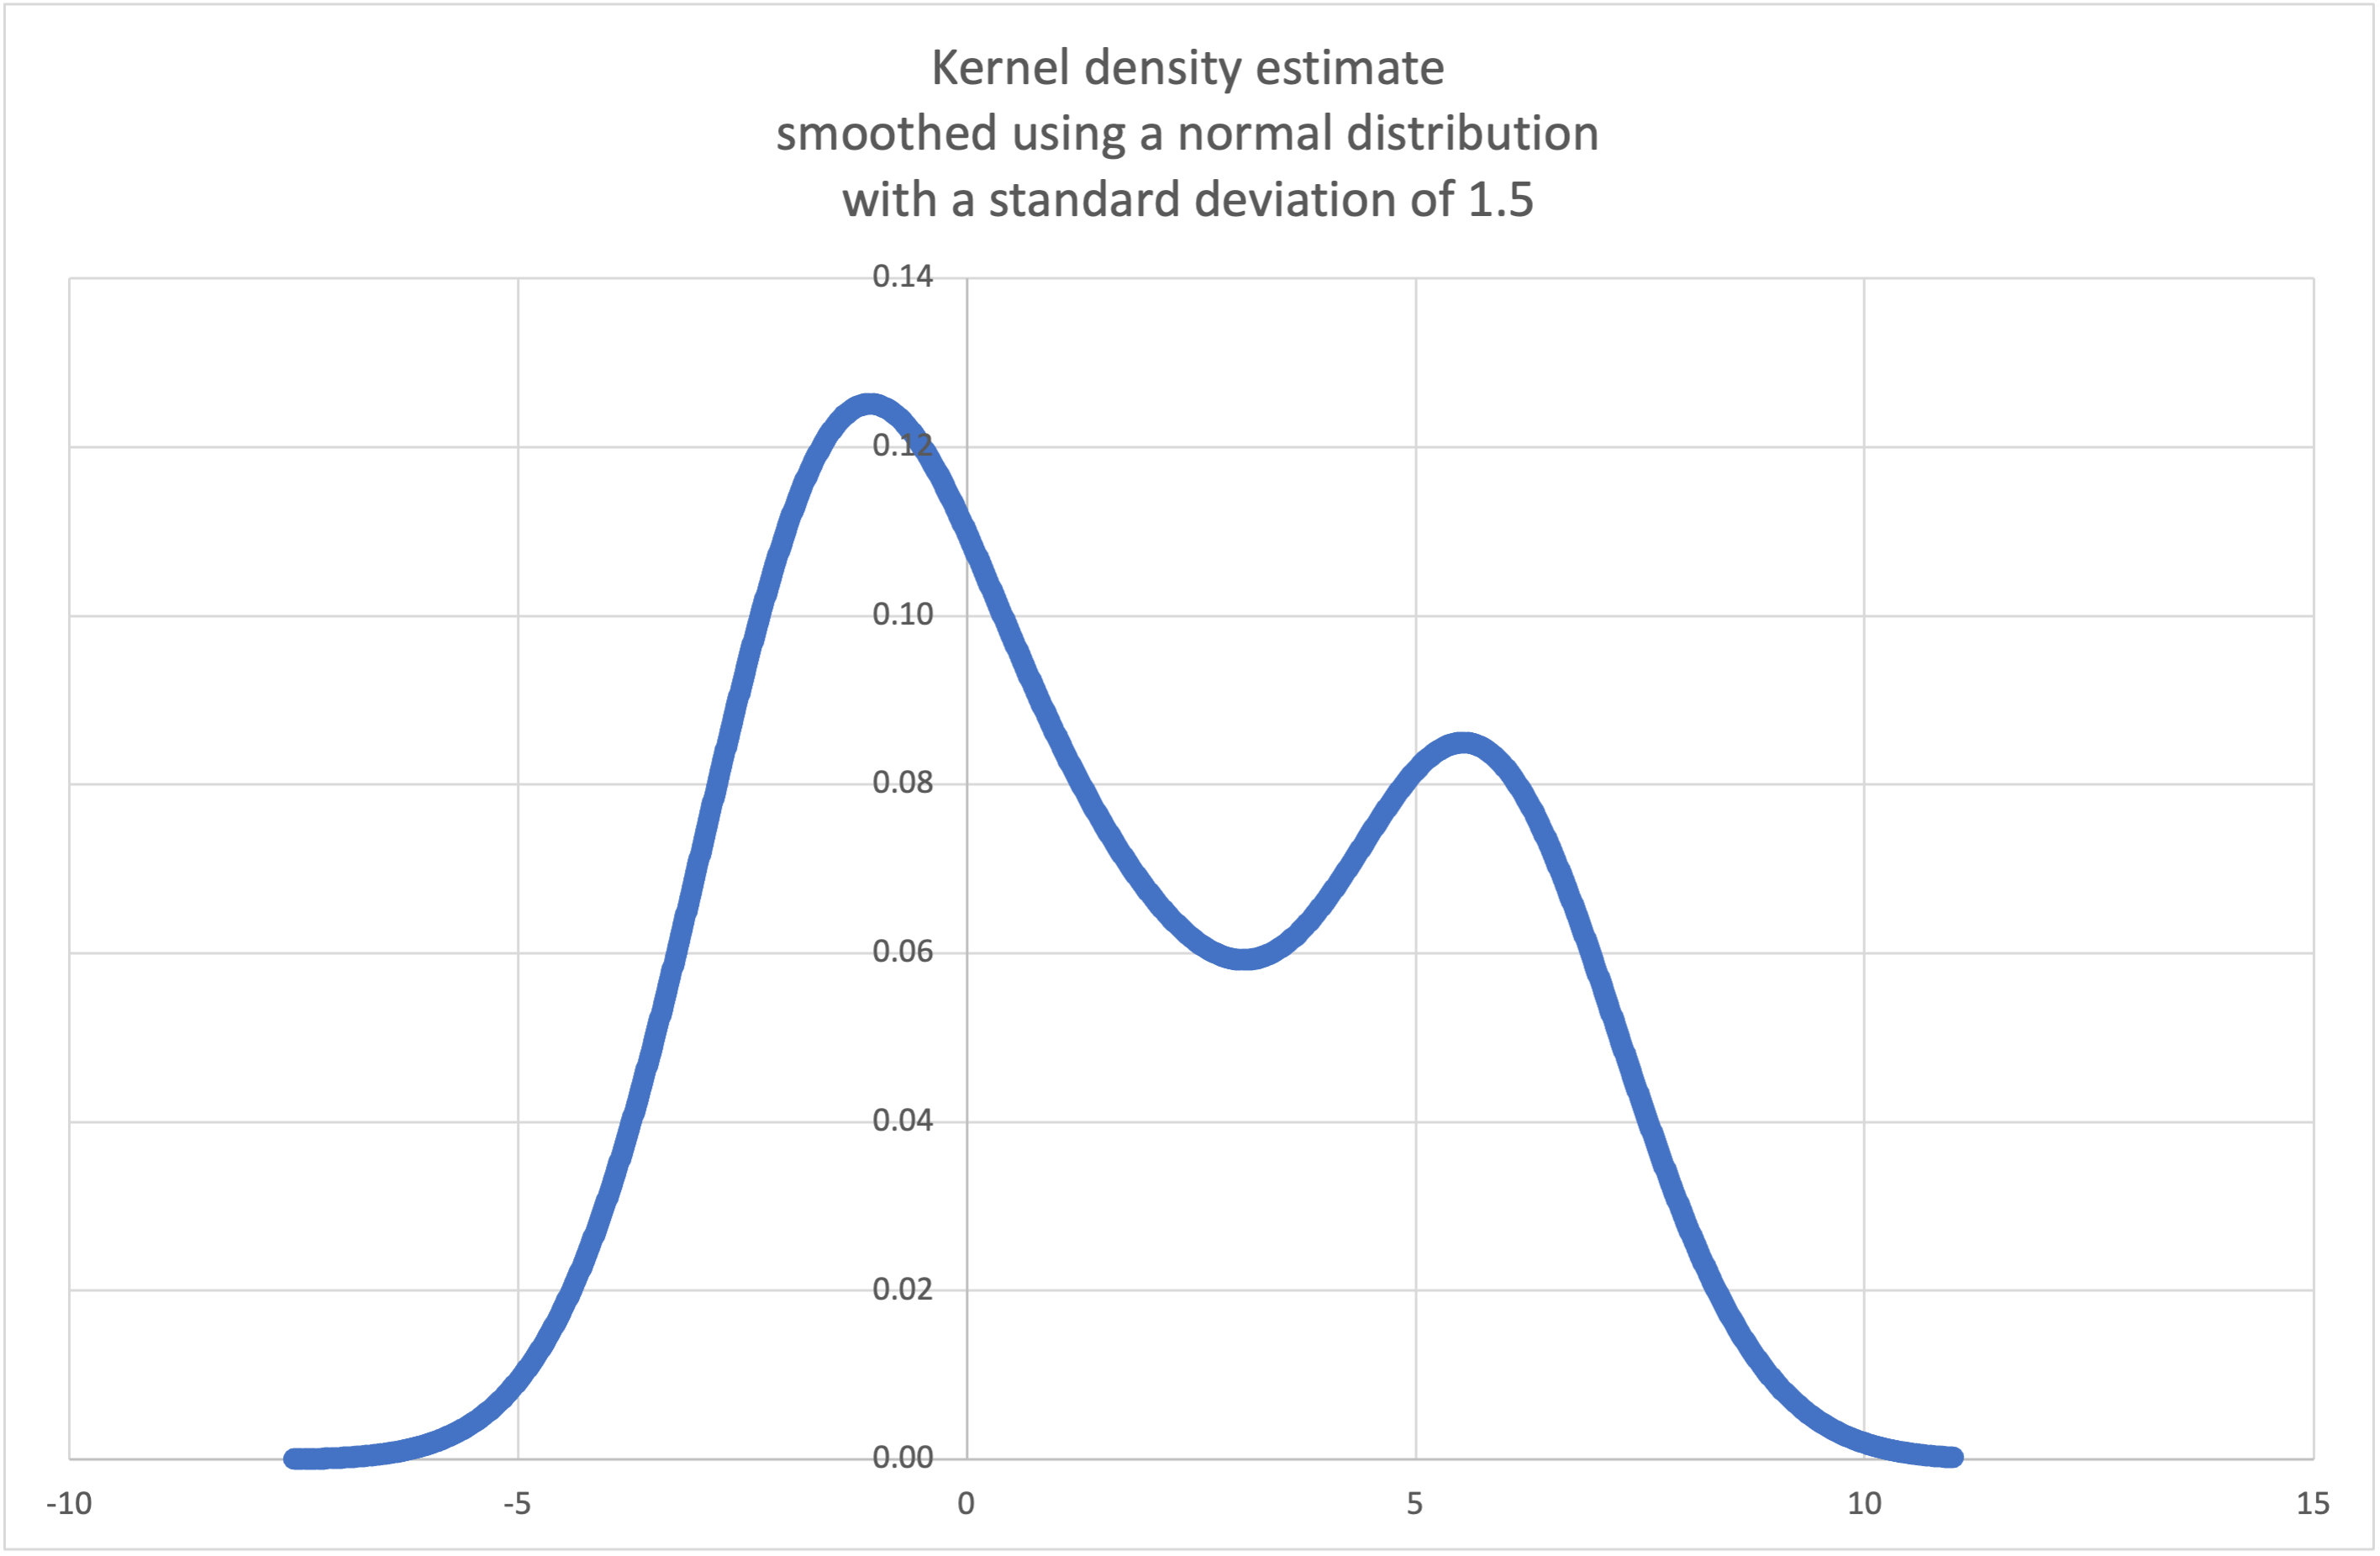
В Википедии есть пример, где мы можем использовать рецепт kde_normal() для генерации и построения функции плотности вероятности, оцененной по небольшой выборке:
>>> sample = [-2.1, -1.3, -0.4, 1.9, 5.1, 6.2]
>>> pdf, cdf, rand = kde_normal(sample, h=1.5)
>>> xarr = [i/100 for i in range(-750, 1100)]
>>> yarr = [pdf(x) for x in xarr]
Точки в xarr и yarr могут быть использованы для создания графика функции плотности вероятности:
Перевыборка данных для получения 100 новых выборок:
>>> new_selections = [rand() for i in range(100)]
Определите вероятность того, что новая выборка будет ниже 2.0:
>>> round(cdf(2.0), 4)
0.5794
Добавьте новую точку данных выборки и найдите новую функцию распределения по 2.0:
>>> sample.append(4.9)
>>> round(cdf(2.0), 4)
0.5005
© 2001–2024 Python Software Foundation
Licensed under the PSF License.
https://docs.python.org/3.12/library/statistics.html


