statistics — Функции математической статистики
Добавлено в версии 3.4.
Исходный код: Lib/statistics.py
Этот модуль предоставляет функции для вычисления математических статистик числовых данных (со значениями Real).
Модуль не предназначен для конкуренции со сторонними библиотеками, такими как NumPy, SciPy, или проприетарными полнофункциональными статистическими пакетами, предназначенными для профессиональных статистиков, такими как Minitab, SAS и Matlab. Он рассчитан на уровень графических и научных калькуляторов.
Если не указано иное, эти функции поддерживают int, float, Decimal и Fraction. Поведение с другими типами (как входящими, так и не входящими в числовую башню) в настоящее время не поддерживается. Поведение для коллекций со смешанными типами также не определено и зависит от реализации. Если входные данные состоят из значений разных типов, для получения согласованного результата можно использовать map(), например: map(float, input_data).
В некоторых наборах данных значения NaN (не число) используются для обозначения отсутствующих данных. Поскольку сравнение NaN имеет необычную семантику, они приводят к неожиданному или неопределённому поведению статистических функций, которые сортируют данные или подсчитывают количество вхождений. К таким функциям относятся median(), median_low(), median_high(), median_grouped(), mode(), multimode() и quantiles(). Перед вызовом этих функций значения NaN следует удалить:
>>> from statistics import median
>>> from math import isnan
>>> from itertools import filterfalse

>>> data = [20.7, float('NaN'),19.2, 18.3, float('NaN'), 14.4]
>>> sorted(data)  # This has surprising behavior
[20.7, nan, 14.4, 18.3, 19.2, nan]
>>> median(data)  # This result is unexpected
16.35

>>> sum(map(isnan, data))    # Number of missing values
2
>>> clean = list(filterfalse(isnan, data))  # Strip NaN values
>>> clean
[20.7, 19.2, 18.3, 14.4]
>>> sorted(clean)  # Sorting now works as expected
[14.4, 18.3, 19.2, 20.7]
>>> median(clean)       # This result is now well defined
18.75
Средние значения и меры центральной тенденции
Эти функции вычисляют среднее или типичное значение для генеральной совокупности или выборки.
Среднее арифметическое данных. | |
Быстрое среднее арифметическое с плавающей точкой и необязательным взвешиванием. | |
Среднее геометрическое данных. | |
Среднее гармоническое данных. | |
Оценка распределения плотности вероятности данных. | |
Случайная выборка из функции плотности вероятности, созданной с помощью kde(). | |
Медиана (среднее значение) данных. | |
Нижняя медиана данных. | |
Верхняя медиана данных. | |
Медиана (50-й процентиль) сгруппированных данных. | |
Единственная мода (наиболее часто встречающееся значение) дискретных или номинальных данных. | |
Список мод (наиболее часто встречающихся значений) дискретных или номинальных данных. | |
Разбиение данных на интервалы с равной вероятностью. |
Меры разброса
Эти функции вычисляют меру того, насколько генеральная совокупность или выборка отклоняется от типичных или средних значений.
Стандартное отклонение генеральной совокупности. | |
Дисперсия генеральной совокупности. | |
Стандартное отклонение выборки. | |
Дисперсия выборки. |
Статистики для взаимосвязей между двумя входными данными
Эти функции вычисляют статистики, характеризующие взаимосвязи между двумя входными данными.
Ковариация выборки для двух переменных. | |
Коэффициенты корреляции Пирсона и Спирмена. | |
Наклон и точка пересечения для простой линейной регрессии. |
Описание функций
Примечание: функции не требуют, чтобы переданные им данные были отсортированы. Однако для удобства чтения в большинстве примеров показаны отсортированные последовательности.
-
statistics.mean(data) -
Возвращает среднее арифметическое выборки data, которая может быть последовательностью или итерируемым объектом.
Среднее арифметическое — это сумма данных, разделённая на количество точек данных. Его обычно называют «средним», хотя это лишь один из множества различных математических видов среднего. Оно является мерой центрального положения данных.
Если data пуст, будет вызвано исключение
StatisticsError.Примеры использования:
>>> mean([1, 2, 3, 4, 4])
2.8
>>> mean([-1.0, 2.5, 3.25, 5.75])
2.625

>>> from fractions import Fraction as F
>>> mean([F(3, 7), F(1, 21), F(5, 3), F(1, 3)])
Fraction(13, 21)

>>> from decimal import Decimal as D
>>> mean([D("0.5"), D("0.75"), D("0.625"), D("0.375")])
Decimal('0.5625')
Примечание
На среднее сильно влияют выбросы, поэтому оно не обязательно является типичным примером точек данных. Более устойчивую, хотя и менее эффективную меру центральной тенденции см. в описании функции
median().Среднее выборки даёт несмещённую оценку истинного среднего генеральной совокупности, поэтому при усреднении по всем возможным выборкам
mean(sample)сходится к истинному среднему всей генеральной совокупности. Если data представляет всю генеральную совокупность, а не выборку, тоmean(data)эквивалентно вычислению истинного среднего генеральной совокупности μ.
-
statistics.fmean(data, weights=None) -
Преобразует data в числа с плавающей точкой и вычисляет среднее арифметическое.
Эта функция работает быстрее функции
mean()и всегда возвращает значение типаfloat. data может быть последовательностью или итерируемым объектом. Если входной набор данных пуст, возникает исключениеStatisticsError.>>> fmean([3.5, 4.0, 5.25]) 4.25
Поддерживается необязательное взвешивание. Например, преподаватель выставляет итоговую оценку за курс, присваивая тестам вес 20%, домашним заданиям — 20%, промежуточному экзамену — 30%, а итоговому экзамену — 30%:
>>> grades = [85, 92, 83, 91]
>>> weights = [0.20, 0.20, 0.30, 0.30]
>>> fmean(grades, weights)
87.6
Если задан аргумент weights, его длина должна совпадать с длиной data, иначе будет вызвано исключение
ValueError.Добавлено в версии 3.8.
Изменено в версии 3.11: Добавлена поддержка аргумента weights.
-
statistics.geometric_mean(data) -
Преобразует data в числа с плавающей точкой и вычисляет среднее геометрическое.
Среднее геометрическое показывает центральную тенденцию или типичное значение data, используя произведение значений (в отличие от среднего арифметического, при вычислении которого используется их сумма).
Вызывает исключение
StatisticsError, если входной набор данных пуст, содержит ноль или отрицательное значение. data может быть последовательностью или итерируемым объектом.Специальные меры для получения точных результатов не предпринимаются. (Однако в будущем это может измениться.)
>>> round(geometric_mean([54, 24, 36]), 1)
36.0
Добавлено в версии 3.8.
-
statistics.harmonic_mean(data, weights=None) -
Возвращает среднее гармоническое значений data — последовательности или итерируемого объекта, содержащего действительные числа. Если аргумент weights не указан или равен
None, предполагаются равные веса.Среднее гармоническое — это обратная величина среднего арифметического
mean()обратных величин данных. Например, среднее гармоническое трёх значений a, b и c будет эквивалентно3/(1/a + 1/b + 1/c). Если одно из значений равно нулю, результат также будет равен нулю.Среднее гармоническое — это разновидность среднего, мера центрального положения данных. Оно часто подходит для усреднения отношений или скоростей, например скорости движения.
Предположим, автомобиль проезжает 10 км со скоростью 40 км/ч, а затем ещё 10 км со скоростью 60 км/ч. Какова средняя скорость?
>>> harmonic_mean([40, 60])
48.0
Предположим, автомобиль проезжает 5 км со скоростью 40 км/ч, а когда движение становится свободнее, увеличивает скорость до 60 км/ч и проезжает с ней оставшиеся 30 км пути. Какова средняя скорость?
>>> harmonic_mean([40, 60], weights=[5, 30])
56.0
Исключение
StatisticsErrorвозникает, если data пуст, какой-либо элемент меньше нуля или взвешенная сумма не является положительной.В текущем алгоритме предусмотрено досрочное завершение при обнаружении нуля во входных данных. Это означает, что последующие значения не проверяются на допустимость. (В будущем это поведение может измениться.)
Добавлено в версии 3.6.
Изменено в версии 3.10: Добавлена поддержка аргумента weights.
-
statistics.kde(data, h, kernel='normal', *, cumulative=False) -
Оценка плотности ядра (KDE): создание непрерывной функции плотности вероятности или функции распределения по дискретным выборкам.
Основная идея заключается в сглаживании данных с помощью ядерной функции, чтобы делать выводы о генеральной совокупности на основе выборки.
Степень сглаживания задаётся масштабным параметром h, который называется шириной полосы. Меньшие значения подчёркивают локальные особенности, а большие дают более гладкие результаты.
Параметр kernel определяет относительные веса точек выборки. Как правило, выбор формы ядра не так важен, как более значимый параметр сглаживания — ширина полосы.
К ядрам, которые присваивают некоторый вес каждой точке выборки, относятся normal (gauss), logistic и sigmoid.
К ядрам, которые присваивают вес только точкам выборки в пределах ширины полосы, относятся rectangular (uniform), triangular, parabolic (epanechnikov), quartic (biweight), triweight и cosine.
Если cumulative имеет значение true, возвращается функция распределения.
Если последовательность data пуста, будет вызвано исключение
StatisticsError.В Википедии приведён пример, в котором можно использовать
kde()для построения и отображения функции плотности вероятности, оценённой по небольшой выборке:>>> sample = [-2.1, -1.3, -0.4, 1.9, 5.1, 6.2] >>> f_hat = kde(sample, h=1.5) >>> xarr = [i/100 for i in range(-750, 1100)] >>> yarr = [f_hat(x) for x in xarr]
Точки в
xarrиyarrможно использовать для построения графика ФПВ: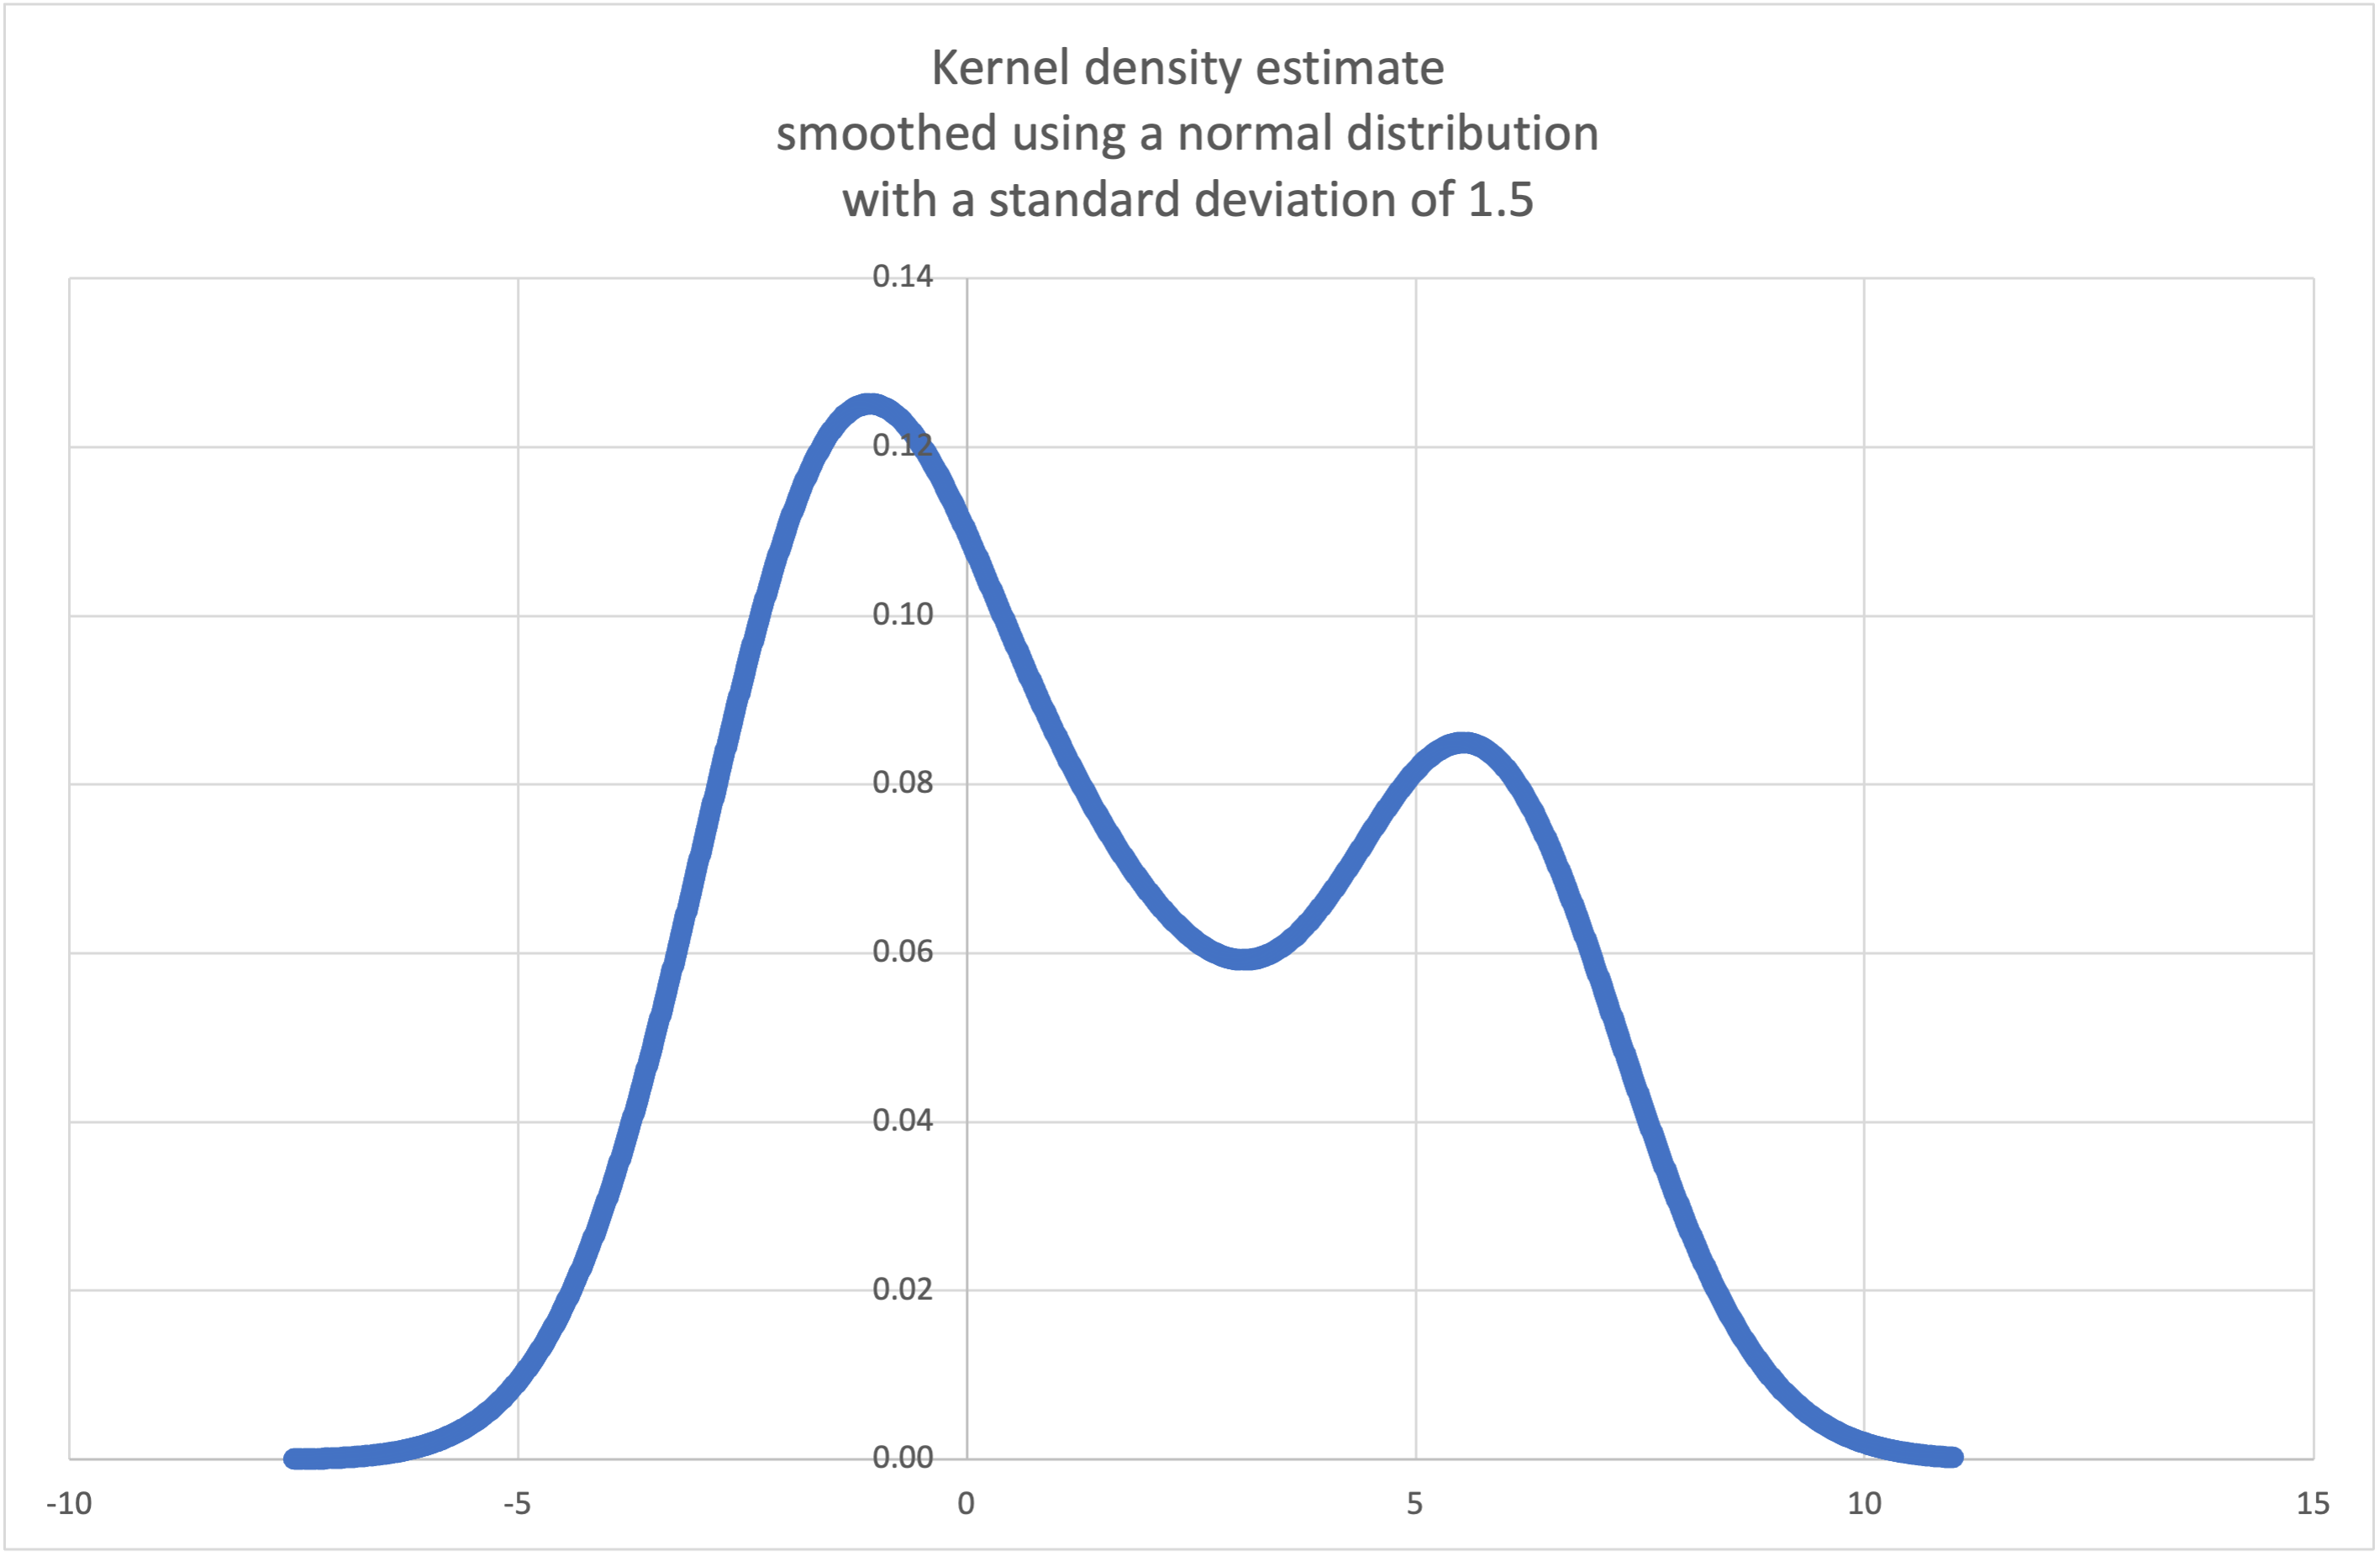
Добавлено в версии 3.13.
-
statistics.kde_random(data, h, kernel='normal', *, seed=None) -
Возвращает функцию, которая выполняет случайный выбор из оценённой функции плотности вероятности, созданной с помощью
kde(data, h, kernel).Аргумент seed позволяет получать воспроизводимые выборки. В будущем значения могут немного измениться по мере внедрения более точных оценок обратной функции распределения ядра. В качестве начального значения можно указать целое число, число с плавающей точкой, строку или байты.
Если последовательность data пуста, будет вызвано исключение
StatisticsError.Продолжая пример для
kde(), можно использоватьkde_random(), чтобы выполнять новые случайные выборки из оценённой функции плотности вероятности:>>> data = [-2.1, -1.3, -0.4, 1.9, 5.1, 6.2] >>> rand = kde_random(data, h=1.5, seed=8675309) >>> new_selections = [rand() for i in range(10)] >>> [round(x, 1) for x in new_selections] [0.7, 6.2, 1.2, 6.9, 7.0, 1.8, 2.5, -0.5, -1.8, 5.6]
Добавлено в версии 3.13.
-
statistics.median(data) -
Возвращает медиану (среднее значение) числовых данных, используя распространённый метод «среднего двух центральных значений». Если data пуст, возникает исключение
StatisticsError. data может быть последовательностью или итерируемым объектом.Медиана — это устойчивая мера центрального положения, на которую наличие выбросов влияет меньше. Если количество точек данных нечётное, возвращается центральная точка данных:
>>> median([1, 3, 5])
3
Если количество точек данных чётное, медиана интерполируется как среднее двух центральных значений:
>>> median([1, 3, 5, 7])
4.0
Этот метод подходит для дискретных данных, если допустимо, что медиана может не совпадать ни с одной из точек данных.
Если данные являются порядковыми (поддерживают операции сравнения), но не числовыми (не поддерживают сложение), рассмотрите возможность использовать вместо этого
median_low()илиmedian_high().
-
statistics.median_low(data) -
Возвращает нижнюю медиану числовых данных. Если data пуст, возникает исключение
StatisticsError. data может быть последовательностью или итерируемым объектом.Нижняя медиана всегда является элементом набора данных. Если количество точек данных нечётное, возвращается центральное значение. Если оно чётное, возвращается меньшее из двух центральных значений.
>>> median_low([1, 3, 5])
3
>>> median_low([1, 3, 5, 7])
3
Используйте нижнюю медиану для дискретных данных, если предпочитаете, чтобы медиана была фактической точкой данных, а не интерполированным значением.
-
statistics.median_high(data) -
Возвращает верхнюю медиану данных. Если data пуст, возникает исключение
StatisticsError. data может быть последовательностью или итерируемым объектом.Верхняя медиана всегда является элементом набора данных. Если количество точек данных нечётное, возвращается центральное значение. Если оно чётное, возвращается большее из двух центральных значений.
>>> median_high([1, 3, 5])
3
>>> median_high([1, 3, 5, 7])
5
Используйте верхнюю медиану для дискретных данных, если предпочитаете, чтобы медиана была фактической точкой данных, а не интерполированным значением.
-
statistics.median_grouped(data, interval=1.0) -
Оценивает медиану числовых данных, сгруппированных или разбитых на интервалы относительно середин последовательных интервалов фиксированной ширины.
data может быть любым итерируемым объектом с числовыми данными, при этом каждое значение должно точно совпадать с серединой интервала. Должно присутствовать хотя бы одно значение.
interval — это ширина каждого интервала.
Например, демографические сведения могут быть сведены в последовательные возрастные группы по десять лет, каждая из которых представлена серединой интервала с шагом в пять лет:
>>> from collections import Counter
>>> demographics = Counter({
...    25: 172,   # 20 to 30 years old
...    35: 484,   # 30 to 40 years old
...    45: 387,   # 40 to 50 years old
...    55:  22,   # 50 to 60 years old
...    65:   6,   # 60 to 70 years old
... })
...
50-й процентиль (медиана) — это 536-й человек в когорте из 1071 человека. Этот человек относится к возрастной группе от 30 до 40 лет.
Обычная функция
median()предположила бы, что каждому человеку в возрастной группе тридцатилетних ровно 35 лет. Более правдоподобное предположение состоит в том, что 484 человека этой группы равномерно распределены по возрасту от 30 до 40 лет. Для этого используетсяmedian_grouped():>>> data = list(demographics.elements()) >>> median(data) 35 >>> round(median_grouped(data, interval=10), 1) 37.5
Вызывающий код должен самостоятельно проверить, что точки данных разделены точными кратными значениями interval. Это необходимо для получения правильного результата. Функция не проверяет выполнение этого предварительного условия.
На вход можно передавать значения любого числового типа, который можно преобразовать в число с плавающей точкой на этапе интерполяции.
-
statistics.mode(data) -
Возвращает единственную наиболее часто встречающуюся точку дискретных или номинальных данных data. Мода (если она существует) является наиболее типичным значением и служит мерой центрального положения.
Если несколько мод имеют одинаковую частоту, возвращается первая из них, встреченная в data. Если требуется наименьшая или наибольшая из них, используйте
min(multimode(data))илиmax(multimode(data)). Если входные данные data пусты, возникает исключениеStatisticsError.modeпредполагает дискретность данных и возвращает одно значение. Это стандартная трактовка моды, обычно изучаемая в школе:>>> mode([1, 1, 2, 3, 3, 3, 3, 4]) 3
Мода уникальна тем, что это единственная статистическая характеристика в данном пакете, применимая также к номинальным (нечисловым) данным:
>>> mode(["red", "blue", "blue", "red", "green", "red", "red"])
'red'
Поддерживаются только хешируемые входные данные. Для работы с типом
setрассмотрите возможность преобразования вfrozenset. Для работы с типомlistрассмотрите возможность преобразования вtuple. Для смешанных или вложенных входных данных можно использовать следующий более медленный алгоритм квадратичной сложности, который требует только проверки на равенство:max(data, key=data.count).Изменено в версии 3.8: Теперь функция обрабатывает наборы данных с несколькими модами, возвращая первую встреченную моду. Ранее она вызывала исключение
StatisticsError, если было найдено более одной моды.
-
statistics.multimode(data) -
Возвращает список наиболее часто встречающихся значений в порядке их первого появления в data. Если мод несколько, возвращается более одного результата; если data пуст, возвращается пустой список:
>>> multimode('aabbbbccddddeeffffgg')
['b', 'd', 'f']
>>> multimode('')
[]
Добавлено в версии 3.8.
-
statistics.pstdev(data, mu=None) -
Возвращает стандартное отклонение генеральной совокупности (квадратный корень из дисперсии генеральной совокупности). Аргументы и другие сведения см. в описании функции
pvariance().>>> pstdev([1.5, 2.5, 2.5, 2.75, 3.25, 4.75]) 0.986893273527251
-
statistics.pvariance(data, mu=None) -
Возвращает дисперсию генеральной совокупности для data — непустой последовательности или итерируемого объекта, содержащего действительные числа. Дисперсия, или второй центральный момент относительно среднего, является мерой изменчивости (разброса или рассеяния) данных. Большая дисперсия указывает на широкий разброс данных; малая — на то, что данные тесно сгруппированы вокруг среднего.
Если указан необязательный второй аргумент mu, он должен быть средним значением генеральной совокупности data. Его также можно использовать для вычисления второго момента относительно точки, не являющейся средним. Если аргумент не указан или равен
None(значение по умолчанию), среднее арифметическое вычисляется автоматически.Используйте эту функцию для вычисления дисперсии всей генеральной совокупности. Для оценки дисперсии выборки обычно лучше подходит функция
variance().Если data пуст, возникает исключение
StatisticsError.Примеры:
>>> data = [0.0, 0.25, 0.25, 1.25, 1.5, 1.75, 2.75, 3.25]
>>> pvariance(data)
1.25
Если среднее ваших данных уже вычислено, его можно передать как необязательный второй аргумент mu, чтобы избежать повторного вычисления:
>>> mu = mean(data)
>>> pvariance(data, mu)
1.25
Поддерживаются значения типа Decimal и Fraction:
>>> from decimal import Decimal as D
>>> pvariance([D("27.5"), D("30.25"), D("30.25"), D("34.5"), D("41.75")])
Decimal('24.815')

>>> from fractions import Fraction as F
>>> pvariance([F(1, 4), F(5, 4), F(1, 2)])
Fraction(13, 72)
Примечание
При вызове для всей генеральной совокупности эта функция возвращает дисперсию генеральной совокупности σ². При вызове для выборки она возвращает смещённую выборочную дисперсию s², также известную как дисперсия с N степенями свободы.
Если вам каким-либо образом известно истинное среднее генеральной совокупности μ, с помощью этой функции можно вычислить дисперсию выборки, передав известное среднее генеральной совокупности вторым аргументом. Если точки данных являются случайной выборкой из генеральной совокупности, результат будет несмещённой оценкой дисперсии генеральной совокупности.
-
statistics.stdev(data, xbar=None) -
Возвращает выборочное стандартное отклонение (квадратный корень из выборочной дисперсии). Аргументы и другие сведения см. в описании функции
variance().>>> stdev([1.5, 2.5, 2.5, 2.75, 3.25, 4.75]) 1.0810874155219827
-
statistics.variance(data, xbar=None) -
Возвращает выборочную дисперсию data — итерируемого объекта как минимум с двумя действительными числами. Дисперсия, или второй центральный момент относительно среднего, является мерой изменчивости (разброса или рассеяния) данных. Большая дисперсия указывает на широкий разброс данных; малая — на то, что данные тесно сгруппированы вокруг среднего.
Если указан необязательный второй аргумент xbar, он должен быть выборочным средним значением data. Если аргумент не указан или равен
None(значение по умолчанию), среднее вычисляется автоматически.Используйте эту функцию, если ваши данные являются выборкой из генеральной совокупности. Для вычисления дисперсии всей генеральной совокупности см.
pvariance().Если в data меньше двух значений, возникает исключение
StatisticsError.Примеры:
>>> data = [2.75, 1.75, 1.25, 0.25, 0.5, 1.25, 3.5]
>>> variance(data)
1.3720238095238095
Если выборочное среднее ваших данных уже вычислено, его можно передать как необязательный второй аргумент xbar, чтобы избежать повторного вычисления:
>>> m = mean(data)
>>> variance(data, m)
1.3720238095238095
Эта функция не пытается проверить, передали ли вы фактическое среднее значение в качестве xbar. Использование произвольных значений для xbar может привести к неверным или невозможным результатам.
Поддерживаются значения типа Decimal и Fraction:
>>> from decimal import Decimal as D
>>> variance([D("27.5"), D("30.25"), D("30.25"), D("34.5"), D("41.75")])
Decimal('31.01875')

>>> from fractions import Fraction as F
>>> variance([F(1, 6), F(1, 2), F(5, 3)])
Fraction(67, 108)
Примечание
Это выборочная дисперсия s² с поправкой Бесселя, также известная как дисперсия с N-1 степенями свободы. Если точки данных являются репрезентативными (например, независимыми и одинаково распределёнными), результат должен быть несмещённой оценкой истинной дисперсии генеральной совокупности.
Если вам каким-либо образом известно фактическое среднее генеральной совокупности μ, передайте его функции
pvariance()в параметре mu, чтобы получить дисперсию выборки.
-
statistics.quantiles(data, *, n=4, method='exclusive') -
Разбивает data на n непрерывных интервалов с равной вероятностью. Возвращает список из
n - 1граничных точек, разделяющих интервалы.Установите n равным 4 для квартилей (значение по умолчанию), 10 — для децилей и 100 — для процентилей; в последнем случае возвращаются 99 граничных точек, разделяющих data на 100 групп одинакового размера. Если n меньше 1, возникает исключение
StatisticsError.data может быть любым итерируемым объектом с выборочными данными. Для получения содержательных результатов количество точек данных в data должно быть больше n. Если нет ни одной точки данных, возникает исключение
StatisticsError.Граничные точки линейно интерполируются между двумя ближайшими точками данных. Например, если граничная точка находится на расстоянии одной трети между двумя значениями выборки,
100и112, то её значение будет равно104.Метод method вычисления квантилей можно менять в зависимости от того, включает ли data наименьшие и наибольшие возможные значения генеральной совокупности.
По умолчанию используется метод “exclusive”; он предназначен для данных, выбранных из генеральной совокупности, в которой могут встречаться значения более экстремальные, чем в выборке. Доля генеральной совокупности, расположенная ниже i-го из m отсортированных значений данных, вычисляется как
i / (m + 1). Для девяти выборочных значений метод сортирует их и присваивает следующие процентили: 10%, 20%, 30%, 40%, 50%, 60%, 70%, 80%, 90%.Метод “inclusive” используется для описания данных генеральной совокупности или выборок, которые, как известно, включают наиболее экстремальные значения генеральной совокупности. Минимальное значение в data считается 0-м процентилем, а максимальное — 100-м процентилем. Доля генеральной совокупности, расположенная ниже i-го из m отсортированных значений данных, вычисляется как
(i - 1) / (m - 1). Для 11 выборочных значений метод сортирует их и присваивает следующие процентили: 0%, 10%, 20%, 30%, 40%, 50%, 60%, 70%, 80%, 90%, 100%.# Decile cut points for empirically sampled data >>> data = [105, 129, 87, 86, 111, 111, 89, 81, 108, 92, 110, ... 100, 75, 105, 103, 109, 76, 119, 99, 91, 103, 129, ... 106, 101, 84, 111, 74, 87, 86, 103, 103, 106, 86, ... 111, 75, 87, 102, 121, 111, 88, 89, 101, 106, 95, ... 103, 107, 101, 81, 109, 104] >>> [round(q, 1) for q in quantiles(data, n=10)] [81.0, 86.2, 89.0, 99.4, 102.5, 103.6, 106.0, 109.8, 111.0]
Добавлено в версии 3.8.
Изменено в версии 3.13: Больше не вызывает исключение, если входные данные содержат только одну точку. Это позволяет накапливать оценки квантилей по одной точке выборки, постепенно повышая их точность с каждой новой точкой.
-
statistics.covariance(x, y, /) -
Возвращает выборочную ковариацию двух входных последовательностей x и y. Ковариация является мерой совместной изменчивости двух входных последовательностей.
Обе входные последовательности должны иметь одинаковую длину (не менее двух элементов), иначе возникает исключение
StatisticsError.Примеры:
>>> x = [1, 2, 3, 4, 5, 6, 7, 8, 9]
>>> y = [1, 2, 3, 1, 2, 3, 1, 2, 3]
>>> covariance(x, y)
0.75
>>> z = [9, 8, 7, 6, 5, 4, 3, 2, 1]
>>> covariance(x, z)
-7.5
>>> covariance(z, x)
-7.5
Добавлено в версии 3.10.
-
statistics.correlation(x, y, /, *, method='linear') -
Возвращает коэффициент корреляции Пирсона для двух входных последовательностей. Коэффициент корреляции Пирсона r принимает значения от -1 до +1. Он измеряет силу и направление линейной зависимости.
Если параметр method равен “ranked”, вычисляется коэффициент ранговой корреляции Спирмена для двух входных последовательностей. Данные заменяются рангами. Ранги совпадающих значений усредняются, чтобы равные значения получали одинаковый ранг. Полученный коэффициент измеряет силу монотонной зависимости.
Корреляция Спирмена подходит для порядковых данных или непрерывных данных, не удовлетворяющих требованию линейной зависимости для коэффициента корреляции Пирсона.
Обе входные последовательности должны иметь одинаковую длину (не менее двух элементов) и не должны быть постоянными, иначе возникает исключение
StatisticsError.Пример на основе законов движения планет Кеплера:
>>> # Mercury, Venus, Earth, Mars, Jupiter, Saturn, Uranus, and  Neptune
>>> orbital_period = [88, 225, 365, 687, 4331, 10_756, 30_687, 60_190]    # days
>>> dist_from_sun = [58, 108, 150, 228, 778, 1_400, 2_900, 4_500] # million km

>>> # Show that a perfect monotonic relationship exists
>>> correlation(orbital_period, dist_from_sun, method='ranked')
1.0

>>> # Observe that a linear relationship is imperfect
>>> round(correlation(orbital_period, dist_from_sun), 4)
0.9882

>>> # Demonstrate Kepler's third law: There is a linear correlation
>>> # between the square of the orbital period and the cube of the
>>> # distance from the sun.
>>> period_squared = [p * p for p in orbital_period]
>>> dist_cubed = [d * d * d for d in dist_from_sun]
>>> round(correlation(period_squared, dist_cubed), 4)
1.0
Добавлено в версии 3.10.
Изменено в версии 3.12: Добавлена поддержка коэффициента ранговой корреляции Спирмена.
-
statistics.linear_regression(x, y, /, *, proportional=False) -
Возвращает наклон и отрезок, отсекаемый на оси, — параметры простой линейной регрессии, оценённые методом наименьших квадратов. Простая линейная регрессия описывает зависимость между независимой переменной x и зависимой переменной y с помощью следующей линейной функции:
y = slope * x + intercept + noise
где
slopeиintercept— оцениваемые параметры регрессии, аnoiseобозначает изменчивость данных, не объяснённую линейной регрессией (она равна разности между предсказанными и фактическими значениями зависимой переменной).Обе входные последовательности должны иметь одинаковую длину (не менее двух элементов), а независимая переменная x не должна быть постоянной; в противном случае возникает исключение
StatisticsError.Например, можно использовать даты выхода фильмов «Монти Пайтон», чтобы предсказать, сколько фильмов «Монти Пайтон» было бы снято к 2019 году, если бы темп производства оставался неизменным.
>>> year = [1971, 1975, 1979, 1982, 1983]
>>> films_total = [1, 2, 3, 4, 5]
>>> slope, intercept = linear_regression(year, films_total)
>>> round(slope * 2019 + intercept)
16
Если proportional имеет значение true, предполагается, что независимая переменная x и зависимая переменная y прямо пропорциональны. Данные аппроксимируются прямой, проходящей через начало координат. Поскольку intercept всегда будет равен 0.0, базовая линейная функция упрощается до следующего вида:
y = slope * x + noise
Продолжая пример из описания функции
correlation(), проверим, насколько хорошо модель, построенная на основе данных о планетах-гигантах, предсказывает расстояния до карликовых планет:>>> model = linear_regression(period_squared, dist_cubed, proportional=True) >>> slope = model.slope >>> # Dwarf planets: Pluto, Eris, Makemake, Haumea, Ceres >>> orbital_periods = [90_560, 204_199, 111_845, 103_410, 1_680] # days >>> predicted_dist = [math.cbrt(slope * (p * p)) for p in orbital_periods] >>> list(map(round, predicted_dist)) [5912, 10166, 6806, 6459, 414] >>> [5_906, 10_152, 6_796, 6_450, 414] # actual distance in million km [5906, 10152, 6796, 6450, 414]
Добавлено в версии 3.10.
Изменено в версии 3.11: Добавлена поддержка параметра proportional.
Исключения
Определено одно исключение:
-
exception statistics.StatisticsError -
Подкласс
ValueErrorдля исключений, связанных со статистикой.
Объекты NormalDist
NormalDist — это инструмент для создания и обработки нормальных распределений случайной величины. Это класс, который рассматривает среднее значение и стандартное отклонение измерений данных как единое целое.
Нормальные распределения возникают в соответствии с центральной предельной теоремой и широко применяются в статистике.
-
class statistics.NormalDist(mu=0.0, sigma=1.0) -
Возвращает новый объект NormalDist, в котором mu представляет среднее арифметическое, а sigma — стандартное отклонение.
Если sigma отрицательно, вызывается исключение
StatisticsError.-
mean -
Атрибут только для чтения, содержащий среднее арифметическое нормального распределения.
-
median -
Атрибут только для чтения, содержащий медиану нормального распределения.
-
mode -
Атрибут только для чтения, содержащий моду нормального распределения.
-
stdev -
Атрибут только для чтения, содержащий стандартное отклонение нормального распределения.
-
variance -
Атрибут только для чтения, содержащий дисперсию нормального распределения. Равна квадрату стандартного отклонения.
-
classmethod from_samples(data) -
Создает экземпляр нормального распределения с параметрами mu и sigma, оцененными на основе data с помощью
fmean()иstdev().data может быть любым итерируемым объектом и должен содержать значения, которые можно преобразовать в тип
float. Если data содержит меньше двух элементов, вызывается исключениеStatisticsError, поскольку для оценки центрального значения нужна как минимум одна точка, а для оценки разброса — как минимум две.
-
samples(n, *, seed=None) -
Генерирует n случайных выборок для заданных среднего значения и стандартного отклонения. Возвращает
listзначений типаfloat.Если задан seed, создается новый экземпляр используемого генератора случайных чисел. Это полезно для получения воспроизводимых результатов, в том числе в многопоточной среде.
Изменено в версии 3.13.
Используется более быстрый алгоритм. Чтобы воспроизвести выборки из предыдущих версий, используйте
random.seed()иrandom.gauss().
-
pdf(x) -
Вычисляет с помощью функции плотности вероятности (pdf) относительную вероятность того, что случайная величина X будет близка к заданному значению x. Математически это предел отношения
P(x <=
X < x+dx) / dx
при стремлении dx к нулю.Относительная вероятность вычисляется как вероятность попадания выборки в узкий диапазон, деленная на ширину этого диапазона (отсюда и слово «плотность»). Поскольку вероятность относительна по отношению к другим точкам, ее значение может быть больше
1.0.
-
cdf(x) -
Вычисляет с помощью функции распределения вероятностей (cdf) вероятность того, что случайная величина X будет меньше или равна x. Математически это записывается как
P(X <= x).
-
inv_cdf(p) -
Вычисляет обратную функцию распределения вероятностей, также известную как квантильная функция или функция процентных точек. Математически это записывается как
x : P(X <= x) = p.Находит значение x случайной величины X, при котором вероятность того, что величина будет меньше или равна этому значению, равна заданной вероятности p.
-
overlap(other) -
Измеряет степень совпадения двух нормальных распределений вероятностей. Возвращает значение от 0.0 до 1.0, соответствующее площади пересечения двух функций плотности вероятности.
-
quantiles(n=4) -
Разбивает нормальное распределение на n непрерывных интервалов с равными вероятностями. Возвращает список из (n - 1) граничных точек, разделяющих интервалы.
Задайте n равным 4, чтобы получить квартили (значение по умолчанию), 10 — чтобы получить децили. Задайте n равным 100, чтобы получить процентили: 99 граничных точек, разделяющих нормальное распределение на 100 групп равного размера.
-
zscore(x) -
Вычисляет стандартизованную оценку, описывающую x через число стандартных отклонений выше или ниже среднего значения нормального распределения:
(x - mean) / stdev.Добавлено в версии 3.9.
Экземпляры
NormalDistподдерживают сложение, вычитание, умножение и деление на константу. Эти операции используются для сдвига и масштабирования. Например:>>> temperature_february = NormalDist(5, 2.5) # Celsius >>> temperature_february * (9/5) + 32 # Fahrenheit NormalDist(mu=41.0, sigma=4.5)
Деление константы на экземпляр
NormalDistне поддерживается, поскольку результат не будет иметь нормального распределения.Поскольку нормальные распределения возникают в результате суммирования эффектов независимых переменных, можно складывать и вычитать две независимые случайные величины с нормальным распределением, представленные экземплярами
NormalDist. Например:>>> birth_weights = NormalDist.from_samples([2.5, 3.1, 2.1, 2.4, 2.7, 3.5]) >>> drug_effects = NormalDist(0.4, 0.15) >>> combined = birth_weights + drug_effects >>> round(combined.mean, 1) 3.1 >>> round(combined.stdev, 1) 0.5
Добавлено в версии 3.8.
-
Примеры и рецепты
Классические задачи теории вероятностей
NormalDist позволяет легко решать классические задачи теории вероятностей.
Например, согласно историческим данным экзаменов SAT, оценки имеют нормальное распределение со средним значением 1060 и стандартным отклонением 195. Определите, какой процент учащихся получил оценки от 1100 до 1200, округлив результат до целого числа:
>>> sat = NormalDist(1060, 195)
>>> fraction = sat.cdf(1200 + 0.5) - sat.cdf(1100 - 0.5)
>>> round(fraction * 100.0, 1)
18.4
Найдите квартили и децили оценок SAT:
>>> list(map(round, sat.quantiles()))
[928, 1060, 1192]
>>> list(map(round, sat.quantiles(n=10)))
[810, 896, 958, 1011, 1060, 1109, 1162, 1224, 1310]
Входные данные для симуляций методом Монте-Карло
Чтобы оценить распределение модели, которую сложно решить аналитически, NormalDist может генерировать входные выборки для симуляции методом Монте-Карло:
>>> def model(x, y, z):
...     return (3*x + 7*x*y - 5*y) / (11 * z)
...
>>> n = 100_000
>>> X = NormalDist(10, 2.5).samples(n, seed=3652260728)
>>> Y = NormalDist(15, 1.75).samples(n, seed=4582495471)
>>> Z = NormalDist(50, 1.25).samples(n, seed=6582483453)
>>> quantiles(map(model, X, Y, Z))
[1.4591308524824727, 1.8035946855390597, 2.175091447274739]
Аппроксимация биномиальных распределений
Нормальные распределения можно использовать для аппроксимации биномиальных распределений, если размер выборки велик, а вероятность успешного испытания близка к 50%.
Например, на конференции по открытому исходному коду присутствуют 750 участников и есть два зала вместимостью по 500 человек. В одном зале проходит доклад о Python, в другом — о Ruby. На предыдущих конференциях 65% участников предпочитали доклады о Python. Если предпочтения участников не изменились, какова вероятность того, что зал с докладами о Python не превысит свою вместимость?
>>> n = 750             # Sample size
>>> p = 0.65            # Preference for Python
>>> q = 1.0 - p         # Preference for Ruby
>>> k = 500             # Room capacity

>>> # Approximation using the cumulative normal distribution
>>> from math import sqrt
>>> round(NormalDist(mu=n*p, sigma=sqrt(n*p*q)).cdf(k + 0.5), 4)
0.8402

>>> # Exact solution using the cumulative binomial distribution
>>> from math import comb, fsum
>>> round(fsum(comb(n, r) * p**r * q**(n-r) for r in range(k+1)), 4)
0.8402

>>> # Approximation using a simulation
>>> from random import seed, binomialvariate
>>> seed(8675309)
>>> mean(binomialvariate(n, p) <= k for i in range(10_000))
0.8406
Наивный байесовский классификатор
Нормальные распределения часто встречаются в задачах машинного обучения.
В Википедии приведен наглядный пример наивного байесовского классификатора. Задача состоит в том, чтобы предсказать пол человека по измерениям признаков с нормальным распределением, включая рост, вес и размер обуви.
Нам предоставлен обучающий набор данных с измерениями для восьми человек. Предполагается, что измерения имеют нормальное распределение, поэтому мы обобщим данные с помощью NormalDist:
>>> height_male = NormalDist.from_samples([6, 5.92, 5.58, 5.92])
>>> height_female = NormalDist.from_samples([5, 5.5, 5.42, 5.75])
>>> weight_male = NormalDist.from_samples([180, 190, 170, 165])
>>> weight_female = NormalDist.from_samples([100, 150, 130, 150])
>>> foot_size_male = NormalDist.from_samples([12, 11, 12, 10])
>>> foot_size_female = NormalDist.from_samples([6, 8, 7, 9])
Затем мы встречаем нового человека, измерения признаков которого известны, но пол неизвестен:
>>> ht = 6.0        # height
>>> wt = 130        # weight
>>> fs = 8          # foot size
Исходя из априорной вероятности 50% для мужского или женского пола, вычислим апостериорную вероятность как произведение априорной вероятности и правдоподобий измерений признаков при заданном поле:
>>> prior_male = 0.5
>>> prior_female = 0.5
>>> posterior_male = (prior_male * height_male.pdf(ht) *
...                   weight_male.pdf(wt) * foot_size_male.pdf(fs))

>>> posterior_female = (prior_female * height_female.pdf(ht) *
...                     weight_female.pdf(wt) * foot_size_female.pdf(fs))
В качестве окончательного предсказания выбирается наибольшая апостериорная вероятность. Этот метод называется оценкой максимума апостериорной вероятности, или MAP:
>>> 'male' if posterior_male > posterior_female else 'female'
'female'
© 2001–2025 Python Software Foundation
Licensed under the PSF License.
https://docs.python.org/3.13/library/statistics.html


