numpy.random.standard_t
-
numpy.random.standard_t(df, size=None) -
Генерация выборок из стандартного распределения Стьюдента с
dfстепенями свободы.Частный случай гиперболического распределения. По мере роста
df, результат приближается к стандартному нормальному распределению (standard_normal).Параметры: df : int или array_like целых чисел
Степени свободы, должны быть > 0.
size : int или кортеж из целых чисел, необязательно
Форма выходных данных. Если заданная форма, например,
(m, n, k), то генерируетсяm * n * kвыборок. Если size не указан (по умолчанию), возвращается одно значение, еслиdfявляется скалярным. В противном случае генерируетсяnp.array(df).sizeвыборок.Возвращаемое значение: out : ndarray или скаляр
Сгенерированные выборки из стандартного распределения Стьюдента.
Примечания
Функция плотности вероятности для распределения Стьюдента
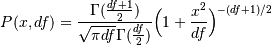
Критерий Стьюдента основан на предположении, что данные получены из нормального распределения. Критерий Стьюдента позволяет проверить, является ли выборочное среднее (среднее, вычисленное из данных) хорошим приближением истинного среднего.
Вычисление распределения Стьюдента впервые было опубликовано в 1908 году Уильямом Гиссетом во время работы в пивоварне Гиннесс в Дублине. Из-за проблем с авторским правом он был вынужден публиковаться под псевдонимом, поэтому использовал имя Стьюдент.
Ссылки
[R267] (1, 2) Dalgaard, Peter, “Вводный курс статистики с R”, Springer, 2002. [R268] Википедия, “Распределение Стьюдента” http://en.wikipedia.org/wiki/Student’s_t-distribution Примеры
Из книги Dalgaard, страница 83 [R267], предположим, что суточная энергетическая потребность 11 женщин в Кдж:
>>> intake = np.array([5260., 5470, 5640, 6180, 6390, 6515, 6805, 7515, \
...                    7515, 8230, 8770])
Отклоняется ли их энергетическая потребность систематически от рекомендуемой величины в 7725 кДж?
У нас есть 10 степеней свободы, поэтому находится ли выборочное среднее значение в пределах 95% от рекомендуемого значения?
>>> s = np.random.standard_t(10, size=100000)
>>> np.mean(intake)
6753.636363636364
>>> intake.std(ddof=1)
1142.1232221373727
Рассчитайте статистику t, установив параметр ddof в значение для несмещённой оценки, чтобы знаменатель в стандартном отклонении был степенями свободы, N-1.
>>> t = (np.mean(intake)-7725)/(intake.std(ddof=1)/np.sqrt(len(intake)))
>>> import matplotlib.pyplot as plt
>>> h = plt.hist(s, bins=100, normed=True)
Для одностороннего t-теста, как далеко по распределению находится t-статистика?
>>> np.sum(s<t) / float(len(s))
0.0090699999999999999  #random
Таким образом, p-значение составляет около 0,009, что говорит о том, что вероятность истинности нулевой гипотезы составляет около 99%.
(Исходный код, png, pdf)

© 2008–2017 NumPy Developers
Licensed under the NumPy License.
https://docs.scipy.org/doc/numpy-1.12.0/reference/generated/numpy.random.standard_t.html



