Примечание
Перейти к концу, чтобы загрузить весь пример кода. или запустить этот пример в браузере через JupyterLite или Binder
Основные изменения в scikit-learn 1.0
Мы очень рады объявить о выпуске scikit-learn 1.0! Библиотека стабильна уже довольно долго, выпуск версии 1.0 подтверждает это и сигнализирует об этом нашим пользователям. Этот выпуск не включает в себя каких-либо критических изменений, кроме обычного цикла устаревания за два выпуска. В будущем мы будем стараться придерживаться этой модели.
Этот выпуск включает в себя несколько новых ключевых функций, а также множество улучшений и исправления ошибок. Ниже мы подробно описываем некоторые из основных функций этого выпуска. Для получения исчерпывающего списка всех изменений, пожалуйста, обратитесь к примечаниям к выпуску.
Для установки последней версии (с помощью pip):
pip install --upgrade scikit-learn
или с помощью conda:
conda install -c conda-forge scikit-learn
Ключевые и позиционные аргументы
API scikit-learn предоставляет множество функций и методов, которые имеют множество входных параметров. Например, до этого выпуска можно было создать экземпляр HistGradientBoostingRegressor следующим образом:
HistGradientBoostingRegressor("squared_error", 0.1, 100, 31, None,
    20, 0.0, 255, None, None, False, "auto", "loss", 0.1, 10, 1e-7,
    0, None)
Для понимания вышеприведенного кода необходимо обратиться к документации API и проверить каждый параметр, чтобы понять его позицию и значение. Чтобы улучшить читаемость кода, написанного на основе scikit-learn, теперь пользователи должны указывать большинство параметров с их именами в качестве ключевых аргументов вместо позиционных аргументов. Например, вышеприведенный код можно переписать следующим образом:
HistGradientBoostingRegressor(
    loss="squared_error",
    learning_rate=0.1,
    max_iter=100,
    max_leaf_nodes=31,
    max_depth=None,
    min_samples_leaf=20,
    l2_regularization=0.0,
    max_bins=255,
    categorical_features=None,
    monotonic_cst=None,
    warm_start=False,
    early_stopping="auto",
    scoring="loss",
    validation_fraction=0.1,
    n_iter_no_change=10,
    tol=1e-7,
    verbose=0,
    random_state=None,
)
что намного более читаемо. Позиционные аргументы устарели с версии 0.23 и теперь будут вызывать TypeError. Ограниченное количество позиционных аргументов все еще разрешено в некоторых случаях, например, в PCA, где PCA(10) все еще разрешено, но PCA(10,
False) нет.
Преобразователи сплайнов
Один из способов добавить нелинейные члены к набору признаков набора данных — это сгенерировать функции базиса сплайнов для непрерывных/числовых признаков с помощью нового SplineTransformer. Сплайны представляют собой кусковые полиномы, параметризованные степенью полинома и позициями узлов. SplineTransformer реализует базис B-сплайнов.

Следующий код демонстрирует работу сплайнов. Для получения дополнительной информации, пожалуйста, обратитесь к Руководству пользователя.
import numpy as np
from sklearn.preprocessing import SplineTransformer

X = np.arange(5).reshape(5, 1)
spline = SplineTransformer(degree=2, n_knots=3)
spline.fit_transform(X)
array([[0.5  , 0.5  , 0.   , 0.   ],
       [0.125, 0.75 , 0.125, 0.   ],
       [0.   , 0.5  , 0.5  , 0.   ],
       [0.   , 0.125, 0.75 , 0.125],
       [0.   , 0.   , 0.5  , 0.5  ]])
Регрессор квантилей
Регрессия квантилей оценивает медиану или другие квантили \(y\) при условии \(X\), в то время как обычный метод наименьших квадратов (OLS) оценивает условное среднее.
В качестве линейной модели новый QuantileRegressor дает линейные прогнозы \(\hat{y}(w, X) = Xw\) для \(q\)-го квантиля, \(q \in (0, 1)\). Веса или коэффициенты \(w\) затем находятся с помощью следующей задачи минимизации:
Это состоит из потери пинбола (также известной как линейная потеря), см. также mean_pinball_loss,
и штрафа L1, управляемого параметром alpha, аналогично linear_model.Lasso.
Пожалуйста, ознакомьтесь с приведенным примером, чтобы увидеть, как это работает, и с Руководством пользователя для получения более подробной информации.

Поддержка имен признаков
Когда оценщик получает pandas’ dataframe во время fit, оценщик установит атрибут feature_names_in_, содержащий имена признаков. Обратите внимание, что поддержка имен признаков включена только тогда, когда все имена столбцов в dataframe являются строками. feature_names_in_ используется для проверки того, что имена столбцов dataframe, переданные в операции, отличные от fit, такие как predict, согласуются с признаками в fit:
from sklearn.preprocessing import StandardScaler
import pandas as pd

X = pd.DataFrame([[1, 2, 3], [4, 5, 6]], columns=["a", "b", "c"])
scalar = StandardScaler().fit(X)
scalar.feature_names_in_
array(['a', 'b', 'c'], dtype=object)
Поддержка get_feature_names_out доступна для преобразователей, которые уже имели get_feature_names и преобразователей с взаимно-однозначным соответствием между входом и выходом, таких как StandardScaler. get_feature_names_out будет добавлен ко всем остальным преобразователям в будущих версиях. Кроме того, compose.ColumnTransformer.get_feature_names_out доступен для объединения имен признаков его преобразователей:
from sklearn.compose import ColumnTransformer
from sklearn.preprocessing import OneHotEncoder
import pandas as pd

X = pd.DataFrame({"pet": ["dog", "cat", "fish"], "age": [3, 7, 1]})
preprocessor = ColumnTransformer(
    [
        ("numerical", StandardScaler(), ["age"]),
        ("categorical", OneHotEncoder(), ["pet"]),
    ],
    verbose_feature_names_out=False,
).fit(X)

preprocessor.get_feature_names_out()
array(['age', 'pet_cat', 'pet_dog', 'pet_fish'], dtype=object)
Когда этот preprocessor используется с конвейером, имена признаков, используемые классификатором, получают путем среза и вызова get_feature_names_out:
from sklearn.linear_model import LogisticRegression
from sklearn.pipeline import make_pipeline

y = [1, 0, 1]
pipe = make_pipeline(preprocessor, LogisticRegression())
pipe.fit(X, y)
pipe[:-1].get_feature_names_out()
array(['age', 'pet_cat', 'pet_dog', 'pet_fish'], dtype=object)
Более гибкий API для построения графиков
metrics.ConfusionMatrixDisplay, metrics.PrecisionRecallDisplay, metrics.DetCurveDisplay и inspection.PartialDependenceDisplay теперь предоставляют два метода класса: from_estimator и from_predictions, которые позволяют пользователям создавать график на основе прогнозов или оценщика. Это означает, что соответствующие функции plot_* устарели. Пожалуйста, проверьте пример один и пример два для получения информации о том, как использовать новые возможности построения графиков.
Онлайн-SVM для одного класса
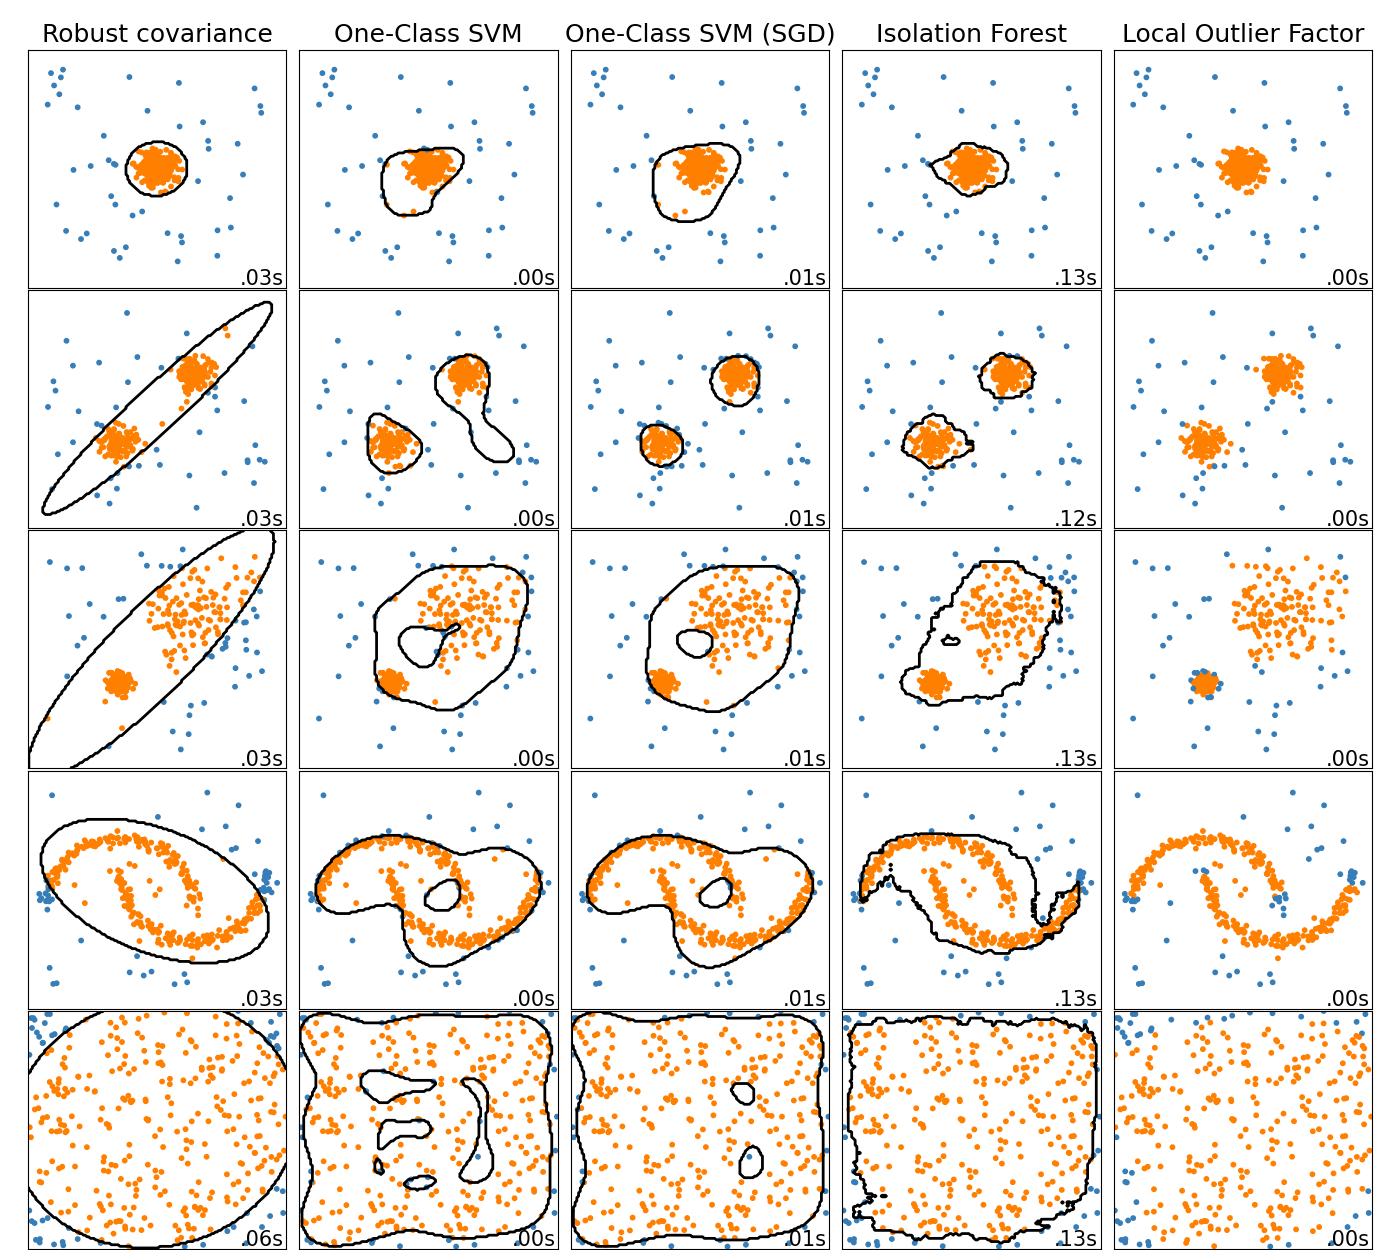
Новый класс SGDOneClassSVM реализует онлайн-линейную версию SVM для одного класса, используя стохастический градиентный спуск. В сочетании с методами приближения ядер SGDOneClassSVM может быть использовано для приближения решения SVM для одного класса с ядром, реализованного в OneClassSVM, с линейной по количеству образцов сложностью обучения. Обратите внимание, что сложность SVM для одного класса с ядром в лучшем случае квадратична по количеству образцов. SGDOneClassSVM хорошо подходит для наборов данных с большим количеством обучающих образцов (> 10 000), для которых вариант SGD может быть на несколько порядков быстрее. Пожалуйста, ознакомьтесь с этим примером, чтобы увидеть, как он используется, и с Руководством пользователя для получения более подробной информации.
Модели градиентного бустинга на основе гистограмм теперь стабильны
HistGradientBoostingRegressor и HistGradientBoostingClassifier больше не являются экспериментальными и могут быть просто импортированы и использованы следующим образом:
from sklearn.ensemble import HistGradientBoostingClassifier
Новые улучшения документации
Этот релиз включает в себя множество улучшений документации. Из более чем 2100 объединённых запросов на изменение, около 800 из них являются улучшениями нашей документации.
Общее время выполнения скрипта: (0 минут 0,017 секунд)


Связанные примеры


© 2007–2025 The scikit-learn developers
Licensed under the 3-clause BSD License.
https://scikit-learn.org/1.6/auto_examples/release_highlights/plot_release_highlights_1_0_0.html


