1.2. Линейный и квадратичный дискриминантный анализ
Линейный дискриминантный анализ (LinearDiscriminantAnalysis) и квадратичный дискриминантный анализ (QuadraticDiscriminantAnalysis) — два классических классификатора, у которых, как следует из их названий, линейная и квадратичная поверхности решений соответственно.
Эти классификаторы привлекательны, потому что они имеют замкнутые решения, которые легко вычисляются, по своей природе многоклассовые, показали хорошую работу на практике и не имеют параметров, требующих настройки.
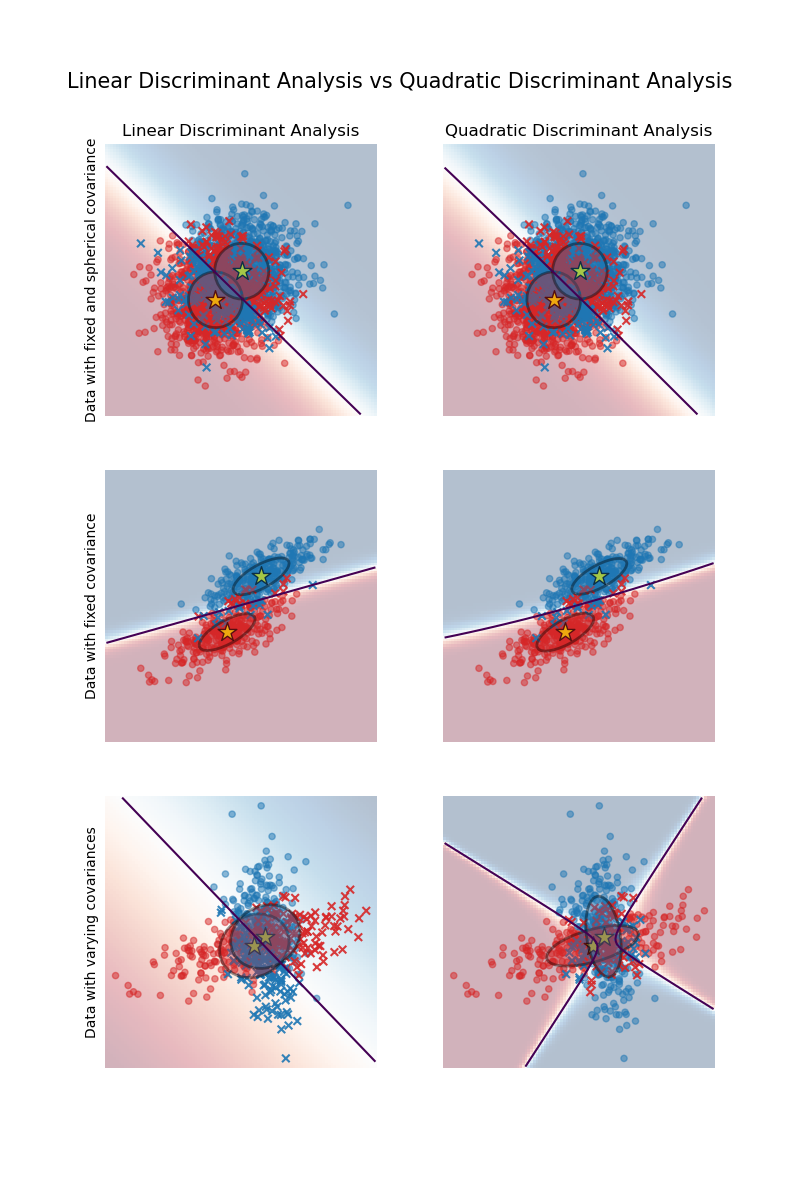
На графике показаны границы решений для линейного и квадратичного дискриминантного анализа. Нижняя строка демонстрирует, что линейный дискриминантный анализ может научиться только линейным границам, в то время как квадратичный дискриминантный анализ может научиться квадратичным границам и поэтому более гибкий.
Примеры
- Линейный и квадратичный дискриминантный анализ с эллипсом ковариации: Сравнение LDA и QDA на синтетических данных.
1.2.1. Снижение размерности с помощью линейного дискриминантного анализа
LinearDiscriminantAnalysis можно использовать для выполнения контролируемого снижения размерности, проецируя входные данные на линейное подпространство, состоящее из направлений, которые максимизируют разделяемость классов (в точном смысле, рассмотренном в разделе математики ниже). Размерность выходных данных обязательно меньше числа классов, поэтому, как правило, это достаточно сильное снижение размерности и имеет смысл только в многоклассовой постановке задачи.
Это реализовано в методе transform. Желаемую размерность можно задать с помощью параметра n_components. Этот параметр не оказывает влияния на методы fit и predict.
Примеры
- Сравнение LDA и PCA: 2D проекция набора данных Iris: Сравнение LDA и PCA для уменьшения размерности набора данных Iris.
1.2.2. Математическая формулировка классификаторов LDA и QDA
Как LDA, так и QDA могут быть получены из простых вероятностных моделей, которые моделируют условное распределение данных \(P(X|y=k)\) для каждого класса \(k\). Предсказания затем можно получить, используя правило Байеса, для каждой тренировочной выборки \(x \in \mathcal{R}^d\):
и мы выбираем класс \(k\), который максимизирует эту апостериорную вероятность.
Более конкретно, для линейного и квадратичного дискриминантного анализа, \(P(x|y)\) моделируется как многомерное нормальное распределение с плотностью:
где \(d\) — число признаков.
1.2.2.1. QDA
Согласно вышеприведенной модели, логарифм апостериорной вероятности:
где постоянная \(Cst\) соответствует знаменателю \(P(x)\), помимо других постоянных величин из нормального распределения. Предсказанный класс — тот, который максимизирует этот логарифм апостериорной вероятности.
Примечание
Связь с гауссовским байесовским наивным классификатором
Если в модели QDA предполагается, что ковариационные матрицы диагональны, то входные данные считаются условно независимыми в каждом классе, и полученный классификатор эквивалентен классификатору гауссовского байесовского наивного классификатора naive_bayes.GaussianNB.
1.2.2.2. LDA
LDA является частным случаем QDA, где гауссовы распределения для каждого класса предполагают одинаковую ковариационную матрицу: \(\Sigma_k = \Sigma\) для всех \(k\). Это сводит логарифм апостериорной вероятности к:
Выражение \((x-\mu_k)^t \Sigma^{-1} (x-\mu_k)\) соответствует расстоянию Махаланобиса между выборкой \(x\) и средним значением \(\mu_k\). Расстояние Махаланобиса показывает, насколько близка \(x\) к \(\mu_k\), учитывая также дисперсию каждого признака. Таким образом, мы можем интерпретировать LDA как присвоение \(x\) тому классу, среднее значение которого является ближайшим с точки зрения расстояния Махаланобиса, учитывая также априорные вероятности классов.
Логарифм апостериорной вероятности LDA также можно записать [3] как:
где \(\omega_k = \Sigma^{-1} \mu_k\) и \(\omega_{k0} = -\frac{1}{2} \mu_k^t\Sigma^{-1}\mu_k + \log P (y = k)\). Эти величины соответствуют атрибутам coef_ и intercept_ соответственно.
Из приведенной формулы ясно, что LDA имеет линейную поверхность решений. В случае QDA нет предположений о ковариационных матрицах \(\Sigma_k\) гауссовских распределений, что приводит к квадратичным поверхностям решений. Дополнительные сведения см. в [1].
1.2.3. Математическая формулировка снижения размерности с помощью LDA
Сначала обратите внимание, что K средних \(\mu_k\) — векторы в \(\mathcal{R}^d\), и они лежат в аффином подпространстве \(H\) размерностью не более \(K - 1\) (2 точки лежат на прямой, 3 точки лежат на плоскости и т. д.).
Как упоминалось выше, мы можем интерпретировать LDA как присвоение \(x\) тому классу, среднее значение которого \(\mu_k\) является ближайшим в терминах расстояния Махаланобиса, учитывая также априорные вероятности классов. Альтернативно, LDA эквивалентна сначала приведению к сфере данных, чтобы ковариационная матрица была единичной, а затем присвоению \(x\) ближайшему среднему значению в терминах евклидова расстояния (при этом по-прежнему учитываются априорные вероятности классов).
Вычисление евклидовых расстояний в этом d-мерном пространстве эквивалентно сначала проекции точек данных на \(H\) и вычислению расстояний там (поскольку другие измерения будут одинаково влиять на каждый класс с точки зрения расстояния). Другими словами, если \(x\) ближе к \(\mu_k\) в исходном пространстве, то это также будет иметь место в \(H\). Это показывает, что в неявном виде в классификаторе LDA происходит снижение размерности путем линейного проектирования на \(K-1\)-мерное пространство.
Мы можем уменьшить размерность еще больше, до выбранного значения \(L\), спроецировав на линейное подпространство \(H_L\), которое максимизирует дисперсию \(\mu^*_k\) после проектирования (по сути, мы делаем вид PCA для преобразованных средних значений классов \(\mu^*_k\)). Это значение \(L\) соответствует параметру n_components , используемому в методе transform. Дополнительные сведения см. в [1].
1.2.4. Сжатие и оценщик ковариации
Сжатие — это форма регуляризации, используемая для улучшения оценки ковариационных матриц в ситуациях, когда количество обучающих выборок мало по сравнению с количеством признаков. В этом случае эмпирическая ковариационная матрица является плохой оценкой, и сжатие помогает улучшить обобщающую способность классификатора. Сжатие LDA можно использовать, установив параметр shrinkage класса LinearDiscriminantAnalysis в значение ‘auto’. Это автоматически определяет оптимальный параметр сжатия аналитическим способом, следуя лемме, введенной Ледоитом и Вольфом [2]. Обратите внимание, что в настоящее время сжатие работает только при установке параметра solver в ‘lsqr’ или ‘eigen’.
Параметр shrinkage также можно вручную установить в значение от 0 до 1. В частности, значение 0 соответствует отсутствию сжатия (что означает, что будет использоваться эмпирическая ковариационная матрица), а значение 1 соответствует полному сжатию (что означает, что диагональная матрица дисперсий будет использоваться как оценка ковариационной матрицы). Установка этого параметра в значение между этими двумя экстремумами позволит оценить сжатую версию ковариационной матрицы.
Сжатая оценка ковариации Ледоита и Вольфа не всегда является лучшим выбором. Например, если распределение данных является нормальным, оценка Oracle Approximating Shrinkage sklearn.covariance.OAS обеспечивает меньшую среднеквадратическую ошибку, чем оценка, полученная по формуле Ледоита и Вольфа при shrinkage=”auto”. В LDA данные предполагаются гауссовыми при условии класса. Если эти предположения верны, использование LDA с оценкой ковариации OAS даст более высокую точность классификации, чем использование оценки Ледоита и Вольфа или эмпирической оценки ковариации.
Оценщик ковариации можно выбрать, используя параметр covariance_estimator класса discriminant_analysis.LinearDiscriminantAnalysis. Оценщик ковариации должен иметь метод fit и атрибут covariance_ как все оценщики ковариации в модуле sklearn.covariance.

Примеры
- Нормальный, Ledoit-Wolf и OAS линейный дискриминантный анализ для классификации: Сравнение LDA-классификаторов с эмпирическим, Ledoit-Wolf и OAS оценщиками ковариации.
1.2.5. Алгоритмы оценки
Использование LDA и QDA требует вычисления логарифмического апостериорного распределения, которое зависит от априорных вероятностей классов \(P(y=k)\), средних значений классов \(\mu_k\) и ковариационных матриц.
По умолчанию для LinearDiscriminantAnalysis используется решатель ‘svd’, и это единственный доступный решатель для QuadraticDiscriminantAnalysis. Он может выполнять как классификацию, так и преобразование (для LDA). Поскольку он не зависит от вычисления ковариационной матрицы, решатель ‘svd’ может быть предпочтительнее в ситуациях, где количество признаков велико. Решатель ‘svd’ не может использоваться со сжатием. Для QDA использование решателя SVD основано на том, что ковариационная матрица \(\Sigma_k\) по определению равна \(\frac{1}{n - 1} X_k^tX_k = \frac{1}{n - 1} V S^2 V^t\), где \(V\) получено из SVD (центрированной) матрицы: \(X_k = U S V^t\). Оказывается, что мы можем вычислить логарифмическое апостериорное распределение выше, не вычисляя явным образом \(\Sigma\): вычисление \(S\) и \(V\) с помощью SVD матрицы \(X\) достаточно. Для LDA вычисляются два SVD: SVD центрированной входной матрицы \(X\) и SVD средних векторов по классам.
Решатель ‘lsqr’ — это эффективный алгоритм, который работает только для классификации. Он требует явного вычисления ковариационной матрицы \(\Sigma\) и поддерживает сжатие и пользовательские оценщики ковариации. Этот решатель вычисляет коэффициенты \(\omega_k = \Sigma^{-1}\mu_k\), решая \(\Sigma \omega = \mu_k\), тем самым избегая явного вычисления обратной матрицы \(\Sigma^{-1}\).
Решатель ‘eigen’ основан на оптимизации отношения между рассеиванием по классам и рассеиванием внутри классов. Он может использоваться для классификации и преобразования, и он поддерживает сжатие. Однако решатель ‘eigen’ требует вычисления ковариационной матрицы, поэтому он может быть непригоден для ситуаций с большим количеством признаков.
Ссылки
© 2007–2025 The scikit-learn developers
Licensed under the 3-clause BSD License.
https://scikit-learn.org/1.6/modules/lda_qda.html


