1.4. Машины опорных векторов
Машины опорных векторов (SVM) — это набор методов обучения с учителем, используемых для классификации, регрессии и обнаружения выбросов.
Преимущества машин опорных векторов:
- Эффективны в многомерных пространствах.
- Остаются эффективными в случаях, когда количество измерений больше количества образцов.
- Используют подмножество точек обучения в функции принятия решений (называемые опорными векторами), поэтому также экономичны по памяти.
- Гибкие: для функции принятия решений можно задавать различные ядра. Предоставляются общие ядра, но также можно задавать пользовательские ядра.
Недостатки машин опорных векторов:
- Если количество признаков намного больше, чем количество образцов, важно избегать переобучения при выборе ядер и важен регуляризационный член.
- Машины опорных векторов напрямую не предоставляют оценки вероятности, эти оценки рассчитываются с помощью дорогостоящей пятикратной перекрёстной проверки (см. Оценки и вероятности ниже).
Машины опорных векторов в scikit-learn поддерживают как плотные (numpy.ndarray и преобразуемые к этому с помощью numpy.asarray), так и разреженные (любые scipy.sparse) векторы образцов в качестве входных данных. Однако для использования SVM для предсказания разреженных данных, оно должно было быть обучено на таких данных. Для оптимальной производительности используйте C-упорядоченные numpy.ndarray (плотные) или scipy.sparse.csr_matrix (разреженные) с dtype=float64.
1.4.1. Классификация
SVC, NuSVC и LinearSVC — это классы, способные выполнять бинарную и многоклассовую классификацию набора данных.

SVC и NuSVC — это похожие методы, но принимающие несколько другие наборы параметров и имеющие разные математические формулировки (см. раздел Математическая формулировка). С другой стороны, LinearSVC — это еще одна (более быстрая) реализация классификации опорных векторов для случая линейного ядра. Она также лишена некоторых атрибутов SVC и NuSVC, таких как support_. LinearSVC использует squared_hinge потерю и из-за своей реализации в liblinear также регуляризует свободный член, если он рассматривается. Однако этот эффект можно уменьшить, тщательно настраивая параметр intercept_scaling, что позволяет члену свободного члена иметь другое поведение регуляризации по сравнению с другими признаками. Результаты классификации и оценка, следовательно, могут отличаться от результатов других двух классификаторов.
Как и другие классификаторы, SVC, NuSVC и LinearSVC принимают в качестве входных данных два массива: массив X формы (n_samples, n_features), содержащий обучающие образцы, и массив y меток классов (строки или целые числа) формы (n_samples):
>>> from sklearn import svm
>>> X = [[0, 0], [1, 1]]
>>> y = [0, 1]
>>> clf = svm.SVC()
>>> clf.fit(X, y)
SVC()
После обучения модель может использоваться для предсказания новых значений:
>>> clf.predict([[2., 2.]])
array([1])
Функция принятия решений SVM (подробно описанная в Математической формулировке) зависит от некоторого подмножества обучающих данных, называемых опорными векторами. Некоторые свойства этих опорных векторов можно найти в атрибутах support_vectors_, support_ и n_support_:
>>> # get support vectors
>>> clf.support_vectors_
array([[0., 0.],
       [1., 1.]])
>>> # get indices of support vectors
>>> clf.support_
array([0, 1]...)
>>> # get number of support vectors for each class
>>> clf.n_support_
array([1, 1]...)
Примеры
1.4.1.1. Многоклассовая классификация
SVC и NuSVC реализуют подход «один против одного» для многоклассовой классификации. В общей сложности строится n_classes * (n_classes - 1) / 2 классификаторов, и каждый из них обучается на данных из двух классов. Для обеспечения согласованного интерфейса с другими классификаторами, опция decision_function_shape позволяет монотонно преобразовывать результаты классификаторов «один против одного» в функцию принятия решений «один против всех» формы (n_samples, n_classes), что является значением параметра по умолчанию (по умолчанию=’ovr’).
>>> X = [[0], [1], [2], [3]]
>>> Y = [0, 1, 2, 3]
>>> clf = svm.SVC(decision_function_shape='ovo')
>>> clf.fit(X, Y)
SVC(decision_function_shape='ovo')
>>> dec = clf.decision_function([[1]])
>>> dec.shape[1] # 6 classes: 4*3/2 = 6
6
>>> clf.decision_function_shape = "ovr"
>>> dec = clf.decision_function([[1]])
>>> dec.shape[1] # 4 classes
4
С другой стороны, LinearSVC реализует многоклассовую стратегию «один против всех», тем самым обучая n_classes модели.
>>> lin_clf = svm.LinearSVC()
>>> lin_clf.fit(X, Y)
LinearSVC()
>>> dec = lin_clf.decision_function([[1]])
>>> dec.shape[1]
4
См. Математическая формулировка для полного описания функции принятия решений.
Подробности о многоклассовых стратегиях
Обратите внимание, что LinearSVC также реализует альтернативную многоклассовую стратегию, так называемую многоклассовую SVM, сформулированную Crammer и Singer [16], используя опцию multi_class='crammer_singer'. На практике классификация «один против всех» обычно предпочтительнее, так как результаты в основном похожи, но время выполнения значительно меньше.
Для «один против всех» LinearSVC атрибуты coef_ и intercept_ имеют форму (n_classes, n_features) и (n_classes,) соответственно. Каждая строка коэффициентов соответствует одному из n_classes классификаторов «один против всех», и аналогично для констант, в порядке класса «один».
В случае «один против одного» SVC и NuSVC структура атрибутов немного сложнее. В случае линейного ядра атрибуты coef_ и intercept_ имеют форму (n_classes * (n_classes - 1) / 2, n_features) и (n_classes *
(n_classes - 1) / 2) соответственно. Это аналогично структуре для LinearSVC, описанной выше, при этом каждая строка теперь соответствует бинарному классификатору. Порядок для классов от 0 до n — «0 против 1», «0 против 2», … «0 против n», «1 против 2», «1 против 3», «1 против n», . . . «n-1 против n».
Форма dual_coef_ равна (n_classes-1, n_SV) со сложной структурой. Столбцы соответствуют опорным векторам, вовлечённым в любой из n_classes * (n_classes - 1) / 2 классификаторов «один против одного». Каждый опорный вектор v имеет коэффициент дуального решения в каждом из n_classes - 1 классификаторов, сравнивающих класс v с другим классом. Обратите внимание, что некоторые, но не все, из этих коэффициентов дуального решения могут быть равны нулю. Элементы n_classes - 1 в каждом столбце — эти коэффициенты дуального решения, упорядоченные по противоположному классу.
Это может быть понятнее на примере: рассмотрим задачу с тремя классами, где класс 0 имеет три опорных вектора \(v^{0}_0, v^{1}_0, v^{2}_0\), а классы 1 и 2 имеют по два опорных вектора \(v^{0}_1, v^{1}_1\) и \(v^{0}_2, v^{1}_2\) соответственно. Для каждого опорного вектора \(v^{j}_i\) существуют два коэффициента дуального решения. Назовем коэффициент опорного вектора \(v^{j}_i\) в классификаторе между классами \(i\) и \(k\) \(\alpha^{j}_{i,k}\). Тогда dual_coef_ выглядит так:
\(\alpha^{0}_{0,1}\) | \(\alpha^{1}_{0,1}\) | \(\alpha^{2}_{0,1}\) | \(\alpha^{0}_{1,0}\) | \(\alpha^{1}_{1,0}\) | \(\alpha^{0}_{2,0}\) | \(\alpha^{1}_{2,0}\) |
\(\alpha^{0}_{0,2}\) | \(\alpha^{1}_{0,2}\) | \(\alpha^{2}_{0,2}\) | \(\alpha^{0}_{1,2}\) | \(\alpha^{1}_{1,2}\) | \(\alpha^{0}_{2,1}\) | \(\alpha^{1}_{2,1}\) |
Коэффициенты для ОВ класса 0 | Коэффициенты для ОВ класса 1 | Коэффициенты для ОВ класса 2 | ||||
Примеры
1.4.1.2. Оценки и вероятности
Метод decision_function для SVC и NuSVC возвращает оценки для каждого класса для каждого образца (или единственную оценку на образец в бинарном случае). Когда опция конструктора probability установлена в True, включены оценки вероятности принадлежности к классам (из методов predict_proba и predict_log_proba). В бинарном случае вероятности откалиброваны с помощью шкалирования Платта [9]: логистическая регрессия на оценках SVM, подгоняемая дополнительной перекрестной проверкой на обучающих данных. В многоклассовом случае это расширено в соответствии с [10].
Примечание
Такой же метод откалибровки вероятностей доступен для всех оценщиков с помощью CalibratedClassifierCV (см. Откалибровка вероятностей). В случае SVC и NuSVC, эта процедура реализована в libsvm, которая используется под капотом, поэтому она не зависит от CalibratedClassifierCV scikit-learn.
Перекрестная проверка, используемая в шкалировании Платта, является дорогостоящей операцией для больших наборов данных. Кроме того, оценки вероятностей могут быть несогласованными с оценками:
- «argmax» оценок может не совпадать с argmax вероятностей
- в бинарной классификации образец может быть отнесён
predictк положительному классу, даже если значениеpredict_probaменьше 0,5; и аналогично, он может быть отнесён к отрицательному классу, даже если значениеpredict_probaбольше 0,5.
Метод Платта также имеет теоретические проблемы. Если требуются оценки достоверности, но они не должны быть вероятностями, то целесообразно установить probability=False и использовать decision_function вместо predict_proba.
Обратите внимание, что при установке decision_function_shape='ovr' и n_classes > 2, в отличие от decision_function, метод predict по умолчанию не пытается разделить связи. Можно установить break_ties=True для того, чтобы вывод predict был таким же, как np.argmax(clf.decision_function(...), axis=1), в противном случае будет возвращаться первый класс из связанных классов; но имейте в виду, что это сопряжено с вычислительными затратами. Смотрите Пример разрыва связей в SVM для примера разрыва связей.
1.4.1.3. Несбалансированные задачи
В задачах, где требуется уделить большее значение определенным классам или отдельным образцам, можно использовать параметры class_weight и sample_weight.
SVC (но не NuSVC) реализует параметр class_weight в методе fit. Это словарь вида {class_label : value}, где значение — число с плавающей точкой > 0, которое устанавливает параметр C класса class_label в значение C * value. На рисунке ниже показана граница принятия решения для несбалансированной задачи с коррекцией весов и без неё.

SVC, NuSVC, SVR, NuSVR, LinearSVC, LinearSVR и OneClassSVM также реализуют веса для отдельных образцов в методе fit через параметр sample_weight. Аналогично class_weight, это устанавливает параметр C для i-го примера в значение C * sample_weight[i], что стимулирует классификатор правильно распознавать эти образцы. На рисунке ниже показано влияние весов образцов на границу принятия решения. Размер кружков пропорционален весам образцов:

Примеры
1.4.2. Регрессия
Метод поддержки векторной классификации может быть расширен для решения регрессионных задач. Этот метод называется регрессией опорных векторов.
Модель, созданная с помощью классификации опорных векторов (как описано выше), зависит только от подмножества обучающих данных, потому что функция стоимости для построения модели не учитывает обучающие точки, которые лежат за пределами границы. Аналогично, модель, созданная с помощью регрессии опорных векторов, зависит только от подмножества обучающих данных, потому что функция стоимости игнорирует образцы, предсказание которых близко к их целевому значению.
Существует три различных реализации регрессии опорных векторов: SVR, NuSVR и LinearSVR. LinearSVR предоставляет более быструю реализацию, чем SVR, но учитывает только линейное ядро, в то время как NuSVR реализует несколько отличную формулу от SVR и LinearSVR. Благодаря своей реализации в liblinear LinearSVR также регламентирует сдвиг, если он рассматривается. Однако этот эффект можно уменьшить, тщательно настраивая параметр intercept_scaling, который позволяет сдвигу иметь другое поведение регуляризации по сравнению с другими признаками. Результаты классификации и оценка, следовательно, могут отличаться от результатов других двух классификаторов. Подробнее см. Подробные сведения об реализации.
Как и в классах для классификации, метод fit будет принимать в качестве аргументов векторы X, y, только что в этом случае y ожидается иметь значения с плавающей точкой вместо целых чисел:
>>> from sklearn import svm
>>> X = [[0, 0], [2, 2]]
>>> y = [0.5, 2.5]
>>> regr = svm.SVR()
>>> regr.fit(X, y)
SVR()
>>> regr.predict([[1, 1]])
array([1.5])
Примеры
1.4.3. Оценивание плотности, обнаружение новизны
Класс OneClassSVM реализует SVM одного класса, используемый для обнаружения выбросов.
См. Обнаружение новизны и выбросов для описания и использования OneClassSVM.
1.4.4. Сложность
Машины опорных векторов — мощные инструменты, но их вычислительные и требования к памяти быстро возрастают с увеличением числа обучающих векторов. Ядро SVM — это задача квадратичного программирования (QP), разделяющая опорные векторы от остальных обучающих данных. QP-решатель, используемый реализацией на основе libsvm, масштабируется от \(O(n_{features} \times n_{samples}^2)\) до \(O(n_{features} \times n_{samples}^3)\) в зависимости от эффективности использования кеша libsvm на практике (зависит от набора данных). Если данные очень разреженные, \(n_{features}\) следует заменить на среднее число ненулевых признаков в векторе образца.
В линейном случае алгоритм, используемый в LinearSVC с помощью реализации liblinear, намного эффективнее, чем его аналог на основе libsvm SVC и может масштабироваться почти линейно до миллионов образцов и/или признаков.
1.4.5. Советы по практическому применению
-
Избегание копирования данных: Для
SVC,SVR,NuSVCиNuSVR, если данные, переданные в определённые методы, не являются непрерывными в порядке C и двойной точности, они будут скопированы перед вызовом базовой C-реализации. Вы можете проверить, является ли заданный массив NumPy непрерывным в порядке C, просмотрев его атрибутflags.Для
LinearSVC(иLogisticRegression) любой ввод, переданный в виде массива NumPy, будет скопирован и преобразован в внутреннее разреженное представление данных liblinear (числа с плавающей запятой двойной точности и целочисленные индексы 32-битного типа для ненулевых компонент). Если вы хотите обучить линейный классификатор большой размерности без копирования плотного массива NumPy с непрерывными данными двойной точности в порядке C как вход, мы рекомендуем использовать классSGDClassifierвместо этого. Функция цели может быть настроена практически так же, как и для моделиLinearSVC. -
Размер кэша ядра: Для
SVC,SVR,NuSVCиNuSVRразмер кэша ядра оказывает значительное влияние на время выполнения для более сложных задач. Если у вас достаточно оперативной памяти, рекомендуется установитьcache_sizeна более высокое значение, чем значение по умолчанию 200 (МБ), например, 500 (МБ) или 1000 (МБ). -
Настройка C:
Cпо умолчанию имеет значение1, и это разумный выбор по умолчанию. Если у вас много шумных наблюдений, уменьшите его: уменьшение C соответствует большей регуляризации.LinearSVCиLinearSVRменее чувствительны кCпри увеличении значения, и результаты предсказания перестают улучшаться после определённого порога. Одновременно, более большие значенияCпотребуют больше времени на обучение, иногда до 10 раз больше, как показано в [11]. -
Алгоритмы опорных векторных машин не инвариантны к масштабированию, поэтому настоятельно рекомендуется масштабировать ваши данные. Например, масштабируйте каждый атрибут входного вектора X в диапазон [0,1] или [-1,+1], или стандартизируйте его, чтобы среднее значение было равно 0, а дисперсия — 1. Обратите внимание, что одинаковое масштабирование необходимо применить к тестовому вектору, чтобы получить осмысленные результаты. Это можно легко сделать, используя
Pipeline:>>> from sklearn.pipeline import make_pipeline >>> from sklearn.preprocessing import StandardScaler >>> from sklearn.svm import SVC >>> clf = make_pipeline(StandardScaler(), SVC())
Подробнее о масштабировании и нормализации см. раздел Обработка данных.
- Что касается параметра
shrinking, цитируя [12]: Мы обнаружили, что если количество итераций велико, то сжатие может сократить время обучения. Однако, если мы нестрого решаем задачу оптимизации (например, используя большой параметр толерантности остановки), код без использования сжатия может быть значительно быстрее - Параметр
nuвNuSVC/OneClassSVM/NuSVRприближает долю ошибок обучения и опорных векторов. - В
SVC, если данные несбалансированы (например, много положительных и мало отрицательных), установитеclass_weight='balanced'и/или попробуйте различные параметры штрафаC. -
Случайность базовых реализаций: Базовые реализации
SVCиNuSVCиспользуют генератор случайных чисел только для перемешивания данных для оценки вероятности (когдаprobabilityустановлено вTrue). Эта случайность может быть контролирована параметромrandom_state. Еслиprobabilityустановлено вFalse, эти оценки не случайны иrandom_stateне влияет на результаты. Базовая реализацияOneClassSVMаналогична реализациямSVCиNuSVC. Поскольку дляOneClassSVMне предоставляется оценка вероятности, она не случайная.Базовая реализация
LinearSVCиспользует генератор случайных чисел для выбора признаков при обучении модели с помощью двойного спуска по координатам (т.е. когдаdualустановлено вTrue). Поэтому нередко результаты для одних и тех же входных данных могут немного отличаться. Если это происходит, попробуйте уменьшить параметрtol. Эта случайность также может быть контролируема параметромrandom_state. Когдаdualустановлено вFalse, базовая реализацияLinearSVCне случайная, иrandom_stateне оказывает влияния на результаты. - Использование L1-регуляризации, предоставляемой
LinearSVC(penalty='l1',
dual=False)
, приводит к разреженной (sparse) оценке, т. е. только подмножество весов признаков отличается от нуля и вносит вклад в функцию принятия решения. УвеличениеCприводит к более сложной модели (выбирается больше признаков). ЗначениеC, которое приводит к «нулевой» модели (все веса равны нулю), может быть вычислено с помощьюl1_min_c.
1.4.6. Функции ядра
Функция ядра может быть любой из следующих:
- линейная: \(\langle x, x'\rangle\).
- полиномиальная: \((\gamma \langle x, x'\rangle + r)^d\), где \(d\) задаётся параметром
degree, \(r\) — параметромcoef0. - RBF: \(\exp(-\gamma \|x-x'\|^2)\), где \(\gamma\) задаётся параметром
gamma, должно быть больше 0. - сигмоидальная: \(\tanh(\gamma \langle x,x'\rangle + r)\), где \(r\) задаётся параметром
coef0.
Разные ядра задаются параметром kernel:
>>> linear_svc = svm.SVC(kernel='linear')
>>> linear_svc.kernel
'linear'
>>> rbf_svc = svm.SVC(kernel='rbf')
>>> rbf_svc.kernel
'rbf'
См. также Приближение ядер для решения, позволяющего использовать ядра RBF намного быстрее и масштабируемее.
1.4.6.1. Параметры ядра RBF
При обучении SVM с ядром радиальной базисной функции (RBF) необходимо учитывать два параметра: C и gamma. Параметр C, общий для всех ядер SVM, балансирует между ошибками классификации обучающих примеров и простотой разделяющей поверхности. Низкое значение C делает разделяющую поверхность гладкой, а высокое C стремится к правильному классифицированию всех обучающих примеров. gamma определяет степень влияния каждого обучающего примера. Чем больше gamma, тем ближе должны быть другие примеры, чтобы повлиять на него.
Правильный выбор параметров C и gamma имеет решающее значение для производительности SVM. Рекомендуется использовать GridSearchCV с параметрами C и gamma, отстоящими друг от друга в геометрической прогрессии, для выбора хороших значений.
Примеры
1.4.6.2. Пользовательские ядра
Вы можете определить свои собственные ядра, либо передав ядро в виде функции Python, либо предварительно вычислив матрицу Грама.
Классификаторы с пользовательскими ядрами ведут себя так же, как и другие классификаторы, за исключением:
- Поле
support_vectors_теперь пусто, вsupport_хранятся только индексы опорных векторов. - Ссылка (а не копия) первого аргумента в методе
fit()сохраняется для дальнейшего использования. Если этот массив изменится между использованиемfit()иpredict(), вы получите неожиданные результаты.
Использование функций Python в качестве ядер
Вы можете использовать свои собственные ядра, передав функцию в параметр kernel.
Ваше ядро должно принимать в качестве аргументов две матрицы размером (n_samples_1, n_features), (n_samples_2, n_features) и возвращать матрицу ядра размером (n_samples_1, n_samples_2).
Следующий код определяет линейное ядро и создаёт экземпляр классификатора, который будет использовать это ядро:
>>> import numpy as np
>>> from sklearn import svm
>>> def my_kernel(X, Y):
...     return np.dot(X, Y.T)
...
>>> clf = svm.SVC(kernel=my_kernel)
Использование матрицы Грама
Вы можете передать предварительно вычисленные ядра, используя опцию kernel='precomputed'. Затем вы должны передать матрицу Грама вместо X в методы fit и predict. Необходимо предоставить значения ядра между всеми обучающими векторами и тестовыми векторами:
>>> import numpy as np
>>> from sklearn.datasets import make_classification
>>> from sklearn.model_selection import train_test_split
>>> from sklearn import svm
>>> X, y = make_classification(n_samples=10, random_state=0)
>>> X_train , X_test , y_train, y_test = train_test_split(X, y, random_state=0)
>>> clf = svm.SVC(kernel='precomputed')
>>> # linear kernel computation
>>> gram_train = np.dot(X_train, X_train.T)
>>> clf.fit(gram_train, y_train)
SVC(kernel='precomputed')
>>> # predict on training examples
>>> gram_test = np.dot(X_test, X_train.T)
>>> clf.predict(gram_test)
array([0, 1, 0])
Примеры
1.4.7. Математическая формулировка
Машина опорных векторов (Support Vector Machine, SVM) строит гиперплоскость или набор гиперплоскостей в пространстве высокой или бесконечной размерности, которые могут использоваться для классификации, регрессии или других задач. Интуитивно, хорошее разделение достигается гиперплоскостью, имеющей наибольшее расстояние до ближайших обучающих точек любого класса (так называемый функциональный отступ), так как, в общем случае, чем больше отступ, тем ниже обобщающая ошибка классификатора. На рисунке ниже показана функция принятия решения для линейно разделимой задачи, с тремя образцами на границах отступа, называемыми «опорными векторами»:
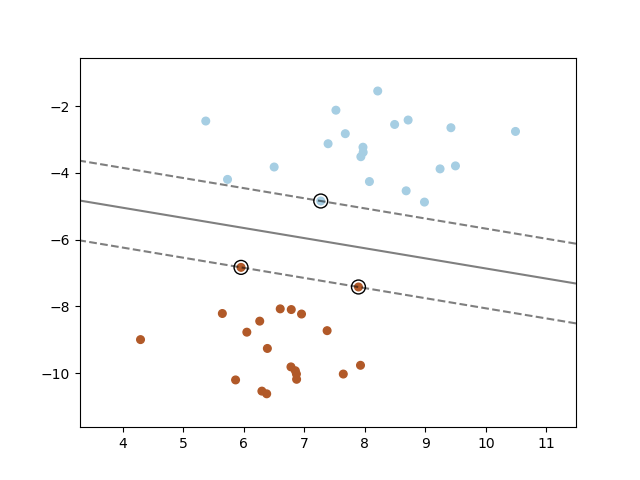
В общем случае, когда задача не является линейно разделимой, опорные векторы — это образцы внутри границ отступа.
Мы рекомендуем [13] и [14] в качестве хороших ссылок по теории и практическому применению SVM.
1.4.7.1. SVC
Даны обучающие векторы \(x_i \in \mathbb{R}^p\), i=1,…, n, в двух классах, и вектор \(y \in \{1, -1\}^n\), наша цель — найти \(w \in \mathbb{R}^p\) и \(b \in \mathbb{R}\) такие, что прогноз, задаваемый \(\text{sign} (w^T\phi(x) + b)\), верен для большинства образцов.
SVC решает следующую исходную задачу:
Интуитивно, мы пытаемся максимизировать отступ (минимизируя \(||w||^2 = w^Tw\)), одновременно внося штраф, когда образец ошибочно классифицирован или находится внутри границы отступа. В идеале, значение \(y_i (w^T \phi (x_i) + b)\) должно быть \(\geq 1\) для всех образцов, что указывает на правильный прогноз. Но проблемы обычно не всегда идеально разделяются гиперплоскостью, поэтому мы допускаем, что некоторые образцы находятся на расстоянии \(\zeta_i\) от их правильной границы отступа. Слагаемое штрафа C управляет силой этого штрафа и, как следствие, выступает в качестве обратного параметра регуляризации (см. примечание ниже).
Сопряжённая задача исходной задачи:
где \(e\) — вектор всех единиц, а \(Q\) — положительно полуопределённая матрица размером \(n\) на \(n\), \(Q_{ij} \equiv y_i y_j K(x_i, x_j)\), где \(K(x_i, x_j) = \phi (x_i)^T \phi (x_j)\) — ядро. Члены \(\alpha_i\) называются двойственными коэффициентами, и они ограничены сверху значением \(C\). Это двойственное представление подчеркивает тот факт, что обучающие векторы неявно отображаются в пространство большей (возможно, бесконечной) размерности функцией \(\phi\): см. трюк с ядром.
После решения задачи оптимизации, результат вызова decision_function для заданного образца \(x\) становится:
и предсказанный класс соответствует его знаку. Нам нужно суммировать только по опорным векторам (т.е. образцам, которые лежат внутри отступа), потому что двойственные коэффициенты \(\alpha_i\) равны нулю для других образцов.
Эти параметры можно получить через атрибуты dual_coef_, который содержит произведение \(y_i \alpha_i\), support_vectors_, который содержит опорные векторы, и intercept_, который содержит свободный член \(b\)
Примечание
В то время как модели SVM, полученные из libsvm и liblinear используют C в качестве параметра регуляризации, большинство других оценок используют alpha. Точное соответствие между степенью регуляризации двух моделей зависит от точного целевого функционала, оптимизируемого моделью. Например, когда используемая оценка — регрессия Ridge, связь между ними задаётся как \(C = \frac{1}{alpha}\).
LinearSVC
Исходная задача может быть эквивалентно сформулирована как
где мы используем функцию потерь с отступом. Это форма, которая непосредственно оптимизируется LinearSVC, но, в отличие от двойственной формы, эта форма не включает внутренние произведения между образцами, поэтому знаменитый трюк с ядром не может быть применён. Именно поэтому LinearSVC поддерживает только линейное ядро (\(\phi\) — тождественная функция).
NuSVC
Формулировка \(\nu\)-SVC [15] является перепараметризацией \(C\)-SVC и, следовательно, математически эквивалентна.
Мы вводим новый параметр \(\nu\) (вместо \(C\)), который управляет количеством опорных векторов и ошибками отступа: \(\nu \in (0, 1]\) является верхней границей доли ошибок отступа и нижней границей доли опорных векторов. Ошибка отступа соответствует образцу, который лежит не на правильной стороне границы отступа: он либо неправильно классифицирован, либо правильно классифицирован, но не лежит за границей отступа.
1.4.7.2. SVR
Даны тренировочные векторы \(x_i \in \mathbb{R}^p\), i=1,…, n, и вектор \(y \in \mathbb{R}^n\) \(\varepsilon\)-SVR решает следующую первоначальную задачу:
Здесь мы штрафуем примеры, предсказание которых отличается от истинного значения по крайней мере на \(\varepsilon\). Эти примеры штрафуют целевую функцию на \(\zeta_i\) или \(\zeta_i^*\), в зависимости от того, находится ли их предсказание выше или ниже \(\varepsilon\)-трубы.
Сопряжённая задача имеет вид
где \(e\) — вектор всех единиц, \(Q\) — положительно полуопределённая матрица размера \(n\) на \(n\), \(Q_{ij} \equiv K(x_i, x_j) = \phi (x_i)^T \phi (x_j)\) — ядро. Здесь тренировочные векторы неявно отображаются в пространство большей (возможно, бесконечной) размерности с помощью функции \(\phi\).
Предсказание имеет вид:
Эти параметры могут быть получены через атрибуты dual_coef_, который содержит разность \(\alpha_i - \alpha_i^*\), support_vectors_, который содержит опорные векторы, и intercept_, который содержит свободный член \(b\)
LinearSVR
Первоначальная задача может быть эквивалентно сформулирована как
где мы используем \(\varepsilon\)-нечувствительную функцию потерь, т.е. ошибки, меньшие чем \(\varepsilon\), игнорируются. Это форма, которая напрямую оптимизируется с помощью LinearSVR.
1.4.8. Детали реализации
Внутренне мы используем libsvm [12] и liblinear [11] для обработки всех вычислений. Эти библиотеки оборачиваются с помощью C и Cython. Для описания реализации и деталей используемых алгоритмов, пожалуйста, обратитесь к соответствующим статьям.
Ссылки
© 2007–2025 The scikit-learn developers
Licensed under the 3-clause BSD License.
https://scikit-learn.org/1.6/modules/svm.html


