2.7. Обнаружение новизны и выбросов
Многие приложения требуют возможности определить, относится ли новая наблюдение к тому же распределению, что и существующие наблюдения (это входящее наблюдение), или оно должно рассматриваться как отличное (это выброс). Часто эта возможность используется для очистки реальных наборов данных. Необходимо сделать два важных различия:
- Обнаружение выбросов:
-
Обучающие данные содержат выбросы, которые определяются как наблюдения, сильно отличающиеся от других. Таким образом, оценки для обнаружения выбросов пытаются подогнать области, где обучающие данные наиболее сконцентрированы, игнорируя отклоняющиеся наблюдения.
- Обнаружение новизны:
-
Обучающие данные не загрязнены выбросами, и нас интересует обнаружение, является ли новое наблюдение выбросом. В этом контексте выброс также называется новизной.
Обнаружение выбросов и обнаружение новизны оба используются для обнаружения аномалий, где нас интересует обнаружение аномальных или необычных наблюдений. Обнаружение выбросов также известно как неконтролируемое обнаружение аномалий, а обнаружение новизны — как полуконтролируемое обнаружение аномалий. В контексте обнаружения выбросов выбросы/аномалии не могут образовывать плотные кластеры, так как доступные оценки предполагают, что выбросы/аномалии расположены в областях с низкой плотностью. Напротив, в контексте обнаружения новизны новые наблюдения/аномалии могут образовывать плотный кластер, пока они находятся в области низкой плотности обучающих данных, считающейся нормальной в этом контексте.
Проект scikit-learn предоставляет набор инструментов машинного обучения, которые могут использоваться как для обнаружения новизны, так и для обнаружения выбросов. Эта стратегия реализуется с объектами, обучающимися без учителя на данных:
estimator.fit(X_train)
Новые наблюдения затем могут быть отсортированы как входящие или выбросы с помощью predict метода:
estimator.predict(X_test)
Входящие наблюдения помечены как 1, а выбросы — как -1. Метод predict использует порог на функции вычисления исходных оценок, вычисляемой оценщиком. К этой функции вычисления оценок можно получить доступ через score_samples метод, в то время как порог можно контролировать с помощью contamination параметра.
decision_function метод также определяется по функции оценки, таким образом, что отрицательные значения являются выбросами, а неотрицательные — входящими наблюдениями:
estimator.decision_function(X_test)
Обратите внимание, что neighbors.LocalOutlierFactor по умолчанию не поддерживает predict, decision_function и score_samples методы, а только fit_predict метод, так как этот оценщик изначально предназначался для обнаружения выбросов. Оценки аномалии обучающих выборок доступны через negative_outlier_factor_ атрибут.
Если вы действительно хотите использовать neighbors.LocalOutlierFactor для обнаружения новизны, то есть предсказать метки или вычислить оценку аномальности новых несформированных данных, вы можете инициализировать оценщик с novelty параметром, установленным в True перед подгонкой оценщика. В этом случае fit_predict недоступен.
Предупреждение
Обнаружение новизны с помощью Local Outlier Factor
Когда novelty установлено в True, имейте в виду, что вы должны использовать только predict, decision_function и score_samples на новых несформированных данных, а не на обучающих образцах, так как это приведёт к неправильным результатам. То есть, результат predict не будет таким же, как fit_predict. Оценки аномальности обучающих выборок всегда доступны через negative_outlier_factor_ атрибут.
Поведение neighbors.LocalOutlierFactor суммируется в следующей таблице.
Метод | Обнаружение выбросов | Обнаружение новизны |
|---|---|---|
| ОК | Недоступно |
| Недоступно | Используйте только на новых данных |
| Недоступно | Используйте только на новых данных |
| Используйте | Используйте только на новых данных |
| ОК | ОК |
2.7.1. Обзор методов обнаружения выбросов
Сравнение алгоритмов обнаружения выбросов в scikit-learn. Local Outlier Factor (LOF) не отображает черную границу решения, так как у него нет метода predict, который можно применить к новым данным, когда он используется для обнаружения выбросов.
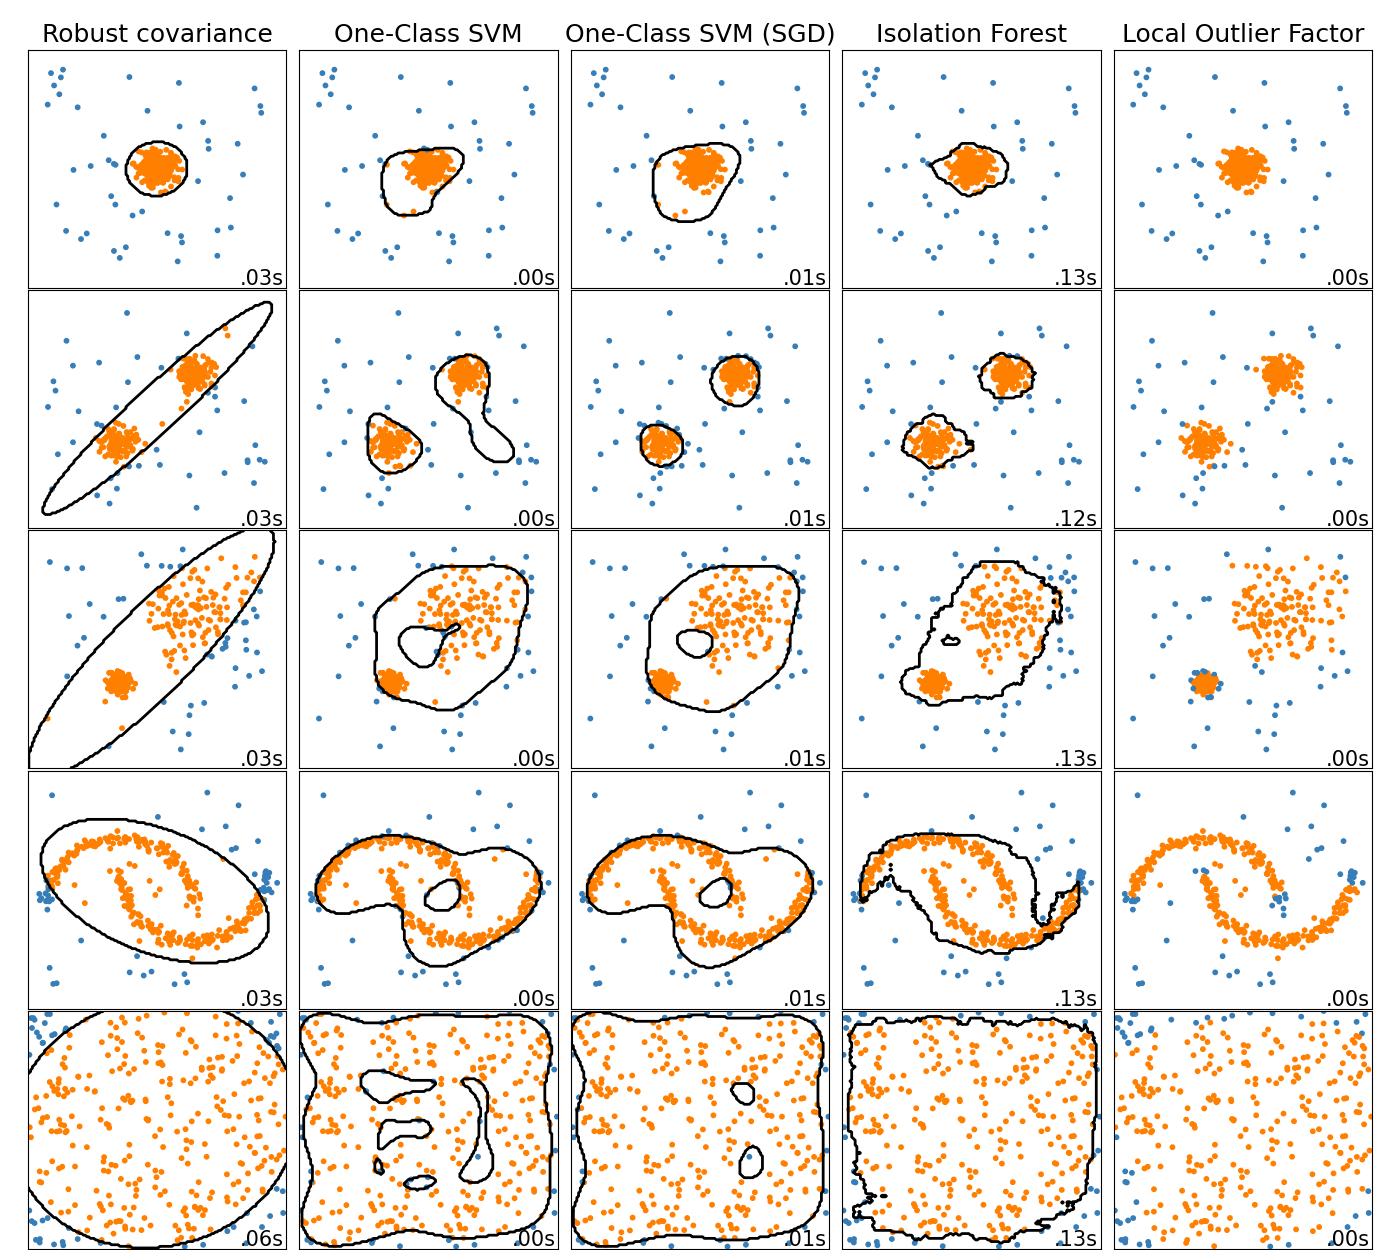
ensemble.IsolationForest и neighbors.LocalOutlierFactor демонстрируют достаточно хорошие результаты на рассматриваемых наборах данных. svm.OneClassSVM известен своей чувствительностью к выбросам и поэтому не демонстрирует очень хороших результатов при обнаружении выбросов. Однако обнаружение выбросов в высоких измерениях или без каких-либо предположений о распределении внутренних данных является очень сложной задачей. svm.OneClassSVM всё же может использоваться для обнаружения выбросов, но требует тонкой настройки гиперпараметра nu для обработки выбросов и предотвращения переобучения. linear_model.SGDOneClassSVM предоставляет реализацию линейного One-Class SVM с линейной сложностью по числу образцов. Здесь эта реализация используется с техникой приближения ядер для получения результатов, аналогичных svm.OneClassSVM, которая по умолчанию использует гауссовское ядро. Наконец, covariance.EllipticEnvelope предполагает, что данные являются гауссовыми, и учится эллипсу. Более подробную информацию о различных оценщиках см. в примере Сравнение алгоритмов обнаружения аномалий для обнаружения выбросов на наборах данных игрушек и разделах ниже.
Примеры
- См. Сравнение алгоритмов обнаружения аномалий для обнаружения выбросов на наборах данных игрушек для сравнения
svm.OneClassSVM,ensemble.IsolationForest,neighbors.LocalOutlierFactorиcovariance.EllipticEnvelope. - См. Оценка оценщиков для обнаружения выбросов для примера, демонстрирующего, как оценить оценщики для обнаружения выбросов,
neighbors.LocalOutlierFactorиensemble.IsolationForest, используя кривые ROC изmetrics.RocCurveDisplay.
2.7.2. Обнаружение новизны
Рассмотрим набор данных из \(n\) наблюдений из одного и того же распределения, описываемого \(p\) признаками. Теперь предположим, что мы добавили ещё одно наблюдение в этот набор данных. Является ли новое наблюдение настолько отличным от других, что можно усомниться в его регулярности? (т.е. происходит ли оно из того же распределения?) Или, наоборот, оно настолько похоже на другие, что его нельзя отличить от исходных наблюдений? Именно этот вопрос решают инструменты и методы обнаружения новизны.
В общем случае речь идёт о вычислении грубой, близкой границы, определяющей контур распределения исходных наблюдений, нарисованных в \(p\)-мерном пространстве вложения. Затем, если последующие наблюдения лежат внутри подпространства, ограниченного границей, они считаются происходящими из той же совокупности, что и исходные наблюдения. В противном случае, если они лежат вне границы, можно сказать, что они являются аномальными с определённой уверенностью в нашей оценке.
Метод опорных векторов с одним классом (One-Class SVM) был предложен Шолькопфом и др. для этой цели и реализован в модуле «Методы опорных векторов» (Support Vector Machines) в объекте Методы опорных векторов в библиотеке svm.OneClassSVM. Он требует выбора ядра и скалярного параметра для определения границы. Обычно выбирается ядро RBF, хотя точной формулы или алгоритма для задания параметра его ширины не существует. Это значение по умолчанию в реализации scikit-learn. Параметр nu, также известный как граница метода One-Class SVM, соответствует вероятности найти новое, но регулярное, наблюдение вне границы.
Литература
- Оценка области определения многомерного распределения Шольkopf, Бернхард и др. Нейронное вычисление 13.7 (2001): 1443-1471.
Примеры
- Посмотрите пример Метод опорных векторов с одним классом с нелинейным ядром (RBF) для визуализации границы, вычисленной вокруг некоторых данных объектом
svm.OneClassSVM. - Моделирование распределения видов

2.7.2.1. Масштабирование метода One-Class SVM
Онлайновая линейная версия метода One-Class SVM реализована в linear_model.SGDOneClassSVM. Эта реализация масштабируется линейно с количеством образцов и может использоваться с приближением ядра для приближённого решения задачи с ядром svm.OneClassSVM, сложность которой в лучшем случае является квадратичной по отношению к числу образцов. Подробнее см. раздел Онлайн метод One-Class SVM.
Примеры
- Посмотрите пример Метод One-Class SVM против One-Class SVM с использованием стохастического градиентного спуска для иллюстрации приближения метода kernelized One-Class SVM с помощью
linear_model.SGDOneClassSVMсовместно с приближением ядра.
2.7.3. Обнаружение выбросов
Обнаружение выбросов аналогично обнаружению новизны в том смысле, что цель состоит в том, чтобы отделить ядро регулярных наблюдений от некоторых загрязнителей, называемых выбросами. Однако в случае обнаружения выбросов у нас нет чистого набора данных, представляющего население регулярных наблюдений, которое можно использовать для обучения любого инструмента.
2.7.3.1. Построение эллиптической оболочки
Один из распространенных способов выполнения обнаружения выбросов заключается в предположении, что регулярные данные поступают из известного распределения (например, данные распределены по Гауссу). Исходя из этого предположения, мы обычно пытаемся определить «форму» данных и можем определить выбросы как наблюдения, которые достаточно сильно отклоняются от формы подгонки.
В scikit-learn представлен объект covariance.EllipticEnvelope, который подгоняет устойчивую оценку ковариации к данным, а следовательно, подгоняет эллипс к центральным точкам данных, игнорируя точки за пределами центрального режима.
Например, предполагая, что данные инлайнеров распределены по Гауссу, он оценит положение и ковариацию инлайнеров надежным способом (то есть без влияния выбросов). Расстояния Махаланобиса, полученные из этой оценки, используются для получения меры выброса. Эта стратегия проиллюстрирована ниже.

Примеры
- См. Устойчивая оценка ковариации и релевантность расстояний Махаланобиса для иллюстрации различий между использованием стандартной (
covariance.EmpiricalCovariance) или устойчивой оценки (covariance.MinCovDet) положения и ковариации для оценки степени выброса наблюдения. - См. Обнаружение выбросов на реальном наборе данных для примера устойчивой оценки ковариации на реальном наборе данных.
Ссылки
- Rousseeuw, P.J., Van Driessen, K. «Быстрый алгоритм для оценки минимальной ковариационной детерминанты» Technometrics 41(3), 212 (1999)
2.7.3.2. Изоляция леса
Один из эффективных способов обнаружения выбросов в наборах данных высокой размерности — использование случайных лесов. ensemble.IsolationForest «изолирует» наблюдения, случайным образом выбирая признак и затем случайным образом выбирая значение разбиения между максимальным и минимальным значениями выбранного признака.
Поскольку рекурсивное разбиение можно представить в виде структуры дерева, количество разбиений, необходимых для изоляции образца, эквивалентно длине пути от корневого узла до узла завершения.
Эта длина пути, усредненная по лесу таких случайных деревьев, является мерой нормальности и нашей функции принятия решений.
Случайное разбиение приводит к заметно более коротким путям для аномалий. Следовательно, когда лес случайных деревьев в совокупности создает более короткие длины пути для определенных образцов, они, скорее всего, являются аномалиями.
Реализация ensemble.IsolationForest основана на ансамбле tree.ExtraTreeRegressor. В соответствии с оригинальной статьей об изоляции леса максимальная глубина каждого дерева устанавливается в \(\lceil \log_2(n) \rceil\), где \(n\) — количество образцов, используемых для построения дерева (подробнее см. (Liu et al., 2008)).
Этот алгоритм проиллюстрирован ниже.

В ensemble.IsolationForest поддерживается warm_start=True, что позволяет добавлять больше деревьев к уже обученной модели:
>>> from sklearn.ensemble import IsolationForest
>>> import numpy as np
>>> X = np.array([[-1, -1], [-2, -1], [-3, -2], [0, 0], [-20, 50], [3, 5]])
>>> clf = IsolationForest(n_estimators=10, warm_start=True)
>>> clf.fit(X)  # fit 10 trees
>>> clf.set_params(n_estimators=20)  # add 10 more trees
>>> clf.fit(X)  # fit the added trees
Примеры
- См. Пример IsolationForest для иллюстрации использования IsolationForest.
- См. Сравнение алгоритмов обнаружения аномалий для обнаружения выбросов на наборах данных для игрушек для сравнения
ensemble.IsolationForestсneighbors.LocalOutlierFactor,svm.OneClassSVM(настроенный для работы как метод обнаружения выбросов),linear_model.SGDOneClassSVMи обнаружения выбросов на основе ковариации сcovariance.EllipticEnvelope.
Ссылки
- Liu, Fei Tony, Ting, Kai Ming and Zhou, Zhi-Hua. «Изоляция леса». Data Mining, 2008. ICDM’08. Восьмая международная конференция IEEE.
2.7.3.3. Локальный фактор выбросов
Еще один эффективный способ обнаружения выбросов в наборах данных со средней высокой размерностью — использование алгоритма Local Outlier Factor (LOF).
Алгоритм neighbors.LocalOutlierFactor (LOF) вычисляет оценку (называемую локальным фактором выбросов), отражающую степень аномальности наблюдений. Он измеряет отклонение локальной плотности заданной точки данных относительно ее соседей. Идея заключается в обнаружении образцов, имеющих существенно более низкую плотность, чем их соседи.
На практике локальная плотность получается из k ближайших соседей. Оценка LOF для наблюдения равна отношению средней локальной плотности k ближайших соседей к собственной локальной плотности: ожидается, что у нормального экземпляра будет локальная плотность, аналогичная плотности его соседей, а у аномальных данных — значительно меньшая локальная плотность.
Число k рассматриваемых соседей (алиас параметр n_neighbors) обычно выбирается 1) больше минимального числа объектов в кластере, чтобы другие объекты могли быть локальными выбросами по отношению к этому кластеру, и 2) меньше максимального числа близлежащих объектов, которые могут потенциально быть локальными выбросами. На практике такая информация, как правило, недоступна, и выбор n_neighbors=20, как правило, работает хорошо. Когда доля выбросов высока (т.е. больше 10 %, как в примере ниже), n_neighbors следует увеличить (n_neighbors=35 в примере ниже).
Сила алгоритма LOF заключается в том, что он учитывает как локальные, так и глобальные свойства наборов данных: он может хорошо работать даже в наборах данных, где аномальные образцы имеют различные основополагающие плотности. Вопрос не в том, насколько изолирован образец, а в том, насколько изолирован он относительно окружающего района.
При применении LOF для обнаружения выбросов нет predict, decision_function и score_samples методов, а только fit_predict метод. Оценки аномальности образцов обучения доступны через атрибут negative_outlier_factor_. Обратите внимание, что predict, decision_function и score_samples могут использоваться для новых несвязанных данных, когда LOF применяется для обнаружения новизны, то есть когда параметр novelty установлен в значение True, но результат predict может отличаться от результата fit_predict. См. Обнаружение новизны с использованием локального фактора выбросов.
Эта стратегия проиллюстрирована ниже.

Примеры
- См. Обнаружение выбросов с помощью локального фактора выбросов (LOF) для иллюстрации использования
neighbors.LocalOutlierFactor. - См. Сравнение алгоритмов обнаружения аномалий для обнаружения выбросов на наборах данных для игрушек для сравнения с другими методами обнаружения аномалий.
Ссылки
- Breunig, Kriegel, Ng, and Sander (2000) LOF: определение локальных выбросов на основе плотности. Proc. ACM SIGMOD
2.7.4. Обнаружение новизны с помощью Local Outlier Factor
Для использования neighbors.LocalOutlierFactor для обнаружения новизны, т. е. для предсказания меток или вычисления оценки аномальности новых, невиданных данных, необходимо инициализировать оценщик с параметром novelty установленным в значение True перед подгонкой оценщика:
lof = LocalOutlierFactor(novelty=True)
lof.fit(X_train)
Обратите внимание, что fit_predict в этом случае недоступно, чтобы избежать несоответствий.
Предупреждение
Обнаружение новизны с помощью Local Outlier Factor`
Когда novelty установлено в значение True, имейте в виду, что вы должны использовать только predict, decision_function и score_samples на новых, невиданных данных, а не на обучающих выборках, так как это приведёт к неправильным результатам. То есть, результат predict не будет таким же, как fit_predict. Оценки аномальности обучающих выборок всегда доступны через атрибут negative_outlier_factor_.
Обнаружение новизны с помощью Local Outlier Factor проиллюстрировано ниже.

© 2007–2025 The scikit-learn developers
Licensed under the 3-clause BSD License.
https://scikit-learn.org/1.6/modules/outlier_detection.html


