NumPy: основные понятия для начинающих
Добро пожаловать в руководство для абсолютных новичков по NumPy! Если у вас есть комментарии или предложения, не стесняйтесь обратиться!
Добро пожаловать в NumPy!
NumPy (Numerical Python) — это открытая библиотека Python, используемая практически во всех областях науки и техники. Это универсальный стандарт для работы с числовыми данными в Python и является основой научных Python-экосистем и PyData. Пользователи NumPy включают в себя всех, от начинающих программистов до опытных исследователей, занимающихся передовыми научными и промышленными исследованиями и разработками. API NumPy широко используется в Pandas, SciPy, Matplotlib, scikit-learn, scikit-image и большинстве других пакетов для науки о данных и научных вычислений на Python.
Библиотека NumPy содержит многомерные массивы и матрицы данных (подробнее об этом вы узнаете в последующих разделах). Она предоставляет ndarray, однородный n-мерный массив с методами для эффективной работы с ним. NumPy может использоваться для выполнения широкого спектра математических операций над массивами. Он добавляет мощные структуры данных в Python, которые гарантируют эффективное выполнение вычислений с массивами и матрицами, а также предоставляет обширную библиотеку высокоуровневых математических функций, работающих с этими массивами и матрицами.
Узнайте больше о NumPy здесь!
Установка NumPy
Для установки NumPy настоятельно рекомендуется использовать научное Python-распределение. Если вы ищете полные инструкции по установке NumPy на вашей операционной системе, вы можете найти все подробности здесь.
Если у вас уже есть Python, вы можете установить NumPy с помощью:
conda install numpy
или
pip install numpy
Если у вас еще нет Python, вы можете рассмотреть возможность использования Anaconda. Это самый простой способ начать работу. Преимущество использования этого дистрибутива в том, что вам не нужно беспокоиться об отдельной установке NumPy или каких-либо основных пакетов, которые вы будете использовать для анализа данных, таких как pandas, Scikit-Learn и т. д.
Вы можете найти все подробности об установке в разделе Установка на сайте SciPy.
Как импортировать NumPy
Чтобы получить доступ к NumPy и его функциям, импортируйте его в свой код Python так:
import numpy as np
Мы сокращаем импортированное имя до np для лучшей читаемости кода, использующего NumPy. Это широко принятая конвенция, которую вы должны соблюдать, чтобы любой, кто работает с вашим кодом, мог легко его понять.
Чтение примера кода
Если вы еще не знакомы с чтением обучающих материалов, содержащих много кода, вам может быть трудно интерпретировать блок кода, который выглядит так:
>>> a = np.arange(6)
>>> a2 = a[np.newaxis, :]
>>> a2.shape
(1, 6)
Если вы не знакомы с этим стилем, его очень легко понять. Если вы видите >>>, вы смотрите на ввод, или код, который вы должны ввести. Всё, что не имеет >>> перед собой, является выводом, или результатами выполнения вашего кода. Это тот стиль, который вы видите при выполнении python в командной строке, но если вы используете IPython, вы можете увидеть другой стиль.
В чем разница между списком Python и массивом NumPy?
NumPy предоставляет вам обширный набор быстрых и эффективных способов создания массивов и манипулирования числовыми данными внутри них. В то время как список Python может содержать различные типы данных в одном списке, все элементы массива NumPy должны быть однородными. Математические операции, которые должны выполняться над массивами, были бы чрезвычайно неэффективными, если бы массивы не были однородными.
Почему использовать NumPy?
Массивы NumPy быстрее и компактнее, чем списки Python. Массив потребляет меньше памяти и удобен в использовании. NumPy использует значительно меньше памяти для хранения данных, и он предоставляет механизм для указания типов данных. Это позволяет еще больше оптимизировать код.
Что такое массив?
Массив — это центральная структура данных библиотеки NumPy. Массив представляет собой сетку значений и содержит информацию о исходных данных, способе поиска элемента и способе интерпретации элемента. Он имеет сетку элементов, которые могут быть индексированы различными способами. Все элементы имеют один и тот же тип, называемый типом массива dtype.
К массиву можно получить доступ по кортежу неотрицательных целых чисел, по булевым значениям, по другому массиву или по целым числам. rank массива — это число измерений. shape массива — это кортеж целых чисел, определяющий размер массива по каждому измерению.
Один из способов инициализации массивов NumPy — из списков Python, используя вложенные списки для двумерных и многомерных данных.
Например:
>>> a = np.array([1, 2, 3, 4, 5, 6])
или:
>>> a = np.array([[1, 2, 3, 4], [5, 6, 7, 8], [9, 10, 11, 12]])
Мы можем получить доступ к элементам массива, используя квадратные скобки. При обращении к элементам помните, что индексация в NumPy начинается с 0. Это означает, что если вы хотите получить доступ к первому элементу массива, вы получите доступ к элементу «0».
>>> print(a[0])
[1 2 3 4]
Дополнительная информация об массивах
В этом разделе рассматриваются 1D array, 2D array, ndarray, vector, matrix
Иногда массив называют «ndarray», что является сокращением от «многомерный массив». Многомерный массив — это просто массив с любым числом измерений. Вы также можете услышать 1-D, или одномерный массив, 2-D, или двумерный массив и так далее. Класс NumPy ndarray используется для представления как матриц, так и векторов. Вектор — это массив с одним измерением (нет разницы между строчными и столбцовыми векторами), а матрица относится к массиву с двумя измерениями. Для 3-D и многомерных массивов также часто используется термин тензор.
Какие атрибуты имеет массив?
Массив обычно представляет собой контейнер фиксированного размера с элементами одного типа и размера. Количество измерений и элементов в массиве определяется его формой. Форма массива — это кортеж неотрицательных целых чисел, которые определяют размеры каждого измерения.
В NumPy измерения называются осями. Это означает, что если у вас есть двумерный массив, который выглядит так:
[[0., 0., 0.],
 [1., 1., 1.]]
У вашего массива есть 2 оси. Первая ось имеет длину 2, а вторая ось — длину 3.
Так же, как и в других объектах-контейнерах Python, содержимое массива можно получить и изменить, индексируя или срезая массив. В отличие от типичных объектов-контейнеров, разные массивы могут совместно использовать одни и те же данные, поэтому изменения, внесенные в один массив, могут быть видны в другом.
Атрибуты массива отражают информацию, присущую самому массиву. Если вам нужно получить или даже установить свойства массива без создания нового массива, вы часто можете получить доступ к массиву через его атрибуты.
Подробнее об атрибутах массива здесь и узнайте о объектах массива здесь.
Как создать базовый массив
В этом разделе рассматриваются np.array(), np.zeros(), np.ones(), np.empty(), np.arange(), np.linspace(), dtype
Для создания массива NumPy можно использовать функцию np.array().
Чтобы создать простой массив, вам нужно всего лишь передать в него список. При желании вы также можете указать тип данных в вашем списке. Дополнительную информацию о типах данных вы найдете здесь.
>>> import numpy as np
>>> a = np.array([1, 2, 3])
Вы можете визуализировать свой массив следующим образом:

Обратите внимание, что эти визуализации предназначены для упрощения идей и предоставления вам базового понимания концепций и механики NumPy. Массивы и операции над массивами намного сложнее, чем показано здесь!
Помимо создания массива из последовательности элементов, вы можете легко создать массив, заполненный 0:
>>> np.zeros(2)
array([0., 0.])
Или массив, заполненный 1:
>>> np.ones(2)
array([1., 1.])
Или даже пустой массив! Функция empty создает массив, начальное содержимое которого является случайным и зависит от состояния памяти. Причина использования empty вместо zeros (или чего-то подобного) — скорость — просто убедитесь, что вы заполните каждый элемент после этого!
>>> # Create an empty array with 2 elements
>>> np.empty(2)
array([ 3.14, 42.  ])  # may vary
Вы можете создать массив с диапазоном элементов:
>>> np.arange(4)
array([0, 1, 2, 3])
И даже массив, содержащий диапазон равномерно распределённых интервалов. Для этого вы укажете первое число, последнее число и шаг.
>>> np.arange(2, 9, 2)
array([2, 4, 6, 8])
Вы также можете использовать np.linspace(), чтобы создать массив со значениями, линейно распределёнными в заданном интервале:
>>> np.linspace(0, 10, num=5)
array([ 0. ,  2.5,  5. ,  7.5, 10. ])
Указание типа данных
Хотя по умолчанию тип данных — это число с плавающей точкой (np.float64), вы можете явно указать нужный тип данных, используя ключевое слово dtype.
>>> x = np.ones(2, dtype=np.int64)
>>> x
array([1, 1])
Узнайте больше о создании массивов здесь
Добавление, удаление и сортировка элементов
В этом разделе рассматриваются np.sort(), np.concatenate()
Сортировка элементов проста с помощью np.sort(). Вы можете указать ось, вид и порядок при вызове функции.
Если вы начинаете с этого массива:
>>> arr = np.array([2, 1, 5, 3, 7, 4, 6, 8])
Вы можете быстро отсортировать числа в порядке возрастания с помощью:
>>> np.sort(arr)
array([1, 2, 3, 4, 5, 6, 7, 8])
В дополнение к sort, которая возвращает отсортированную копию массива, вы можете использовать:
-
argsort, который представляет собой косвенную сортировку по указанной оси, -
lexsort, который представляет собой косвенную устойчивую сортировку по нескольким ключам, -
searchsorted, который найдет элементы в отсортированном массиве, и -
partition, которая представляет собой частичную сортировку.
Чтобы узнать больше о сортировке массива, см.: sort.
Если вы начинаете с этих массивов:
>>> a = np.array([1, 2, 3, 4])
>>> b = np.array([5, 6, 7, 8])
Вы можете объединить их с помощью np.concatenate().
>>> np.concatenate((a, b))
array([1, 2, 3, 4, 5, 6, 7, 8])
Или, если вы начинаете с этих массивов:
>>> x = np.array([[1, 2], [3, 4]])
>>> y = np.array([[5, 6]])
Вы можете объединить их с помощью:
>>> np.concatenate((x, y), axis=0)
array([[1, 2],
       [3, 4],
       [5, 6]])
Для удаления элементов из массива просто используйте индексацию для выбора элементов, которые вы хотите сохранить.
Чтобы узнать больше об объединении, см.: concatenate.
Как узнать форму и размер массива?
Эта секция охватывает ndarray.ndim, ndarray.size, ndarray.shape
ndarray.ndim сообщит вам количество осей или измерений массива.
ndarray.size сообщит вам общее количество элементов массива. Это произведение элементов формы массива.
ndarray.shape отобразит кортеж целых чисел, которые указывают количество элементов, хранящихся вдоль каждого измерения массива. Например, если у вас есть двумерный массив с 2 строками и 3 столбцами, форма вашего массива — (2, 3).
Например, если вы создаете этот массив:
>>> array_example = np.array([[[0, 1, 2, 3],
...                            [4, 5, 6, 7]],
...
...                           [[0, 1, 2, 3],
...                            [4, 5, 6, 7]],
...
...                           [[0 ,1 ,2, 3],
...                            [4, 5, 6, 7]]])
Чтобы найти количество измерений массива, выполните:
>>> array_example.ndim
3
Чтобы найти общее количество элементов в массиве, выполните:
>>> array_example.size
24
И чтобы найти форму вашего массива, выполните:
>>> array_example.shape
(3, 2, 4)
Можно ли изменить форму массива?
Эта секция охватывает arr.reshape()
Да!
Использование arr.reshape() даст новую форму массиву без изменения данных. Просто помните, что при использовании метода reshape массив, который вы хотите получить, должен иметь такое же количество элементов, как и исходный массив. Если вы начинаете с массива из 12 элементов, вам нужно убедиться, что ваш новый массив также имеет в общей сложности 12 элементов.
Если вы начинаете с этого массива:
>>> a = np.arange(6)
>>> print(a)
[0 1 2 3 4 5]
Вы можете использовать reshape() для изменения формы массива. Например, вы можете изменить форму этого массива на массив с тремя строками и двумя столбцами:
>>> b = a.reshape(3, 2)
>>> print(b)
[[0 1]
 [2 3]
 [4 5]]
С помощью np.reshape вы можете указать несколько необязательных параметров:
>>> numpy.reshape(a, newshape=(1, 6), order='C')
array([[0, 1, 2, 3, 4, 5]])
a — массив, который необходимо изменить.
newshape — новая форма, которую вы хотите. Вы можете указать целое число или кортеж целых чисел. Если вы укажете целое число, результат будет массивом такой длины. Форма должна быть совместима с исходной формой.
order: C означает чтение/запись элементов в порядке индексов C, F означает чтение/запись элементов в порядке индексов Fortran, A означает чтение/запись элементов в порядке индексов Fortran, если a сплошной в памяти Fortran, в противном случае в порядке индексов C. (Это необязательный параметр, и его не нужно указывать.)
Если вы хотите узнать больше о порядке C и Fortran, вы можете подробнее о внутренней организации массивов NumPy здесь. По сути, порядок C и Fortran имеет дело с тем, как индексы соответствуют порядку хранения массива в памяти. В Fortran, когда мы проходим по элементам двумерного массива, как он хранится в памяти, первый индекс изменяется быстрее всего. По мере перемещения первого индекса в следующую строку по мере изменения матрица хранится по одному столбцу за раз. Вот почему Fortran считается языком с основным столбцом. В C, наоборот, последний индекс изменяется быстрее всего. Матрица хранится по строкам, делая его языком с основным рядом. Что вы делаете для C или Fortran, зависит от того, что важнее: сохранить соглашение об индексации или не переупорядочивать данные.
Дополнительные сведения об изменении формы здесь.
Как преобразовать одномерный массив в двумерный (как добавить новую ось к массиву)
Эта секция охватывает np.newaxis, np.expand_dims
Вы можете использовать np.newaxis и np.expand_dims для увеличения размерности вашего существующего массива.
Использование np.newaxis увеличит размерность вашего массива на одно измерение при однократном использовании. Это означает, что одномерный массив станет двумерным, двумерный массив станет трехмерным и так далее.
Например, если вы начинаете с этого массива:
>>> a = np.array([1, 2, 3, 4, 5, 6])
>>> a.shape
(6,)
Вы можете использовать np.newaxis для добавления новой оси:
>>> a2 = a[np.newaxis, :]
>>> a2.shape
(1, 6)
Вы можете явно преобразовать одномерный массив в вектор-строку или вектор-столбец, используя np.newaxis. Например, вы можете преобразовать одномерный массив в вектор-строку, вставив ось вдоль первого измерения:
>>> row_vector = a[np.newaxis, :]
>>> row_vector.shape
(1, 6)
Или, для вектора-столбца, вы можете вставить ось вдоль второго измерения:
>>> col_vector = a[:, np.newaxis]
>>> col_vector.shape
(6, 1)
Вы также можете расширить массив, вставив новую ось в заданную позицию с помощью np.expand_dims.
Например, если вы начинаете с этого массива:
>>> a = np.array([1, 2, 3, 4, 5, 6])
>>> a.shape
(6,)
Вы можете использовать np.expand_dims для добавления оси в позиции индекса 1 с помощью:
>>> b = np.expand_dims(a, axis=1)
>>> b.shape
(6, 1)
Вы можете добавить ось в позицию индекса 0 с помощью:
>>> c = np.expand_dims(a, axis=0)
>>> c.shape
(1, 6)
Дополнительную информацию об newaxis здесь и expand_dims можно найти в expand_dims.
Индексация и срезы
Вы можете индексировать и извлекать срезы массивов NumPy так же, как и срезы списков Python.
>>> data = np.array([1, 2, 3])

>>> data[1]
2
>>> data[0:2]
array([1, 2])
>>> data[1:]
array([2, 3])
>>> data[-2:]
array([2, 3])
Вы можете представить это так:
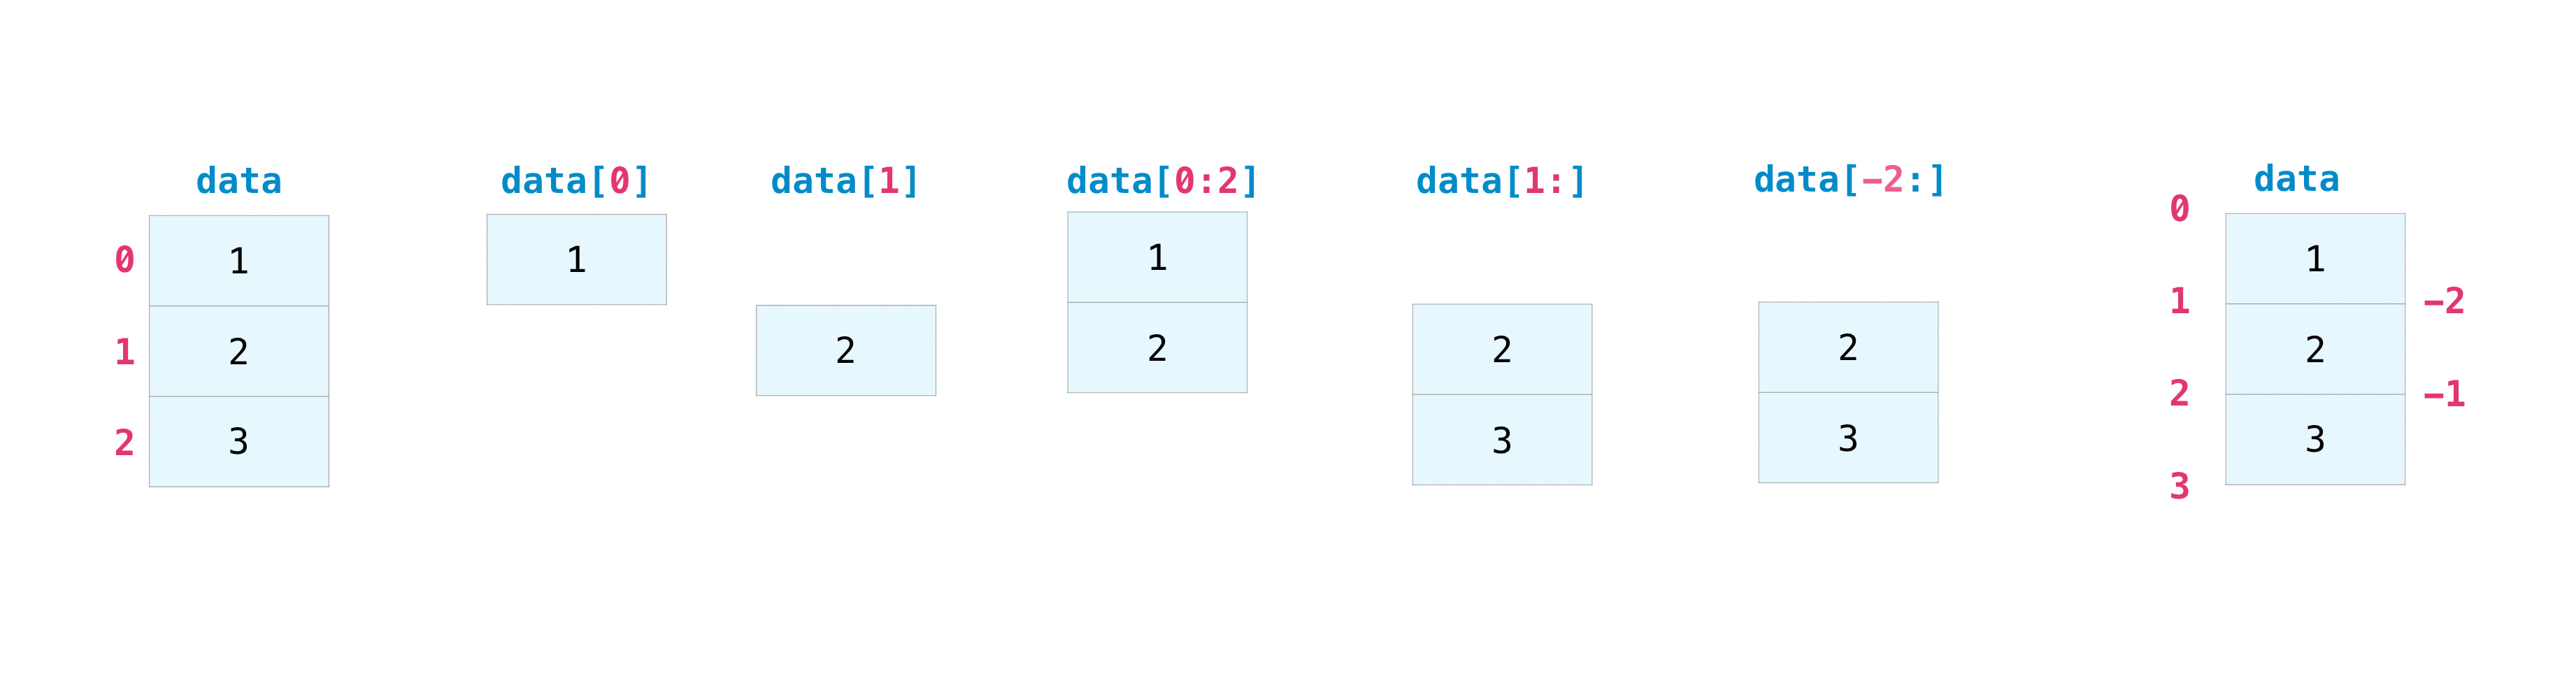
Возможно, вам понадобится выбрать часть вашего массива или определенные элементы массива для использования в дальнейшей аналитике или дополнительных операциях. Для этого вам нужно будет выполнить подмножество, извлечь срез и/или индексировать ваши массивы.
Если вам нужно выбрать значения из вашего массива, которые удовлетворяют определенным условиям, это просто с NumPy.
Например, если вы начинаете с этого массива:
>>> a = np.array([[1 , 2, 3, 4], [5, 6, 7, 8], [9, 10, 11, 12]])
Вы можете легко вывести все значения в массиве, которые меньше 5.
>>> print(a[a < 5])
[1 2 3 4]
Вы также можете выбрать, например, числа, которые равны или больше 5, и использовать это условие для индексации массива.
>>> five_up = (a >= 5)
>>> print(a[five_up])
[ 5  6  7  8  9 10 11 12]
Вы можете выбрать элементы, делящиеся на 2:
>>> divisible_by_2 = a[a%2==0]
>>> print(divisible_by_2)
[ 2  4  6  8 10 12]
Или вы можете выбрать элементы, удовлетворяющие двум условиям, используя операторы & и |:
>>> c = a[(a > 2) & (a < 11)]
>>> print(c)
[ 3  4  5  6  7  8  9 10]
Вы также можете использовать логические операторы & и |, чтобы вернуть булевы значения, которые указывают, удовлетворяют ли значения в массиве определенному условию. Это может быть полезно с массивами, которые содержат имена или другие категориальные значения.
>>> five_up = (a > 5) | (a == 5)
>>> print(five_up)
[[False False False False]
 [ True  True  True  True]
 [ True  True  True True]]
Вы также можете использовать np.nonzero() для выбора элементов или индексов из массива.
Начиная с этого массива:
>>> a = np.array([[1, 2, 3, 4], [5, 6, 7, 8], [9, 10, 11, 12]])
Вы можете использовать np.nonzero() для вывода индексов элементов, которые, например, меньше 5:
>>> b = np.nonzero(a < 5)
>>> print(b)
(array([0, 0, 0, 0]), array([0, 1, 2, 3]))
В этом примере возвращается кортеж массивов: по одному для каждого измерения. Первый массив представляет индексы строк, где эти значения найдены, а второй массив представляет индексы столбцов, где значения найдены.
Если вы хотите сгенерировать список координат, где существуют элементы, вы можете использовать zip для массивов, перебирать список координат и выводить их. Например:
>>> list_of_coordinates= list(zip(b[0], b[1]))

>>> for coord in list_of_coordinates:
...     print(coord)
(0, 0)
(0, 1)
(0, 2)
(0, 3)
Вы также можете использовать np.nonzero() для вывода элементов в массиве, которые меньше 5 с помощью:
>>> print(a[b])
[1 2 3 4]
Если искомый элемент не существует в массиве, возвращаемый массив индексов будет пустым. Например:
>>> not_there = np.nonzero(a == 42)
>>> print(not_there)
(array([], dtype=int64), array([], dtype=int64))
Дополнительную информацию об индексации и срезах можно найти здесь здесь и здесь.
Дополнительную информацию о функции nonzero можно найти по адресу: nonzero.
Как создать массив из существующих данных
Эта секция охватывает slicing and indexing, np.vstack(), np.hstack(), np.hsplit(), .view(), copy()
Вы можете легко использовать создать новый массив из части существующего массива.
Предположим, у вас есть этот массив:
>>> a = np.array([1, 2, 3, 4, 5, 6, 7, 8, 9, 10])
Вы можете создать новый массив из части массива в любое время, указав, где вы хотите извлечь срез массива.
>>> arr1 = a[3:8]
>>> arr1
array([4, 5, 6, 7, 8])
Здесь вы взяли часть массива с позиции индекса 3 до позиции индекса 8.
Вы также можете объединить два существующих массива как вертикально, так и горизонтально. Предположим, у вас есть два массива, a1 и a2:
>>> a1 = np.array([[1, 1],
...                [2, 2]])

>>> a2 = np.array([[3, 3],
...                [4, 4]])
Вы можете объединить их вертикально с помощью vstack:
>>> np.vstack((a1, a2))
array([[1, 1],
       [2, 2],
       [3, 3],
       [4, 4]])
Или объединить их горизонтально с помощью hstack:
>>> np.hstack((a1, a2))
array([[1, 1, 3, 3],
       [2, 2, 4, 4]])
Вы можете разделить массив на несколько меньших массивов, используя hsplit. Вы можете указать либо количество массивов с одинаковой формой для возврата, либо столбцы после которых должно произойти разделение.
Предположим, у вас есть этот массив:
>>> x = np.arange(1, 25).reshape(2, 12)
>>> x
array([[ 1,  2,  3,  4,  5,  6,  7,  8,  9, 10, 11, 12],
       [13, 14, 15, 16, 17, 18, 19, 20, 21, 22, 23, 24]])
Если вы хотите разделить этот массив на три массива с одинаковой формой, вы выполните:
>>> np.hsplit(x, 3)
[array([[1,  2,  3,  4],
        [13, 14, 15, 16]]), array([[ 5,  6,  7,  8],
        [17, 18, 19, 20]]), array([[ 9, 10, 11, 12],
        [21, 22, 23, 24]])]
Если вы хотите разделить массив после третьего и четвертого столбца, вы выполните:
>>> np.hsplit(x, (3, 4))
[array([[1, 2, 3],
        [13, 14, 15]]), array([[ 4],
        [16]]), array([[ 5, 6, 7, 8, 9, 10, 11, 12],
        [17, 18, 19, 20, 21, 22, 23, 24]])]
END_OF_DOCUMENT_MARKER Узнайте больше о стекировании и разделении массивов здесь.
Вы можете использовать метод view, чтобы создать новый объект массива, который смотрит на те же данные, что и исходный массив (неглубокая копия).
Представления — важная концепция NumPy! Функции NumPy, а также операции, такие как индексирование и срезы, будут возвращать представления всякий раз, когда это возможно. Это экономит память и быстрее (не нужно создавать копию данных). Однако важно помнить об этом — изменение данных в представлении также изменяет исходный массив!
Предположим, вы создали этот массив:
>>> a = np.array([[1, 2, 3, 4], [5, 6, 7, 8], [9, 10, 11, 12]])
Теперь мы создаём массив b1, используя срез a, и изменяем первый элемент b1. Это изменит соответствующий элемент в a тоже!
>>> b1 = a[0, :]
>>> b1
array([1, 2, 3, 4])
>>> b1[0] = 99
>>> b1
array([99,  2,  3,  4])
>>> a
array([[99,  2,  3,  4],
       [ 5,  6,  7,  8],
       [ 9, 10, 11, 12]])
Использование метода copy создаст полную копию массива и его данных (глубокая копия). Чтобы использовать это на вашем массиве, вы могли бы запустить:
>>> b2 = a.copy()
Узнайте больше о копиях и представлениях здесь.
Основные операции с массивами
В этом разделе рассматриваются сложение, вычитание, умножение, деление и многое другое
После создания массивов вы можете начать работать с ними. Например, предположим, что вы создали два массива, один под названием «data», а другой — «ones»

Вы можете складывать массивы с помощью знака плюс.
>>> data = np.array([1, 2])
>>> ones = np.ones(2, dtype=int)
>>> data + ones
array([2, 3])

Конечно, вы можете делать больше, чем просто сложение!
>>> data - ones
array([0, 1])
>>> data * data
array([1, 4])
>>> data / data
array([1., 1.])

Основные операции просты с NumPy. Если вы хотите найти сумму элементов в массиве, вы можете использовать sum(). Это работает для одномерных массивов, двумерных массивов и массивов более высоких размерностей.
>>> a = np.array([1, 2, 3, 4])

>>> a.sum()
10
Чтобы сложить строки или столбцы в двумерном массиве, вы должны указать ось.
Если вы начинаете с этого массива:
>>> b = np.array([[1, 1], [2, 2]])
Вы можете просуммировать по оси строк с помощью:
>>> b.sum(axis=0)
array([3, 3])
Вы можете просуммировать по оси столбцов с помощью:
>>> b.sum(axis=1)
array([2, 4])
Узнайте больше об основных операциях здесь.
Вещание
Иногда вам может потребоваться выполнить операцию между массивом и одним числом (также называемая операцией между вектором и скаляром) или между массивами двух разных размеров. Например, ваш массив (назовём его «data») может содержать информацию о расстоянии в милях, но вы хотите преобразовать её в километры. Вы можете выполнить эту операцию с помощью:
>>> data = np.array([1.0, 2.0])
>>> data * 1.6
array([1.6, 3.2])

NumPy понимает, что умножение должно происходить с каждой ячейкой. Это понятие называется вещанием. Вещание — это механизм, позволяющий NumPy выполнять операции над массивами с разными формами. Размеры вашего массива должны быть совместимы, например, когда размеры обоих массивов равны или когда один из них равен 1. Если размеры несовместимы, вы получите ValueError.
Узнайте больше о вещании здесь.
Более полезные операции с массивами
В этом разделе рассматриваются максимальное, минимальное, суммарное, среднее, произведение, стандартное отклонение и многое другое
NumPy также выполняет агрегационные функции. В дополнение к min, max и sum, вы можете легко вычислить mean, чтобы получить среднее значение, prod, чтобы получить результат умножения элементов, std, чтобы получить стандартное отклонение, и многое другое.
>>> data.max()
2.0
>>> data.min()
1.0
>>> data.sum()
3.0

Начнём с этого массива, названного «a»
>>> a = np.array([[0.45053314, 0.17296777, 0.34376245, 0.5510652],
...               [0.54627315, 0.05093587, 0.40067661, 0.55645993],
...               [0.12697628, 0.82485143, 0.26590556, 0.56917101]])
Часто требуется агрегирование по строке или столбцу. По умолчанию каждая агрегационная функция NumPy возвращает агрегат всего массива. Чтобы найти сумму или минимум элементов в вашем массиве, выполните:
>>> a.sum()
4.8595784
Или:
>>> a.min()
0.05093587
Вы можете указать, по какой оси вы хотите вычислить агрегационную функцию. Например, вы можете найти минимальное значение в каждом столбце, указав axis=0.
>>> a.min(axis=0)
array([0.12697628, 0.05093587, 0.26590556, 0.5510652 ])
Четыре значения выше соответствуют количеству столбцов в вашем массиве. В массиве с четырьмя столбцами вы получите четыре значения в качестве результата.
Узнайте больше об методах массивов здесь.
Создание матриц
Вы можете передать списки Python с списками, чтобы создать двумерный массив (или «матрицу»), чтобы представить их в NumPy.
>>> data = np.array([[1, 2], [3, 4], [5, 6]])
>>> data
array([[1, 2],
       [3, 4],
       [5, 6]])

Операции индексирования и срезов полезны при манипулировании матрицами:
>>> data[0, 1]
2
>>> data[1:3]
array([[3, 4],
       [5, 6]])
>>> data[0:2, 0]
array([1, 3])

Вы можете агрегировать матрицы так же, как и векторы:
>>> data.max()
6
>>> data.min()
1
>>> data.sum()
21

Вы можете агрегировать все значения в матрице и можете агрегировать их по столбцам или строкам с помощью параметра axis:
>>> data.max(axis=0)
array([5, 6])
>>> data.max(axis=1)
array([2, 4, 6])

После создания матриц вы можете складывать и умножать их с помощью арифметических операторов, если у вас две матрицы одного размера.
>>> data = np.array([[1, 2], [3, 4]])
>>> ones = np.array([[1, 1], [1, 1]])
>>> data + ones
array([[2, 3],
       [4, 5]])

Вы можете выполнять эти арифметические операции над матрицами разных размеров, но только если одна из матриц имеет только один столбец или одну строку. В этом случае NumPy будет использовать свои правила вещания для операции.
>>> data = np.array([[1, 2], [3, 4], [5, 6]])
>>> ones_row = np.array([[1, 1]])
>>> data + ones_row
array([[2, 3],
       [4, 5],
       [6, 7]])

Обратите внимание, что при выводе N-мерных массивов NumPy последний осевой индекс перебирается быстрее всего, а первый — медленнее всего. Например:
>>> np.ones((4, 3, 2))
array([[[1., 1.],
        [1., 1.],
        [1., 1.]],

       [[1., 1.],
        [1., 1.],
        [1., 1.]],

       [[1., 1.],
        [1., 1.],
        [1., 1.]],

       [[1., 1.],
        [1., 1.],
        [1., 1.]]])
Часто бывают случаи, когда нам нужно, чтобы NumPy инициализировал значения массива. NumPy предлагает функции, такие как ones() и zeros(), и класс random.Generator для генерации случайных чисел для этого. Вам нужно только указать количество элементов, которые вы хотите сгенерировать:
>>> np.ones(3)
array([1., 1., 1.])
>>> np.zeros(3)
array([0., 0., 0.])
# the simplest way to generate random numbers
>>> rng = np.random.default_rng(0)
>>> rng.random(3)
array([0.63696169, 0.26978671, 0.04097352])

Вы также можете использовать ones(), zeros() и random(), чтобы создать двумерный массив, если вы передадите кортеж, описывающий размер матрицы:
>>> np.ones((3, 2))
array([[1., 1.],
       [1., 1.],
       [1., 1.]])
>>> np.zeros((3, 2))
array([[0., 0.],
       [0., 0.],
       [0., 0.]])
>>> rng.random((3, 2))
array([[0.01652764, 0.81327024],
       [0.91275558, 0.60663578],
       [0.72949656, 0.54362499]])  # may vary

Узнайте больше о создании массивов, заполненных 0, 1, другими значениями или неинициализированными, на странице процедуры создания массивов.
Генерация случайных чисел
Генерация случайных чисел — важная часть настройки и оценки многих численных и машинных алгоритмов обучения. Независимо от того, нужно ли вам случайным образом инициализировать веса в искусственной нейронной сети, разбить данные на случайные наборы или случайным образом перемешать свой набор данных, способность генерировать случайные числа (на самом деле повторяющиеся псевдослучайные числа) является необходимой.
С помощью Generator.integers вы можете генерировать случайные целые числа от низкого (помните, что это включительно в NumPy) до высокого (исключительно). Вы можете установить endpoint=True, чтобы сделать высокое число включительно.
Вы можете сгенерировать массив 2x4 случайных целых чисел от 0 до 4 с помощью:
>>> rng.integers(5, size=(2, 4))
array([[2, 1, 1, 0],
       [0, 0, 0, 4]])  # may vary
Узнайте больше о генерации случайных чисел здесь.
Как получить уникальные элементы и их количество
В этом разделе рассматривается np.unique()
Вы можете легко найти уникальные элементы в массиве с помощью np.unique.
Например, если вы начинаете с этого массива:
>>> a = np.array([11, 11, 12, 13, 14, 15, 16, 17, 12, 13, 11, 14, 18, 19, 20])
вы можете использовать np.unique, чтобы вывести уникальные значения в вашем массиве:
>>> unique_values = np.unique(a)
>>> print(unique_values)
[11 12 13 14 15 16 17 18 19 20]
Чтобы получить индексы уникальных значений в массиве NumPy (массив первых позиций индексов уникальных значений в массиве), просто передайте аргумент return_index в np.unique() вместе с вашим массивом.
>>> unique_values, indices_list = np.unique(a, return_index=True)
>>> print(indices_list)
[ 0  2  3  4  5  6  7 12 13 14]
Вы можете передать аргумент return_counts в np.unique() вместе с вашим массивом, чтобы получить количество повторений уникальных значений в массиве NumPy.
>>> unique_values, occurrence_count = np.unique(a, return_counts=True)
>>> print(occurrence_count)
[3 2 2 2 1 1 1 1 1 1]
Это также работает с двумерными массивами! Если вы начинаете с этого массива:
>>> a_2d = np.array([[1, 2, 3, 4], [5, 6, 7, 8], [9, 10, 11, 12], [1, 2, 3, 4]])
Вы можете найти уникальные значения с помощью:
>>> unique_values = np.unique(a_2d)
>>> print(unique_values)
[ 1  2  3  4  5  6  7  8  9 10 11 12]
Если аргумент axis не указан, ваш двумерный массив будет сжат.
Если вы хотите получить уникальные строки или столбцы, обязательно передайте аргумент axis. Чтобы найти уникальные строки, укажите axis=0, а для столбцов — axis=1.
>>> unique_rows = np.unique(a_2d, axis=0)
>>> print(unique_rows)
[[ 1  2  3  4]
 [ 5  6  7  8]
 [ 9 10 11 12]]
Чтобы получить уникальные строки, их позиции и количество повторений, вы можете использовать:
>>> unique_rows, indices, occurrence_count = np.unique(
...      a_2d, axis=0, return_counts=True, return_index=True)
>>> print(unique_rows)
[[ 1  2  3  4]
 [ 5  6  7  8]
 [ 9 10 11 12]]
>>> print(indices)
[0 1 2]
>>> print(occurrence_count)
[2 1 1]
Чтобы узнать больше о поиске уникальных элементов в массиве, см. unique.
Транспонирование и изменение формы матрицы
В этом разделе рассматриваются arr.reshape(), arr.transpose(), arr.T
Часто требуется транспонировать матрицы. Массивы NumPy обладают свойством T, которое позволяет транспонировать матрицу.

Вам также может потребоваться изменить размерности матрицы. Это может произойти, например, когда у вас есть модель, которая ожидает определённой формы входных данных, отличной от вашего набора данных. Именно здесь может быть полезен метод reshape. Вам просто нужно передать новые размерности, которые вы хотите для матрицы.
>>> data.reshape(2, 3)
array([[1, 2, 3],
       [4, 5, 6]])
>>> data.reshape(3, 2)
array([[1, 2],
       [3, 4],
       [5, 6]])

Вы также можете использовать .transpose(), чтобы инвертировать или изменить оси массива в соответствии с указанными значениями.
Если вы начинаете с этого массива:
>>> arr = np.arange(6).reshape((2, 3))
>>> arr
array([[0, 1, 2],
       [3, 4, 5]])
Вы можете транспонировать свой массив с помощью arr.transpose().
>>> arr.transpose()
array([[0, 3],
       [1, 4],
       [2, 5]])
Вы также можете использовать arr.T:
>>> arr.T
array([[0, 3],
       [1, 4],
       [2, 5]])
Чтобы узнать больше о транспонировании и изменении формы массивов, см. transpose и reshape.
Как перевернуть массив
В этом разделе рассматривается np.flip()
Функция NumPy np.flip() позволяет переворачивать, или изменять порядок, содержимого массива вдоль оси. При использовании np.flip(), укажите массив, который вы хотите перевернуть, и ось. Если вы не укажете ось, NumPy перевернёт содержимое по всем осям вашего входного массива.
Переворачивание массива 1D
Если вы начинаете с массива 1D, такого как этот:
>>> arr = np.array([1, 2, 3, 4, 5, 6, 7, 8])
Вы можете перевернуть его с помощью:
>>> reversed_arr = np.flip(arr)
Если вы хотите вывести свой перевернутый массив, вы можете выполнить:
>>> print('Reversed Array: ', reversed_arr)
Reversed Array:  [8 7 6 5 4 3 2 1]
Переворачивание массива 2D
Массив 2D работает аналогично.
Если вы начинаете с этого массива:
>>> arr_2d = np.array([[1, 2, 3, 4], [5, 6, 7, 8], [9, 10, 11, 12]])
Вы можете перевернуть содержимое по всем строкам и всем столбцам с помощью:
>>> reversed_arr = np.flip(arr_2d)
>>> print(reversed_arr)
[[12 11 10  9]
 [ 8  7  6  5]
 [ 4  3  2  1]]
Вы можете легко перевернуть только строки с помощью:
>>> reversed_arr_rows = np.flip(arr_2d, axis=0)
>>> print(reversed_arr_rows)
[[ 9 10 11 12]
 [ 5  6  7  8]
 [ 1  2  3  4]]
Или перевернуть только столбцы с помощью:
>>> reversed_arr_columns = np.flip(arr_2d, axis=1)
>>> print(reversed_arr_columns)
[[ 4  3  2  1]
 [ 8  7  6  5]
 [12 11 10  9]]
Вы также можете перевернуть содержимое только одного столбца или строки. Например, вы можете перевернуть содержимое строки с индексом 1 (вторая строка):
>>> arr_2d[1] = np.flip(arr_2d[1])
>>> print(arr_2d)
[[ 1  2  3  4]
 [ 8  7  6  5]
 [ 9 10 11 12]]
Вы также можете перевернуть столбец с индексом 1 (второй столбец):
>>> arr_2d[:,1] = np.flip(arr_2d[:,1])
>>> print(arr_2d)
[[ 1 10  3  4]
 [ 8  7  6  5]
 [ 9  2 11 12]]
Узнайте больше о переворачивании массивов на странице flip.
Изменение формы и уплощение многомерных массивов
Эта секция охватывает .flatten(), ravel()
Существует два популярных способа уплощения массива: .flatten() и .ravel(). Основное различие между ними заключается в том, что новый массив, созданный с помощью ravel(), фактически является ссылкой на родительский массив (т.е. «вид»). Это означает, что любые изменения в новом массиве повлияют и на родительский массив. Поскольку ravel не создаёт копию, он экономит память.
Если вы начинаете с этого массива:
>>> x = np.array([[1 , 2, 3, 4], [5, 6, 7, 8], [9, 10, 11, 12]])
Вы можете использовать flatten для уплощения массива в массив 1D.
>>> x.flatten()
array([ 1,  2,  3,  4,  5,  6,  7,  8,  9, 10, 11, 12])
Когда вы используете flatten, изменения в вашем новом массиве не изменят родительский массив.
Например:
>>> a1 = x.flatten()
>>> a1[0] = 99
>>> print(x)  # Original array
[[ 1  2  3  4]
 [ 5  6  7  8]
 [ 9 10 11 12]]
>>> print(a1)  # New array
[99  2  3  4  5  6  7  8  9 10 11 12]
Но когда вы используете ravel, изменения, которые вы вносите в новый массив, повлияют на родительский массив.
Например:
>>> a2 = x.ravel()
>>> a2[0] = 98
>>> print(x)  # Original array
[[98  2  3  4]
 [ 5  6  7  8]
 [ 9 10 11 12]]
>>> print(a2)  # New array
[98  2  3  4  5  6  7  8  9 10 11 12]
Узнайте больше о flatten на странице ndarray.flatten и ravel на странице ravel.
Как получить доступ к строке документации для получения дополнительной информации
Эта секция охватывает help(), ?, ??
В экосистеме науки о данных Python и NumPy созданы с учётом пользователя. Одним из лучших примеров этого является встроенный доступ к документации. Каждый объект содержит ссылку на строку, которая известна как строка документации. В большинстве случаев эта строка документации содержит краткое описание объекта и способ его использования. Python имеет встроенную функцию help(), которая может помочь вам получить доступ к этой информации. Это означает, что практически каждый раз, когда вам нужна дополнительная информация, вы можете использовать help(), чтобы быстро найти необходимую информацию.
Например:
>>> help(max)
Help on built-in function max in module builtins:

max(...)
    max(iterable, *[, default=obj, key=func]) -> value
    max(arg1, arg2, *args, *[, key=func]) -> value

    With a single iterable argument, return its biggest item. The
    default keyword-only argument specifies an object to return if
    the provided iterable is empty.
    With two or more arguments, return the largest argument.
Поскольку доступ к дополнительной информации очень полезен, IPython использует символ ? в качестве сокращения для доступа к этой документации и другой релевантной информации. IPython — это командная оболочка для интерактивного вычисления на нескольких языках. Вы можете найти больше информации об IPython здесь.
Например:
In [0]: max?
max(iterable, *[, default=obj, key=func]) -> value
max(arg1, arg2, *args, *[, key=func]) -> value

With a single iterable argument, return its biggest item. The
default keyword-only argument specifies an object to return if
the provided iterable is empty.
With two or more arguments, return the largest argument.
Type:      builtin_function_or_method
Вы даже можете использовать эту нотацию для методов объекта и самих объектов.
Предположим, вы создаёте этот массив:
>>> a = np.array([1, 2, 3, 4, 5, 6])
Затем вы можете получить много полезной информации (сначала подробности о a, а затем строку документации для ndarray, экземпляром которого является a):
In [1]: a?
Type:            ndarray
String form:     [1 2 3 4 5 6]
Length:          6
File:            ~/anaconda3/lib/python3.7/site-packages/numpy/__init__.py
Docstring:       <no docstring>
Class docstring:
ndarray(shape, dtype=float, buffer=None, offset=0,
        strides=None, order=None)

An array object represents a multidimensional, homogeneous array
of fixed-size items.  An associated data-type object describes the
format of each element in the array (its byte-order, how many bytes it
occupies in memory, whether it is an integer, a floating point number,
or something else, etc.)

Arrays should be constructed using `array`, `zeros` or `empty` (refer
to the See Also section below).  The parameters given here refer to
a low-level method (`ndarray(...)`) for instantiating an array.

For more information, refer to the `numpy` module and examine the
methods and attributes of an array.

Parameters
----------
(for the __new__ method; see Notes below)

shape : tuple of ints
        Shape of created array.
...
Это также работает для функций и других объектов, которые вы создаёте. Просто помните, что необходимо включать строку документации в вашу функцию, используя строковый литерал (""" """ или ''' ''') вокруг вашей документации.
Например, если вы создаёте эту функцию:
>>> def double(a):
...   '''Return a * 2'''
...   return a * 2
Вы можете получить информацию о функции:
In [2]: double?
Signature: double(a)
Docstring: Return a * 2
File:      ~/Desktop/<ipython-input-23-b5adf20be596>
Type:      function
Вы можете получить ещё больше информации, прочитав исходный код интересующего вас объекта. Использование двойного вопросительного знака (??) позволит вам получить доступ к исходному коду.
Например:
In [3]: double??
Signature: double(a)
Source:
def double(a):
    '''Return a * 2'''
    return a * 2
File:      ~/Desktop/<ipython-input-23-b5adf20be596>
Type:      function
Если интересующий объект скомпилирован на языке, отличном от Python, использование ?? вернёт ту же информацию, что и ?. Вы найдёте это с многими встроенными объектами и типами, например:
In [4]: len?
Signature: len(obj, /)
Docstring: Return the number of items in a container.
Type:      builtin_function_or_method
и:
In [5]: len??
Signature: len(obj, /)
Docstring: Return the number of items in a container.
Type:      builtin_function_or_method
имеют одинаковый вывод, потому что они были скомпилированы на языке программирования, отличном от Python.
Работа с математическими формулами
Простота реализации математических формул, работающих с массивами, — одна из причин, по которой NumPy так широко используется в сообществе научного Python.
Например, это формула средней квадратичной ошибки (центральная формула, используемая в моделях машинного обучения с учителем, которые занимаются регрессией):

Реализация этой формулы в NumPy проста и понятна:

Что делает это эффективным, так это то, что predictions и labels могут содержать одну или тысячу значений. Они только должны быть одинакового размера.
Вы можете представить это так:

В этом примере векторы прогнозов и меток содержат по три значения, что означает, что n имеет значение три. После выполнения вычитаний значения в векторе возводятся в квадрат. Затем NumPy суммирует значения, и ваш результат — это значение ошибки для данного прогноза и оценка качества модели.


Как сохранять и загружать объекты NumPy
Эта секция охватывает np.save, np.savez, np.savetxt, np.load, np.loadtxt
В какой-то момент вам захочется сохранить свои массивы на диск и загрузить их обратно, не выполняя код заново. К счастью, существует несколько способов сохранения и загрузки объектов с помощью NumPy. Объекты ndarray можно сохранять и загружать из файлов на диске с помощью функций loadtxt и savetxt, которые обрабатывают обычные текстовые файлы, функций load и save, которые обрабатывают двоичные файлы NumPy с расширением .npy, и функцией savez, которая обрабатывает файлы NumPy с расширением .npz.
Файлы .npy и .npz хранят данные, форму, тип данных и другую информацию, необходимую для восстановления ndarray таким образом, чтобы массив можно было правильно извлечь, даже если файл находится на другой машине с другой архитектурой.
Если вы хотите сохранить один объект ndarray, сохраните его как файл .npy с помощью np.save. Если вы хотите сохранить более одного объекта ndarray в одном файле, сохраните его как файл .npz с помощью np.savez. Вы также можете сохранить несколько массивов в один файл в сжатом формате npz с помощью savez_compressed.
Сохранение и загрузка массива с помощью np.save() очень просто. Просто укажите массив, который вы хотите сохранить, и имя файла. Например, если вы создаёте этот массив:
>>> a = np.array([1, 2, 3, 4, 5, 6])
Вы можете сохранить его как «filename.npy» с помощью:
>>> np.save('filename', a)
Вы можете использовать np.load() для восстановления вашего массива.
>>> b = np.load('filename.npy')
Чтобы проверить ваш массив, вы можете выполнить::
>>> print(b)
[1 2 3 4 5 6]
Вы можете сохранить массив NumPy в обычный текстовый файл, например, в файл .csv или .txt, с помощью np.savetxt.
Например, если вы создаёте этот массив:
>>> csv_arr = np.array([1, 2, 3, 4, 5, 6, 7, 8])
Вы можете легко сохранить его как файл .csv с именем «new_file.csv» следующим образом:
>>> np.savetxt('new_file.csv', csv_arr)
Вы можете быстро и легко загрузить сохранённый текстовый файл с помощью loadtxt():
>>> np.loadtxt('new_file.csv')
array([1., 2., 3., 4., 5., 6., 7., 8.])
Функции savetxt() и loadtxt() принимают дополнительные необязательные параметры, такие как заголовок, подвал и разделитель. Хотя текстовые файлы могут быть удобнее для обмена, файлы .npy и .npz меньше и быстрее загружаются. Если вам нужна более сложная обработка текстового файла (например, если вам нужно работать со строками, содержащими пропущенные значения), вам следует использовать функцию genfromtxt.
С помощью savetxt вы можете указать заголовки, подвалы, комментарии и многое другое.
Узнайте больше о процедурах ввода-вывода здесь.
Импорт и экспорт CSV
Просто прочитать CSV, содержащий имеющуюся информацию, очень просто. Лучший и самый простой способ сделать это — использовать Pandas.
>>> import pandas as pd

>>> # If all of your columns are the same type:
>>> x = pd.read_csv('music.csv', header=0).values
>>> print(x)
[['Billie Holiday' 'Jazz' 1300000 27000000]
 ['Jimmie Hendrix' 'Rock' 2700000 70000000]
 ['Miles Davis' 'Jazz' 1500000 48000000]
 ['SIA' 'Pop' 2000000 74000000]]

>>> # You can also simply select the columns you need:
>>> x = pd.read_csv('music.csv', usecols=['Artist', 'Plays']).values
>>> print(x)
[['Billie Holiday' 27000000]
 ['Jimmie Hendrix' 70000000]
 ['Miles Davis' 48000000]
 ['SIA' 74000000]]
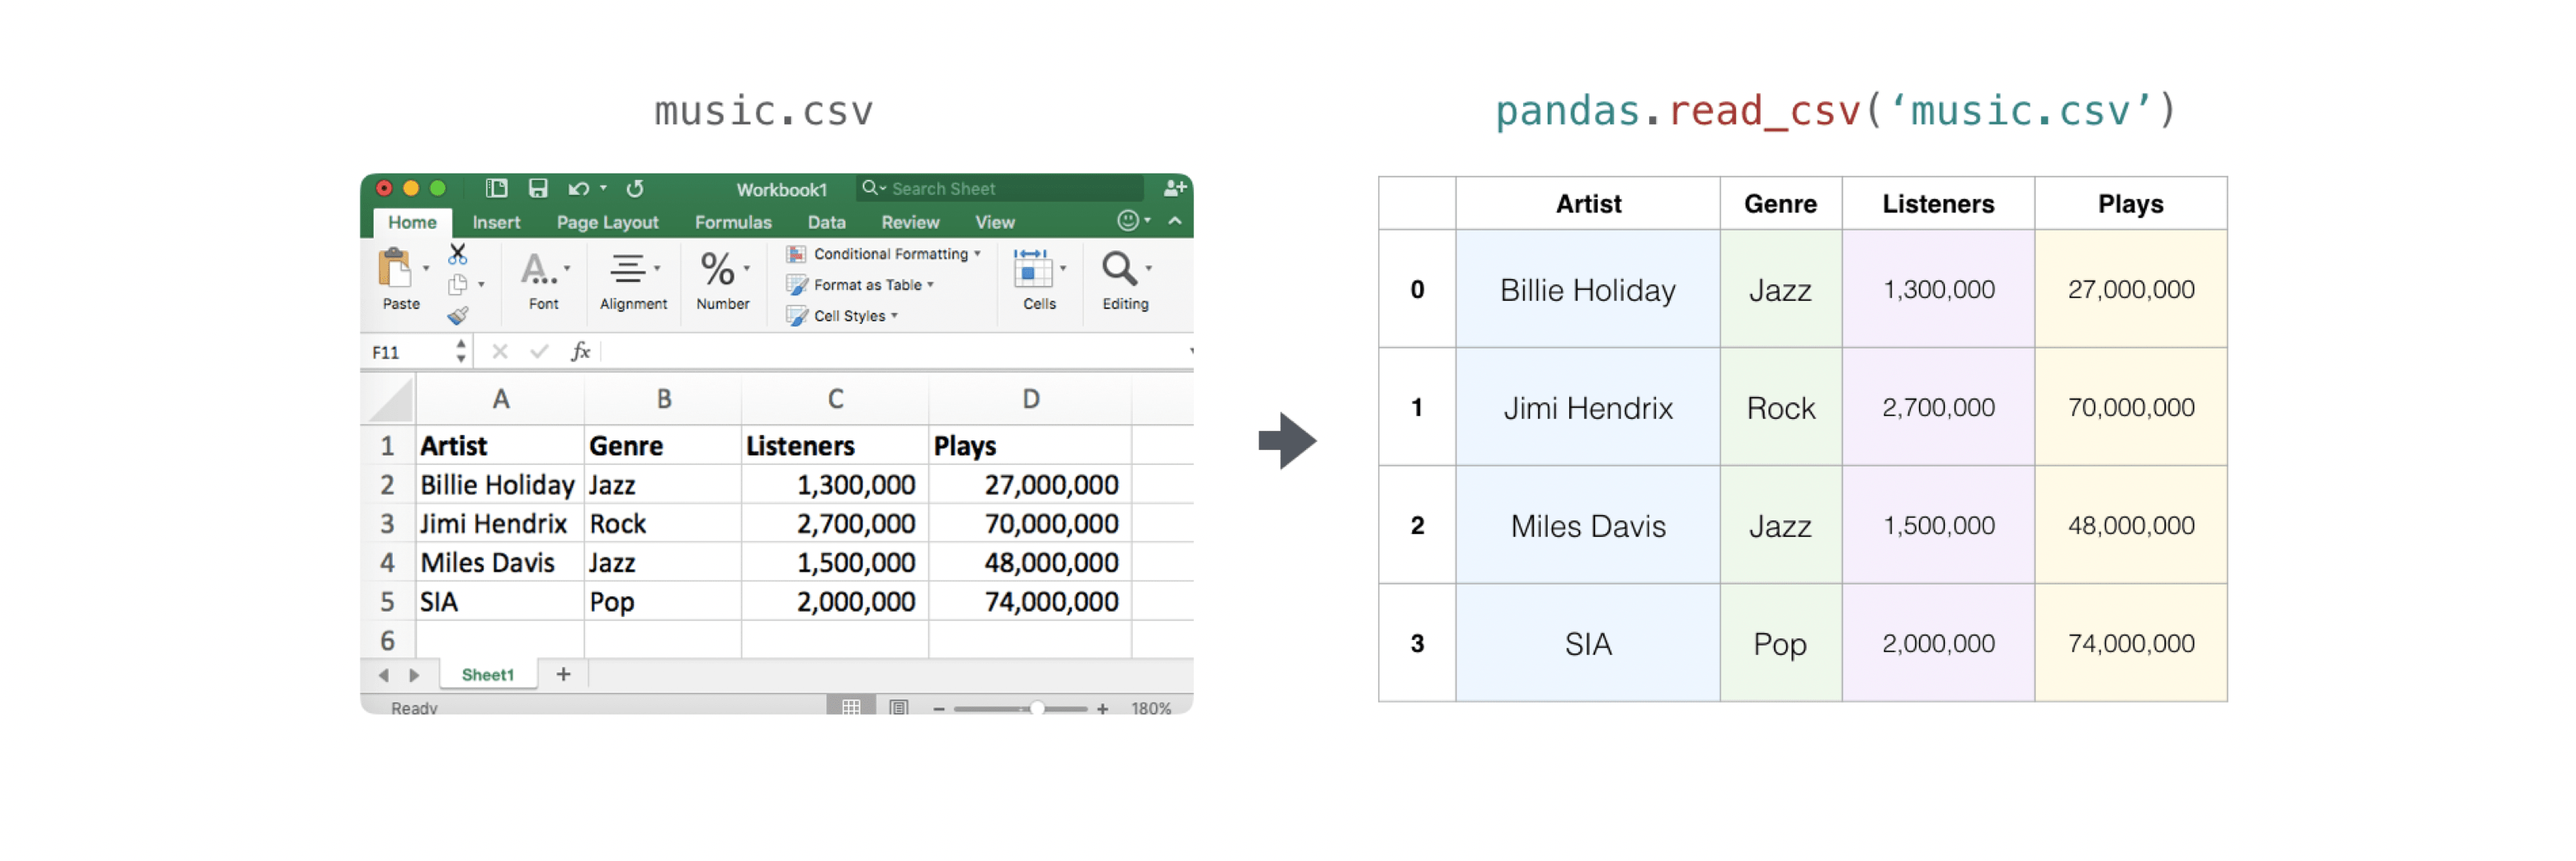
Используя Pandas, легко экспортировать ваш массив. Если вы новичок в NumPy, вы можете создать таблицу Pandas из значений вашего массива, а затем записать таблицу в CSV-файл с помощью Pandas.
Если вы создали этот массив «a»
>>> a = np.array([[-2.58289208,  0.43014843, -1.24082018, 1.59572603],
...               [ 0.99027828, 1.17150989,  0.94125714, -0.14692469],
...               [ 0.76989341,  0.81299683, -0.95068423, 0.11769564],
...               [ 0.20484034,  0.34784527,  1.96979195, 0.51992837]])
Вы могли бы создать таблицу Pandas
>>> df = pd.DataFrame(a)
>>> print(df)
          0         1         2         3
0 -2.582892  0.430148 -1.240820  1.595726
1  0.990278  1.171510  0.941257 -0.146925
2  0.769893  0.812997 -0.950684  0.117696
3  0.204840  0.347845  1.969792  0.519928
Вы можете легко сохранить свою таблицу с помощью:
>>> df.to_csv('pd.csv')
И загрузить ваш CSV с помощью:
>>> data = pd.read_csv('pd.csv')

Вы также можете сохранить свой массив с помощью метода NumPy savetxt.
>>> np.savetxt('np.csv', a, fmt='%.2f', delimiter=',', header='1, 2, 3, 4')
Если вы используете командную строку, вы можете прочитать сохранённый CSV в любое время с помощью команды, например:
$ cat np.csv
#  1,  2,  3,  4
-2.58,0.43,-1.24,1.60
0.99,1.17,0.94,-0.15
0.77,0.81,-0.95,0.12
0.20,0.35,1.97,0.52
Или вы можете открыть файл в любое время с помощью текстового редактора!
Если вы хотите узнать больше о Pandas, ознакомьтесь с официальной документацией Pandas. Узнайте, как установить Pandas, в официальной информации об установке Pandas.
Отображение массивов с помощью Matplotlib
Если вам нужно создать график для ваших значений, это очень просто с помощью Matplotlib.
Например, у вас может быть массив, подобный этому:
>>> a = np.array([2, 1, 5, 7, 4, 6, 8, 14, 10, 9, 18, 20, 22])
Если у вас уже установлен Matplotlib, вы можете импортировать его с помощью:
>>> import matplotlib.pyplot as plt

# If you're using Jupyter Notebook, you may also want to run the following
# line of code to display your code in the notebook:

%matplotlib inline
Всё, что вам нужно сделать, чтобы отобразить свои значения, это выполнить:
>>> plt.plot(a)

# If you are running from a command line, you may need to do this:
# >>> plt.show()

Например, вы можете отобразить одномерный массив так:
>>> x = np.linspace(0, 5, 20)
>>> y = np.linspace(0, 10, 20)
>>> plt.plot(x, y, 'purple') # line
>>> plt.plot(x, y, 'o')      # dots

С помощью Matplotlib у вас есть доступ к огромному количеству вариантов визуализации.
>>> fig = plt.figure()
>>> ax = fig.add_subplot(projection='3d')
>>> X = np.arange(-5, 5, 0.15)
>>> Y = np.arange(-5, 5, 0.15)
>>> X, Y = np.meshgrid(X, Y)
>>> R = np.sqrt(X**2 + Y**2)
>>> Z = np.sin(R)

>>> ax.plot_surface(X, Y, Z, rstride=1, cstride=1, cmap='viridis')

Чтобы узнать больше о Matplotlib и его возможностях, ознакомьтесь с официальной документацией. Инструкции по установке Matplotlib см. в разделе установки на официальном сайте.
Изображение предоставлено: Jay Alammar http://jalammar.github.io/
© 2005–2022 NumPy Developers
Licensed under the 3-clause BSD License.
https://numpy.org/doc/1.21/user/absolute_beginners.html


