2.5. Разложение сигналов на компоненты (задачи факторизации матриц)
2.5.1. Главный компонентный анализ (PCA)
2.5.1.1. Точный PCA и вероятностная интерпретация
PCA используется для разложения многомерного набора данных на набор последовательных ортогональных компонентов, объясняющих максимальную часть дисперсии. В scikit-learn, PCA реализован как объект-трансформатор, который обучается \(n\) компонентам в его методе fit, и может быть использован для новых данных, чтобы спроецировать их на эти компоненты.
PCA центрирует, но не масштабирует входные данные для каждого признака перед применением SVD. Опциональный параметр whiten=True позволяет спроецировать данные на сингулярное пространство, масштабируя каждый компонент до единичной дисперсии. Это часто полезно, если последующие модели делают сильные предположения об изотропии сигнала: это, например, относится к машинам опорных векторов с ядром RBF и алгоритму кластеризации K-Means.
Ниже приведен пример набора данных ирисов, состоящего из 4 признаков, спроецированных на 2 измерения, объясняющие наибольшую часть дисперсии:

Объект PCA также предоставляет вероятностную интерпретацию PCA, которая может дать вероятность данных на основе количества дисперсии, которое она объясняет. Таким образом, он реализует метод score, который может быть использован в перекрестной проверке:

Примеры
2.5.1.2. Инкрементальный PCA
Объект PCA очень полезен, но имеет определенные ограничения для больших наборов данных. Самое главное ограничение заключается в том, что PCA поддерживает только пакетную обработку, что означает, что все данные для обработки должны помещаться в оперативную память. Объект IncrementalPCA использует другой тип обработки и позволяет выполнять частичные вычисления, которые почти точно соответствуют результатам PCA при обработке данных в виде мини-пакетов. IncrementalPCA позволяет реализовать PCA вне оперативной памяти, либо:
- Используя свой метод
partial_fitна фрагментах данных, последовательно извлекаемых из локального жесткого диска или сетевой базы данных. - Вызывая свой метод fit на файле с отображением памяти, используя
numpy.memmap.
IncrementalPCA хранит только оценки дисперсий компонентов и шума, чтобы обновлять explained_variance_ratio_ инкрементально. Вот почему использование памяти зависит от количества образцов в каждом пакете, а не от количества образцов в наборе данных.
Как и в PCA, IncrementalPCA центрирует, но не масштабирует входные данные для каждого признака перед применением SVD.


Примеры
2.5.1.3. PCA с использованием случайного SVD
Часто интересно спроецировать данные на пространство меньшей размерности, сохраняя при этом большую часть дисперсии, отбросив сингулярные векторы компонентов, связанные с меньшими сингулярными значениями.
Например, если мы работаем с 64x64 пиксельными изображениями серого уровня для распознавания лиц, размерность данных составляет 4096, и медленнее тренировать машину опорных векторов RBF на таких широких данных. Кроме того, мы знаем, что внутренняя размерность данных намного меньше 4096, поскольку все изображения человеческих лиц выглядят примерно одинаково. Образцы лежат на многообразии гораздо меньшей размерности (скажем, около 200, например). Алгоритм PCA может использоваться для линейного преобразования данных, одновременно уменьшая размерность и сохраняя при этом большую часть объясненной дисперсии.
Класс PCA с опциональным параметром svd_solver='randomized' очень полезен в этом случае: поскольку мы собираемся отбросить большинство сингулярных векторов, гораздо эффективнее ограничить вычисления приблизительной оценкой сингулярных векторов, которые мы сохраним, чтобы фактически выполнить преобразование.
Например, ниже показаны 16 образцов портретов (центрированных вокруг 0.0) из набора данных Olivetti. В правой части представлены первые 16 сингулярных векторов, переформатированных как портреты. Поскольку нам нужны только первые 16 сингулярных векторов набора данных с размером \(n_{samples} = 400\) и \(n_{features} = 64 \times 64 = 4096\), время вычислений составляет менее 1 секунды:


Если мы обозначим \(n_{\max} = \max(n_{\mathrm{samples}}, n_{\mathrm{features}})\) и \(n_{\min} = \min(n_{\mathrm{samples}}, n_{\mathrm{features}})\), временная сложность случайного PCA составляет \(O(n_{\max}^2 \cdot n_{\mathrm{components}})\) вместо \(O(n_{\max}^2 \cdot n_{\min})\) для точного метода, реализованного в PCA.
Затраты памяти случайного PCA также пропорциональны \(2 \cdot n_{\max} \cdot n_{\mathrm{components}}\) вместо \(n_{\max} \cdot n_{\min}\) для точного метода.
Примечание: реализация inverse_transform в PCA с svd_solver='randomized' не является точным обратным преобразованием transform даже при whiten=False (по умолчанию).
Примеры
Ссылки
- Алгоритм 4.3 в “Finding structure with randomness: Stochastic algorithms for constructing approximate matrix decompositions” Halko и др., 2009
- “An implementation of a randomized algorithm for principal component analysis” A. Szlam и др. 2014
2.5.1.4. Разложение главных компонент с разреженностью (SparsePCA и MiniBatchSparsePCA)
SparsePCA — это разновидность метода PCA, цель которого — извлечь набор разреженных компонент, которые лучше всего восстанавливают данные.
Разложение главных компонент с разреженностью на мини-пакетах (MiniBatchSparsePCA) — это разновидность SparsePCA, которая быстрее, но менее точна. Увеличение скорости достигается путем итераций по небольшим частям набора признаков для заданного количества итераций.
Метод анализа главных компонент (PCA) имеет недостаток, что извлеченные компоненты имеют исключительно плотные выражения, то есть они имеют ненулевые коэффициенты при представлении в виде линейных комбинаций исходных переменных. Это может затруднить интерпретацию. Во многих случаях реальные подлежащие компоненты могут быть более естественно представлены как разреженные векторы; например, в распознавании лиц компоненты могут естественно отображаться на части лица.
Разложение по разреженным главным компонентам обеспечивает более экономное и интерпретируемое представление, четко показывая, какие из исходных признаков вносят вклад в различия между образцами.
Следующий пример иллюстрирует 16 компонент, извлеченных с помощью Sparse PCA из набора данных лиц Olivetti. Видно, как член регуляризации вводит много нулей. Кроме того, естественная структура данных приводит к тому, что ненулевые коэффициенты располагаются вертикально рядом. Модель не навязывает это математически: каждая компонента — это вектор \(h \in \mathbf{R}^{4096}\), и нет понятия вертикального расположения, за исключением визуализации для удобства восприятия человека как изображений 64x64 пикселя. То, что показанные ниже компоненты кажутся локальными, является результатом внутренней структуры данных, которая заставляет такие локальные шаблоны минимизировать ошибку восстановления. Существуют нормы, вводящие разреженность, которые учитывают смежность и различные виды структуры; см. [Jen09] для обзора таких методов. Более подробную информацию о том, как использовать Sparse PCA, см. в разделе Примеры ниже.

Обратите внимание, что существует множество различных формулировок задачи Sparse PCA. Реализованная здесь основана на [Mrl09] . Решаемая задача оптимизации — это задача PCA (обучение словарям) с штрафом \(\ell_1\) по компонентам:
\(||.||_{\text{Fro}}\) обозначает норму Фробениуса, а \(||.||_{1,1}\) обозначает поэлементную матричную норму, которая представляет собой сумму абсолютных значений всех элементов матрицы. Норма матрицы \(||.||_{1,1}\), вызывающая разреженность, также предотвращает обучение компонент по шуму, когда доступно мало обучающих образцов. Степень штрафа (и, следовательно, разреженность) может быть скорректирована с помощью гиперпараметра alpha. Малые значения приводят к слегка регулируемому разложению, а большие значения уменьшают многие коэффициенты до нуля.
Примечание
Хотя класс MiniBatchSparsePCA и имеет дух онлайн-алгоритма, он не реализует partial_fit , потому что алгоритм онлайн по направлению признаков, а не по направлению образцов.
Примеры
Ссылки
“Online Dictionary Learning for Sparse Coding” J. Mairal, F. Bach, J. Ponce, G. Sapiro, 2009
“Structured Sparse Principal Component Analysis” R. Jenatton, G. Obozinski, F. Bach, 2009
2.5.2. Ядерный метод главных компонент (kPCA)
2.5.2.1. Точный ядерный метод главных компонент
KernelPCA является расширением метода главных компонент (PCA), которое достигает нелинейного уменьшения размерности с помощью ядер (см. Параметрические метрики, близости и ядра) [Scholkopf1997]. Он имеет множество применений, включая подавление шума, сжатие и структурированную классификацию (оценка зависимости ядер). KernelPCA поддерживает как transform так и inverse_transform.

Примечание
KernelPCA.inverse_transform опирается на ядерное сглаживание для обучения функции отображения образцов из базиса PCA в исходное пространство признаков [Bakir2003]. Таким образом, реконструкция, полученная с помощью KernelPCA.inverse_transform, является приближением. Более подробную информацию см. в примере, указанном ниже.
Примеры
- Ядерный метод главных компонент
- Подавление шума изображений с помощью ядерного метода главных компонент
Литература
Schölkopf, Bernhard, Alexander Smola, and Klaus-Robert Müller. “Kernel principal component analysis.” Международная конференция по искусственным нейронным сетям. Springer, Берлин, Гейдельберг, 1997.
Bakır, Gökhan H., Jason Weston, and Bernhard Schölkopf. “Learning to find pre-images.” Прогресс в обработке информации нейронными сетями 16 (2003): 449-456.
2.5.2.2. Выбор решателя для ядерного метода главных компонент
В то время как в PCA количество компонент ограничено количеством признаков, в KernelPCA количество компонент ограничено количеством образцов. Многие реальные наборы данных имеют большое количество образцов! В этих случаях поиск всех компонент с полным ядерным методом главных компонент является пустой тратой вычислительного времени, так как данные в основном описываются первыми несколькими компонентами (например, n_components<=100). Другими словами, центрированная матрица Грама, которая подвергается собственному разложению в процессе подгонки ядерного метода главных компонент, имеет эффективный ранг, который намного меньше её размера. Это ситуация, когда приближенные решатели собственных значений могут обеспечить ускорение с очень низкой потерей точности.
Решатели собственных значений
Дополнительный параметр eigen_solver='randomized' может быть использован для значительного сокращения времени вычислений, когда количество запрашиваемых n_components невелико по сравнению с количеством образцов. Он опирается на методы случайного разложения для нахождения приближенного решения за более короткое время.
Сложность по времени случайного KernelPCA составляет \(O(n_{\mathrm{samples}}^2 \cdot n_{\mathrm{components}})\) вместо \(O(n_{\mathrm{samples}}^3)\) для точного метода, реализованного с помощью eigen_solver='dense'.
Объем памяти случайного KernelPCA также пропорционален \(2 \cdot n_{\mathrm{samples}} \cdot n_{\mathrm{components}}\) вместо \(n_{\mathrm{samples}}^2\) для точного метода.
Примечание: эта техника аналогична использованию в PCA с использованием случайного SVD.
Помимо двух вышеуказанных решателей, eigen_solver='arpack' может быть использован как альтернативный способ получения приближенного разложения. На практике этот метод обеспечивает разумное время выполнения только при очень малом количестве компонент для поиска. Он включен по умолчанию, когда желаемое количество компонент меньше 10 (строго) и количество образцов больше 200 (строго). Подробности см. в KernelPCA.
Литература
- dense решатель: документация scipy.linalg.eigh
-
randomized решатель:
- Алгоритм 4.3 в “Finding structure with randomness: Stochastic algorithms for constructing approximate matrix decompositions” Halko, et al. (2009)
- “An implementation of a randomized algorithm for principal component analysis” A. Szlam et al. (2014)
- arpack решатель: документация scipy.sparse.linalg.eigsh R. B. Lehoucq, D. C. Sorensen, and C. Yang, (1998)
2.5.3. Трёхмерное разложение сингулярных значений и латентный семантический анализ
TruncatedSVD реализует вариант разложения сингулярных значений (SVD), который вычисляет только \(k\) наибольших сингулярных значений, где \(k\) — параметр, задаваемый пользователем.
TruncatedSVD очень похож на PCA, но отличается тем, что матрица \(X\) не должна быть центрирована. Если из значений признаков вычитаются столбцовые (по признаку) средние значения \(X\), то усечённое разложение сингулярных значений (SVD) на полученной матрице эквивалентно PCA.
О усечённом SVD и латентном семантическом анализе (LSA)
При применении усечённого SVD к матрицам терм-документ (как возвращает CountVectorizer или TfidfVectorizer), это преобразование известно как латентный семантический анализ (LSA), потому что оно преобразует такие матрицы в «семантическое» пространство малой размерности. В частности, LSA известно тем, что оно борется с эффектами синонимии и полисемии (оба, грубо говоря, означают, что на один и тот же термин может приходиться несколько значений), которые заставляют матрицы терм-документ быть чрезмерно разреженными и демонстрировать плохую схожесть по таким мерам, как косинусное сходство.
Примечание
LSA также известен как латентная семантическая индексация, LSI, хотя строго говоря, это относится к его использованию в постоянных индексах для целей поиска информации.
Математически, усечённое SVD, применённое к обучающим выборкам \(X\), даёт приближение низкого ранга \(X\):
После этой операции \(U_k \Sigma_k\) — преобразованный обучающий набор с \(k\) признаками (называемыми n_components в API).
Чтобы преобразовать также тестовый набор \(X\), мы умножаем его на \(V_k\):
Примечание
В большинстве работ по LSA в литературе по обработке естественного языка (NLP) и поиску информации (IR) меняют оси матрицы \(X\), так что она имеет форму (n_features, n_samples). Мы представляем LSA другим способом, который лучше соответствует API scikit-learn, но найденные сингулярные значения одинаковы.
Хотя преобразователь TruncatedSVD работает с любой матрицей признаков, рекомендуется использовать его на матрицах tf-idf вместо исходных частот в настройках LSA/обработки документов. В частности, следует включить подлинейное масштабирование и обратную частоту документов (sublinear_tf=True, use_idf=True) для приближения значений признаков к гауссовой распределению, компенсируя ошибочные предположения LSA относительно текстовых данных.
Примеры
Ссылки
- Кристофер Д. Мэннинг, Прабхакар Рагаван и Хинрих Шуц (2008), Введение в поиск информации, Издательство Кембриджского университета, глава 18: Разложения матриц и латентный семантический индекс
2.5.4. Обучение словаря
2.5.4.1. Разряженное кодирование с предварительно вычисленным словарем
Объект SparseCoder — это оценочный объект, который можно использовать для преобразования сигналов в разряжённую линейную комбинацию атомов из фиксированного, предварительно вычисленного словаря, такого как дискретное вейвлет-представление. Поэтому этот объект не реализует метод fit. Преобразование сводится к задаче разряженного кодирования: нахождение представления данных как линейной комбинации как можно меньшего количества атомов словаря. Все варианты обучения словаря реализуют следующие методы преобразования, управляемые параметром инициализации transform_method:
- Ортогональное преследование (Ортогональное преследование (OMP))
- Регрессия наименьших углов (Регрессия наименьших углов)
- Lasso, вычисленный с помощью регрессии наименьших углов
- Lasso с использованием координатного спуска (Lasso)
- Порогование
Порогование очень быстро, но не обеспечивает точных реконструкций. В литературе они показали свою полезность в задачах классификации. Для задач реконструкции изображений ортогональное преследование даёт наиболее точную, несмещённую реконструкцию.
Объекты обучения словаря, посредством параметра split_code, позволяют разделить положительные и отрицательные значения в результатах разряженного кодирования. Это полезно, когда обучение словаря используется для извлечения признаков, которые будут использованы для задач обучения с учителем, так как это позволяет алгоритму обучения присваивать разные веса отрицательным нагрузкам определённого атома по отношению к соответствующим положительным нагрузкам.
Разделенный код для одного образца имеет длину 2 * n_components и создается по следующему правилу: сначала вычисляется обычный код длиной n_components. Затем первые n_components элементов split_code заполняются положительной частью вектора обычного кода. Вторая половина разделенного кода заполняется отрицательной частью вектора кода, только с положительным знаком. Следовательно, split_code неотрицателен.
Примеры
2.5.4.2. Обучение словаря общего вида
Обучение словаря (DictionaryLearning) — это задача факторизации матриц, которая сводится к поиску (обычно избыточного) словаря, который хорошо справится с разряженным кодированием подгоняемых данных.
Представление данных как разряженных комбинаций атомов из избыточного словаря предположительно является способом работы первичной зрительной коры млекопитающих. Вследствие этого, обучение словаря на фрагментах изображений показало хорошие результаты в задачах обработки изображений, таких как завершение изображения, заполнение и шумоподавление, а также в задачах распознавания с учителем.
Обучение словаря — это задача оптимизации, решаемая путём альтернативного обновления разряженного кода как решения множества задач Lasso с фиксированным словарем и затем обновления словаря для наилучшего соответствия разряженному коду.

\(||.||_{\text{Fro}}\) обозначает норму Фробениуса, а \(||.||_{1,1}\) — норму матрицы по элементам, которая представляет собой сумму абсолютных значений всех элементов матрицы. После использования такой процедуры для подгонки словаря преобразование просто сводится к шагу разряженного кодирования, который имеет одинаковую реализацию со всеми объектами обучения словаря (см. Разряженное кодирование с предварительно вычисленным словарем).
Также можно ограничить словарь и/или код положительными значениями, чтобы соответствовать ограничениям, которые могут присутствовать в данных. Ниже приведены лица с различными ограничениями на положительность. Красный цвет обозначает отрицательные значения, синий — положительные, а белый — нули.


Следующее изображение показывает, как выглядит словарь, обученный на фрагментах изображения 4x4 пикселей, извлеченных из части изображения морды енота.

Примеры
Ссылки
- “Online dictionary learning for sparse coding” J. Mairal, F. Bach, J. Ponce, G. Sapiro, 2009
2.5.4.3. Обучение словаря мини-пачками
MiniBatchDictionaryLearning реализует более быстрый, но менее точный вариант алгоритма обучения словаря, который лучше подходит для больших наборов данных.
По умолчанию MiniBatchDictionaryLearning делит данные на мини-пачки и оптимизирует онлайн-режиме, проходя циклами по мини-пачкам для указанного числа итераций. Однако в настоящее время он не реализует условие остановки.
Этот оценочный объект также реализует partial_fit, который обновляет словарь, проходя по мини-пачке только один раз. Это можно использовать для онлайн-обучения, когда данные недоступны сразу, или когда данные не помещаются в оперативную память.

2.5.5. Факторный анализ
В задачах обучения без учителя у нас есть только набор данных \(X = \{x_1, x_2, \dots, x_n \}\). Как этот набор данных можно описать математически? Очень простой continuous latent variable моделью для \(X\) является
Вектор \(h_i\) называется «скрытым», потому что он не наблюдается. \(\epsilon\) считается шумовым членом, распределенным по Гауссу со средним 0 и ковариацией \(\Psi\) (т.е. \(\epsilon \sim \mathcal{N}(0, \Psi)\)), \(\mu\) — некоторый произвольный вектор смещения. Такая модель называется «генеративной», так как она описывает, как \(x_i\) генерируется из \(h_i\). Если использовать все \(x_i\) в качестве столбцов для формирования матрицы \(\mathbf{X}\) и все \(h_i\) в качестве столбцов матрицы \(\mathbf{H}\), то можно записать (с соответствующим определением \(\mathbf{M}\) и \(\mathbf{E}\)):
Другими словами, мы разложили матрицу \(\mathbf{X}\).
Если \(h_i\) задано, приведенное выше уравнение автоматически подразумевает следующую вероятностную интерпретацию:
Для полной вероятностной модели также необходима априорное распределение для скрытой переменной \(h\). Самое простое предположение (основанное на хороших свойствах распределения Гаусса) — \(h \sim \mathcal{N}(0, \mathbf{I})\). Это приводит к Гауссу в качестве распределения маргинального значения \(x\):
Теперь, без дополнительных предположений, идея наличия скрытой переменной \(h\) была бы излишней — \(x\) можно полностью смоделировать с помощью среднего значения и ковариации. Нам нужно ввести некоторую более специфическую структуру для одного из этих двух параметров. Простой дополнительный предположение касается структуры ковариации ошибки \(\Psi\):
-
\(\Psi = \sigma^2 \mathbf{I}\): Это предположение приводит к вероятностной модели
PCA. -
\(\Psi = \mathrm{diag}(\psi_1, \psi_2, \dots, \psi_n)\): Эта модель называется
FactorAnalysis, классической статистической моделью. Матрица W иногда называется «матрицей факторных нагрузок».
Обе модели по существу оценивают Гаусс с матрицей ковариации низкого ранга. Поскольку обе модели являются вероятностными, их можно интегрировать в более сложные модели, например, Смесь факторных анализаторов. Получаются очень разные модели (например, FastICA), если предполагаются не гауссовы априорные распределения для скрытых переменных.
Факторный анализ может генерировать компоненты, аналогичные компонентам (столбцам матрицы нагрузок) PCA. Однако нельзя сделать общих заявлений об этих компонентах (например, об их ортогональности):

Основное преимущество факторного анализа по сравнению с PCA заключается в том, что он может моделировать дисперсию в каждом направлении входного пространства независимо (гетероскедастичный шум):

Это позволяет лучше выбрать модель, чем вероятностный PCA в присутствии гетероскедастичного шума:

Факторный анализ часто сопровождается вращением факторов (с параметром rotation), обычно для улучшения интерпретируемости. Например, вращение Варимакс максимизирует сумму дисперсий квадратов нагрузок, то есть стремится к производству более разреженных факторов, которые зависят только от нескольких признаков каждый (простая структура). См., например, первый пример ниже.
Примеры
2.5.6. Анализ независимых компонентов (ICA)
Анализ независимых компонентов разделяет многомерный сигнал на аддитивные подкомпоненты, которые максимально независимы. В scikit-learn он реализован с помощью алгоритма Fast ICA. Как правило, ICA не используется для уменьшения размерности, а для разделения накладывающихся сигналов. Поскольку модель ICA не включает член шума, для корректности модели необходимо выполнить отбеливание. Это можно сделать внутри с помощью аргумента whiten или вручную, используя один из вариантов PCA.
Он классически используется для разделения смешанных сигналов (проблема, известная как «слепое разделение источников»), как в примере ниже:

ICA также может быть использован как еще один нелинейный метод разложения, который находит компоненты с некоторой разреженностью:

Примеры
2.5.7. Неотрицательная матричная факторизация (NMF или NNMF)
2.5.7.1. NMF с нормой Фробениуса
NMF [1] — это альтернативный подход к разложению, который предполагает, что данные и компоненты неотрицательны. NMF можно использовать вместо PCA или его вариантов в тех случаях, когда матрица данных не содержит отрицательных значений. Она находит разложение образцов \(X\) на две матрицы \(W\) и \(H\) с неотрицательными элементами, оптимизируя расстояние \(d\) между \(X\) и матричным произведением \(WH\). Наиболее часто используемой функцией расстояния является квадрат нормы Фробениуса, которая является очевидным обобщением евклидовой нормы на матрицы:
В отличие от PCA, представление вектора получается аддитивным способом, путём наложения компонентов без вычитания. Такие аддитивные модели эффективны для представления изображений и текста.
Было замечено в [Hoyer, 2004] [2], что при тщательном ограничении NMF может создать представление набора данных на основе частей, что приводит к интерпретируемым моделям. Следующий пример отображает 16 разреженных компонентов, найденных с помощью NMF из изображений набора данных лиц Оливье, по сравнению с собственными лицами PCA.

Атрибут init определяет метод инициализации, который оказывает большое влияние на производительность метода. NMF реализует метод Неотрицательного двойного разложения по единственному значению. NNDSVD [4] основан на двух процессах SVD, один приближает матрицу данных, а другой приближает положительные участки полученных частичных факторов SVD, используя алгебраическое свойство матриц единичного ранга. Базовый алгоритм NNDSVD лучше подходит для разреженной факторизации. Его варианты NNDSVDa (в котором все нули устанавливаются равными среднему всех элементов данных) и NNDSVDar (в котором нули устанавливаются случайными возмущениями, меньшими среднего значения данных, делённого на 100) рекомендуются в плотном случае.
Обратите внимание, что решатель Мультипликативного обновления (‘mu’) не может обновлять нули, присутствующие в инициализации, поэтому он приводит к худшим результатам, когда используется совместно с базовым алгоритмом NNDSVD, который вводит много нулей; в этом случае следует предпочесть NNDSVDa или NNDSVDar.
NMF также может быть инициализировано правильно масштабированными случайными неотрицательными матрицами, установив init="random". Целое число seed или RandomState также можно передать в random_state для контроля воспроизводимости.
В NMF можно добавить L1 и L2 приоры к функции потерь для регуляризации модели. L2 приор использует норму Фробениуса, а L1 приор использует норму L1 по элементам. Как и в ElasticNet, мы контролируем комбинацию L1 и L2 с параметром l1_ratio (\(\rho\)) и интенсивность регуляризации с параметрами alpha_W и alpha_H (\(\alpha_W\) и \(\alpha_H\)). Приоры масштабируются на количество образцов (\(n\_samples\)) для H и количество признаков (\(n\_features\)) для W для поддержания их воздействия сбалансированным по отношению друг к другу и к термину соответствия данным, максимально независимо от размера набора обучающих данных. Тогда члены приоров:
и регуляризованная целевая функция:
2.5.7.2. NMF с бета-расхождением
Как описано ранее, наиболее часто используемой функцией расстояния является квадрат нормы Фробениуса, которая является очевидным обобщением евклидовой нормы на матрицы:
В NMF можно использовать другие функции расстояния, например, (обобщённое) расхождение Кульбака-Лейблера (KL), также известное как I-расхождение:
Или, расхождение Итакура-Сайто (IS):
Эти три расстояния являются частными случаями семейства бета-расхождений с \(\beta = 2, 1, 0\) соответственно [6]. Бета-расхождения определяются следующим образом:
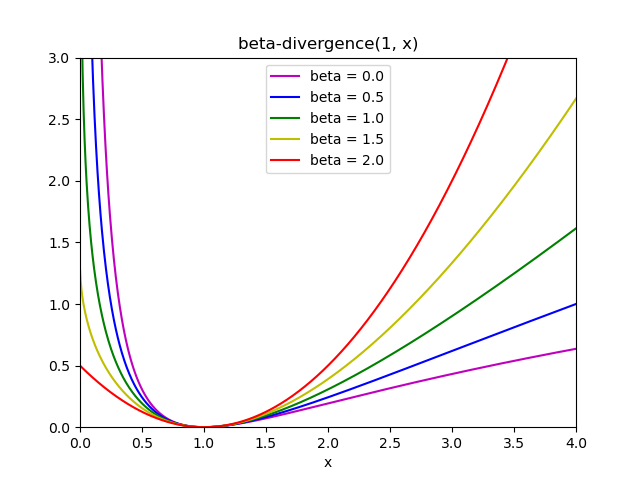
Обратите внимание, что это определение недействительно, если \(\beta \in (0; 1)\), но его можно непрерывно расширить до определений \(d_{KL}\) и \(d_{IS}\) соответственно.
Реализованные в NMF решатели
NMF реализует два решателя, используя метод координатного спуска (‘cd’) [5] и метод мультипликативного обновления (‘mu’) [6]. Решатель ‘mu’ может оптимизировать любое бета-расхождение, включая, конечно, норму Фробениуса (\(\beta=2\)), (обобщённое) расхождение Кульбака-Лейблера (\(\beta=1\)) и расхождение Итакура-Сайто (\(\beta=0\)). Обратите внимание, что для \(\beta \in (1; 2)\) решатель ‘mu’ значительно быстрее, чем для других значений \(\beta\). Также обратите внимание, что при отрицательном (или 0, т.е. ‘itakura-saito’) \(\beta\) входная матрица не может содержать нулевые значения.
Решатель ‘cd’ может оптимизировать только норму Фробениуса. Из-за вложенной невыпуклости NMF разные решатели могут сходиться к различным минимумам, даже при оптимизации одной и той же функции расстояния.
NMF лучше всего использовать с методом fit_transform, который возвращает матрицу W. Матрица H хранится в обученной модели в атрибуте components_; метод transform разложит новую матрицу X_new на основе этих сохранённых компонентов:
>>> import numpy as np
>>> X = np.array([[1, 1], [2, 1], [3, 1.2], [4, 1], [5, 0.8], [6, 1]])
>>> from sklearn.decomposition import NMF
>>> model = NMF(n_components=2, init='random', random_state=0)
>>> W = model.fit_transform(X)
>>> H = model.components_
>>> X_new = np.array([[1, 0], [1, 6.1], [1, 0], [1, 4], [3.2, 1], [0, 4]])
>>> W_new = model.transform(X_new)
Примеры
2.5.7.3. Мини-пакетный неотрицательный факторизация матриц
MiniBatchNMF [7] реализует более быструю, но менее точную версию неотрицательной факторизации матриц (т.е. NMF), лучше подходящую для больших наборов данных.
По умолчанию, MiniBatchNMF делит данные на мини-пакеты и оптимизирует модель NMF онлайн-способом, циклически переходя по мини-пакетам для указанного числа итераций. Параметр batch_size управляет размером пакетов.
Для ускорения алгоритма мини-пакетов также можно масштабировать предыдущие пакеты, придавая им меньшее значение, чем новым пакетам. Это делается с помощью так называемого фактора забывания, управляемого параметром forget_factor.
Оценщик также реализует partial_fit, который обновляет H путем итерации только один раз по мини-пакету. Это можно использовать для онлайн-обучения, когда данные недоступны сразу, или когда данные не помещаются в память.
Литература
2.5.8. Распределение по скрытым Дирихле (LDA)
Распределение по скрытым Дирихле (LDA) — это порождающая вероятностная модель для наборов дискретных наборов данных, таких как текстовые корпуса. Это также модель тем, которая используется для обнаружения абстрактных тем из набора документов.
Графическая модель LDA — это модель генерации на трёх уровнях:

Примечание к обозначениям, представленным в графической модели выше, которые можно найти в Hoffman et al. (2013):
- Корпус — это набор из \(D\) документов.
- Документ — это последовательность из \(N\) слов.
- В корпусе есть \(K\) тем.
- Прямоугольники представляют повторяющееся выборку.
В графической модели каждый узел — это случайная переменная, играющая роль в процессе генерации. Заштрихованный узел обозначает наблюдаемую переменную, а незаштрихованный узел обозначает скрытую (латентную) переменную. В данном случае словами в корпусе являются единственными данными, которые мы наблюдаем. Латентные переменные определяют случайную смесь тем в корпусе и распределение слов в документах. Цель LDA — использовать наблюдаемые слова для вывода скрытой структуры тем.
Подробности моделирования текстовых корпусов
При моделировании текстовых корпусов модель предполагает следующий процесс генерации для корпуса с \(D\) документами и \(K\) темами, где \(K\) соответствует n_components в API:
- Для каждой темы \(k \in K\), выберите \(\beta_k \sim \mathrm{Dirichlet}(\eta)\). Это предоставляет распределение по словам, то есть вероятность появления слова в теме \(k\). \(\eta\) соответствует
topic_word_prior. - Для каждого документа \(d \in D\), выберите пропорции тем \(\theta_d \sim \mathrm{Dirichlet}(\alpha)\). \(\alpha\) соответствует
doc_topic_prior. -
Для каждого слова \(i\) в документе \(d\):
- Выберите назначение темы \(z_{di} \sim \mathrm{Multinomial} (\theta_d)\)
- Выберите наблюдаемое слово \(w_{ij} \sim \mathrm{Multinomial} (\beta_{z_{di}})\)
Для оценки параметров, заднее распределение:
Поскольку заднее распределение трудновычислимо, метод вариационного Байеса использует более простое распределение \(q(z,\theta,\beta | \lambda, \phi, \gamma)\) для его приближения, и эти вариационные параметры \(\lambda\), \(\phi\), \(\gamma\) оптимизируются для максимизации Нижней границы доказательства (ELBO):
Максимизация ELBO эквивалентна минимизации расхождения Кульбака-Лейблера (KL) между \(q(z,\theta,\beta)\) и истинным задним распределением \(p(z, \theta, \beta |w, \alpha, \eta)\).
LatentDirichletAllocation реализует алгоритм онлайн вариационного Байеса и поддерживает методы онлайн и пакетного обновления. В то время как метод пакетного обновления обновляет вариационные переменные после каждого полного прохода по данным, метод онлайн обновления обновляет вариационные переменные из мини-пакетных точек данных.
Примечание
Хотя метод онлайн гарантированно сходится к точке локального оптимума, качество точки оптимума и скорость сходимости могут зависеть от размера мини-пакета и атрибутов, связанных с настройкой скорости обучения.
Когда LatentDirichletAllocation применяется к матрице «документ-термин», матрица будет разложена на матрицу «тема-термин» и матрицу «документ-тема». Матрица «тема-термин» хранится как components_ в модели, а матрица «документ-тема» может быть вычислена с помощью метода transform.
LatentDirichletAllocation также реализует метод partial_fit. Это используется, когда данные могут быть получены последовательно.
Примеры
Ссылки
- “Распределение по скрытым Дирихле” D. Blei, A. Ng, M. Jordan, 2003
- “Онлайн обучение для распределения по скрытым Дирихле” M. Hoffman, D. Blei, F. Bach, 2010
- “Стохастическое вариационное вычисление” M. Hoffman, D. Blei, C. Wang, J. Paisley, 2013
- “Критерий варимакса для аналитического вращения в факторном анализе” H. F. Kaiser, 1958
См. также Снижение размерности для снижения размерности с помощью анализа компонентов окрестностей.
© 2007–2025 The scikit-learn developers
Licensed under the 3-clause BSD License.
https://scikit-learn.org/1.6/modules/decomposition.html


