2.3. Кластеризация
Кластеризацию данных без меток можно выполнять с помощью модуля sklearn.cluster.
Каждый алгоритм кластеризации представлен в двух вариантах: класс реализует метод fit для обучения кластеров на обучающих данных, а функция, получая обучающие данные, возвращает массив целочисленных меток, соответствующих различным кластерам. Для класса метки обучающих данных доступны в атрибуте labels_.
2.3.1. Обзор методов кластеризации
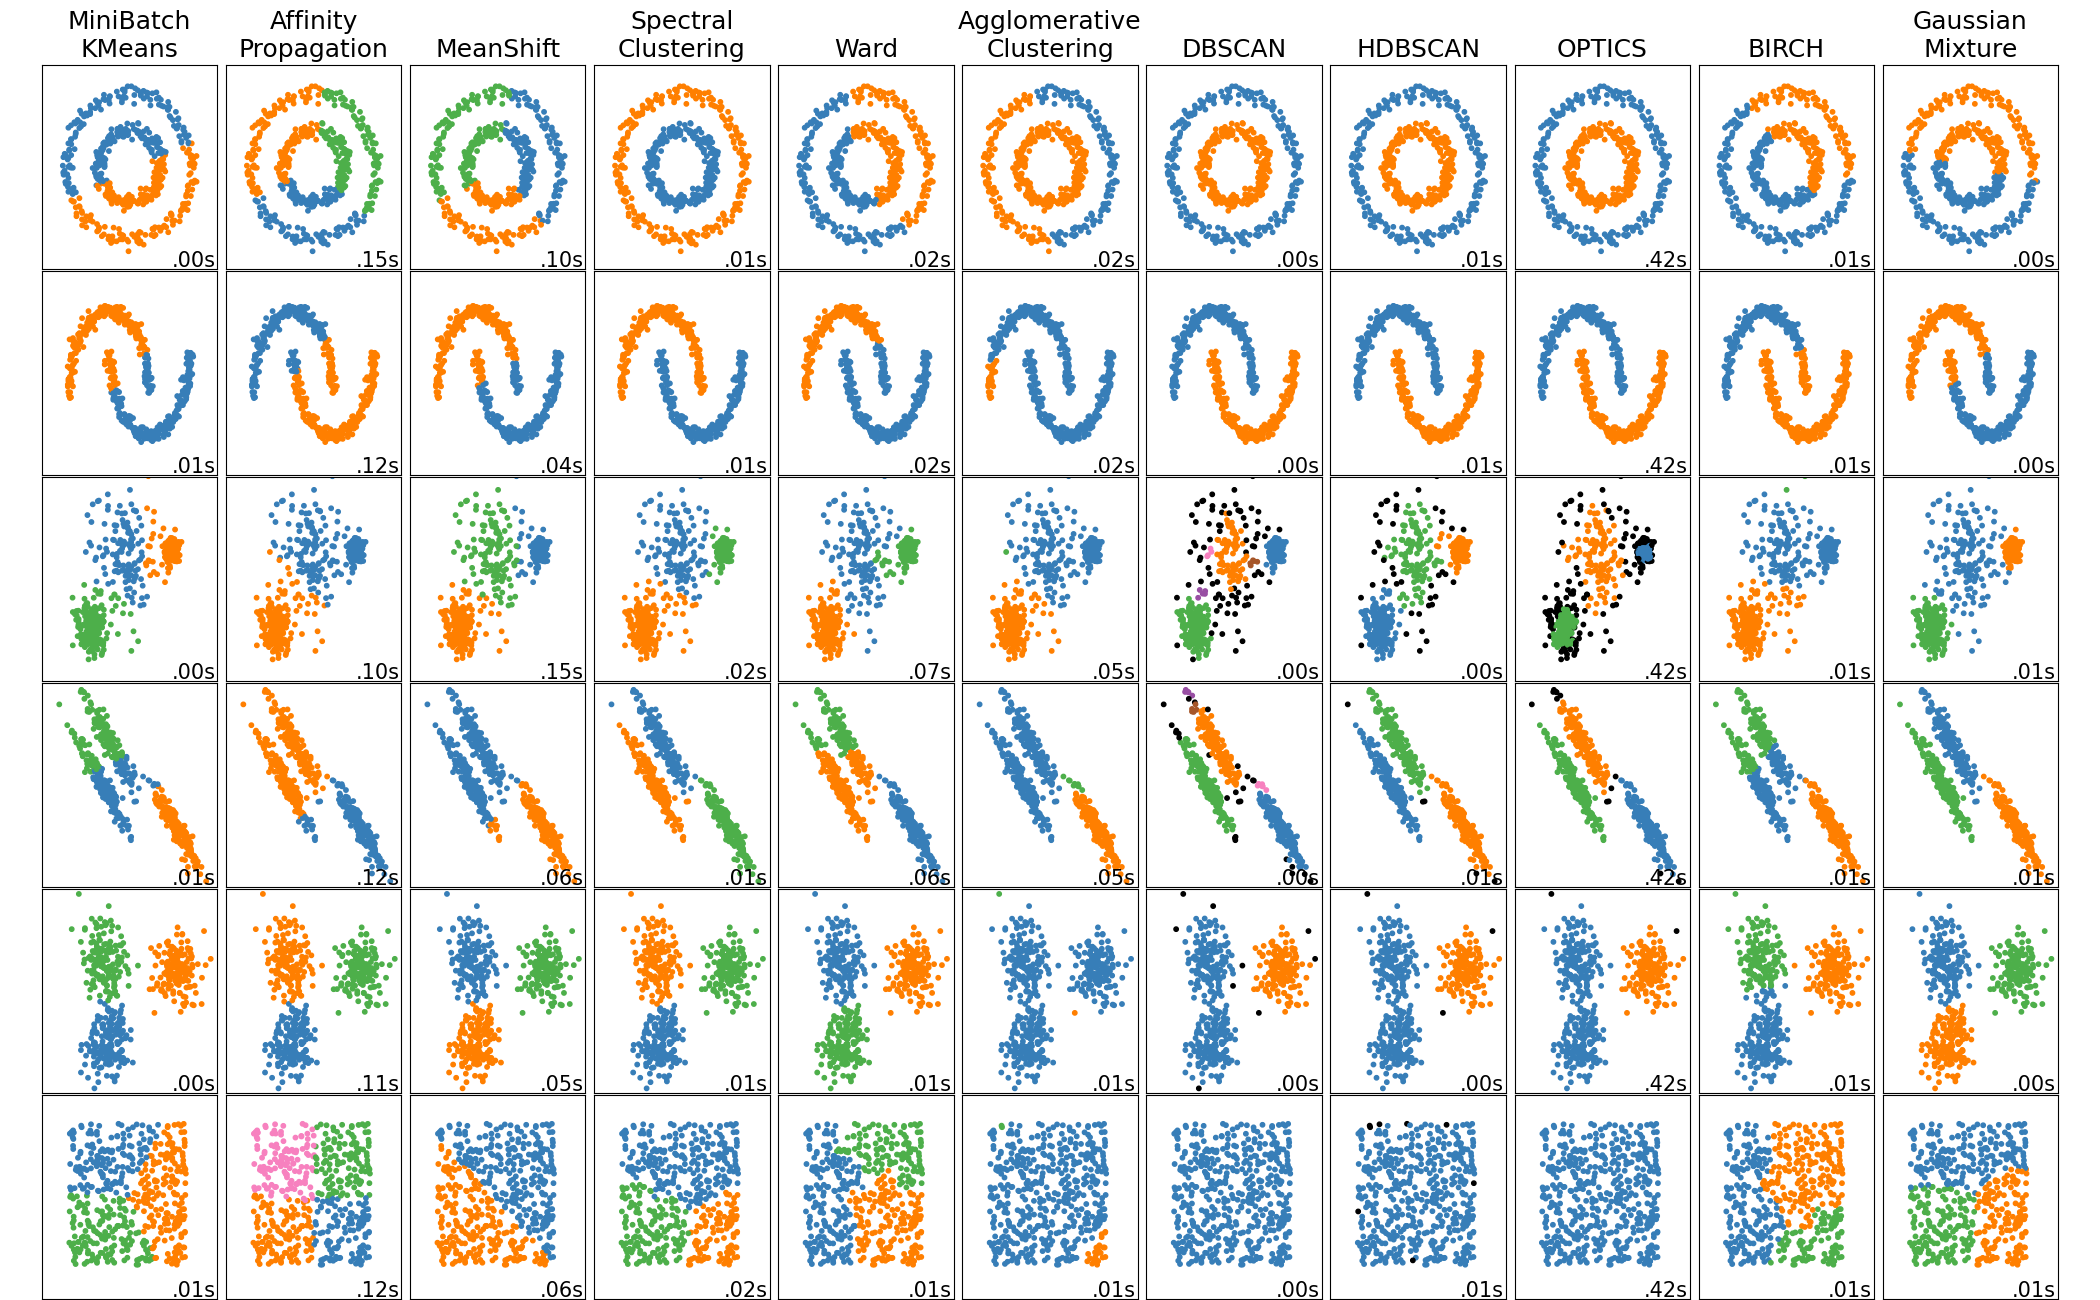
Сравнение алгоритмов кластеризации в scikit-learn
Название метода | Параметры | Масштабируемость | Применение | Геометрия (используемая метрика) |
|---|---|---|---|---|
число кластеров | Очень большие | Универсальное применение, кластеры одинакового размера, плоская геометрия, не слишком много кластеров, индуктивный метод | Расстояния между точками | |
коэффициент демпфирования, предпочтение для образца | Не масштабируется с ростом n_samples | Много кластеров, кластеры неодинакового размера, неплоская геометрия, индуктивный метод | Расстояние в графе (например, графе ближайших соседей) | |
ширина полосы | Не масштабируется с ростом | Много кластеров, кластеры неодинакового размера, неплоская геометрия, индуктивный метод | Расстояния между точками | |
число кластеров | Средние | Мало кластеров, кластеры одинакового размера, неплоская геометрия, трансдуктивный метод | Расстояние в графе (например, графе ближайших соседей) | |
число кластеров или порог расстояния | Большие | Много кластеров, возможно, с ограничениями связности, трансдуктивный метод | Расстояния между точками | |
число кластеров или порог расстояния, тип связи, расстояние | Большие | Много кластеров, возможно, с ограничениями связности, неевклидовы расстояния, трансдуктивный метод | Любое попарное расстояние | |
размер окрестности | Очень большие | Неплоская геометрия, кластеры неодинакового размера, удаление выбросов, трансдуктивный метод | Расстояния между ближайшими точками | |
минимальное число элементов кластера, минимальное число соседей точки | Большие | Неплоская геометрия, кластеры неодинакового размера, удаление выбросов, трансдуктивный метод, иерархический метод, переменная плотность кластеров | Расстояния между ближайшими точками | |
минимальное число элементов кластера | Очень большие | Неплоская геометрия, кластеры неодинакового размера, переменная плотность кластеров, удаление выбросов, трансдуктивный метод | Расстояния между точками | |
много | Не масштабируется | Плоская геометрия, подходит для оценки плотности, индуктивный метод | Расстояния Махаланобиса до центров | |
коэффициент ветвления, порог, необязательный глобальный кластеризатор. | Большие | Большой набор данных, удаление выбросов, сокращение данных, индуктивный метод | Евклидово расстояние между точками | |
число кластеров | Очень большие | Универсальное применение, кластеры одинакового размера, плоская геометрия, отсутствие пустых кластеров, индуктивный и иерархический методы | Расстояния между точками |
Кластеризация для неплоской геометрии полезна, когда кластеры имеют определённую форму, то есть лежат на неплоском многообразии, а стандартное евклидово расстояние не является подходящей метрикой. Этот случай представлен в двух верхних рядах рисунка выше.
Модели гауссовых смесей, которые можно использовать для кластеризации, описаны в другой главе документации, посвящённой моделям смесей. KMeans можно рассматривать как частный случай модели гауссовой смеси с одинаковой ковариацией для каждой компоненты.
Трансдуктивные методы кластеризации (в отличие от индуктивных методов кластеризации) не предназначены для работы с новыми, ранее не встречавшимися данными.
Примеры
- Индуктивная кластеризация: пример индуктивной модели кластеризации для работы с новыми данными.
2.3.2. K-means
Алгоритм KMeans выполняет кластеризацию данных, пытаясь разделить образцы на n групп с одинаковой дисперсией и минимизируя критерий, известный как инерция или сумма квадратов расстояний внутри кластеров (см. ниже). Для этого алгоритма необходимо задать число кластеров. Он хорошо масштабируется при большом числе образцов и применяется в самых разных областях.
Алгоритм k-means делит набор из \(N\) образцов \(X\) на \(K\) непересекающихся кластеров \(C\), каждый из которых описывается средним значением \(\mu_j\) образцов в кластере. Эти средние обычно называют «центроидами» кластеров; следует отметить, что в общем случае они не являются точками из \(X\), хотя и принадлежат тому же пространству.
Алгоритм K-means стремится выбрать центроиды, минимизирующие инерцию, или критерий суммы квадратов расстояний внутри кластеров:
Инерцию можно рассматривать как меру внутренней согласованности кластеров. У неё есть несколько недостатков:
- Инерция предполагает, что кластеры выпуклые и изотропные, что верно не всегда. Она плохо работает с вытянутыми кластерами и многообразиями неправильной формы.
- Инерция не является нормированной метрикой: мы знаем лишь, что меньшие значения лучше, а оптимальное значение равно нулю. Однако в пространствах очень высокой размерности евклидовы расстояния имеют тенденцию увеличиваться (это один из аспектов так называемого «проклятия размерности»). Применение алгоритма снижения размерности, например анализа главных компонент (PCA), перед кластеризацией k-means может смягчить эту проблему и ускорить вычисления.

Более подробное описание показанных выше проблем и способов их решения см. в примерах Иллюстрация предположений k-means и Выбор числа кластеров с помощью анализа силуэта при кластеризации KMeans.
K-means часто называют алгоритмом Ллойда. В упрощённом виде алгоритм состоит из трёх шагов. На первом шаге выбираются начальные центроиды; самый простой способ — выбрать \(k\) образцов из набора данных \(X\). После инициализации K-means циклически выполняет два следующих шага. Сначала каждый образец назначается ближайшему центроиду. Затем вычисляются новые центроиды — средние значения всех образцов, назначенных каждому из предыдущих центроидов. Вычисляется разница между старыми и новыми центроидами, и алгоритм повторяет эти два шага, пока это значение не станет меньше порогового. Иными словами, повторение продолжается, пока центроиды не перестанут заметно перемещаться.

K-means эквивалентен алгоритму максимизации ожидания с малой диагональной матрицей ковариации, одинаковой для всех компонент.
Алгоритм также можно объяснить с помощью понятия диаграмм Вороного. Сначала по текущим центроидам строится диаграмма Вороного для точек. Каждый сегмент диаграммы Вороного становится отдельным кластером. Затем центроиды обновляются и становятся средними значениями точек в каждом сегменте. Алгоритм повторяет эти действия до выполнения критерия остановки. Обычно алгоритм останавливается, когда относительное уменьшение целевой функции между итерациями становится меньше заданного значения допуска. В данной реализации это не так: итерации прекращаются, когда перемещение центроидов становится меньше допуска.
При достаточном времени K-means всегда сойдётся, однако результатом может стать локальный минимум. Это в значительной степени зависит от инициализации центроидов. Поэтому вычисления часто выполняются несколько раз с разными начальными центроидами. Один из способов решить эту проблему — схема инициализации k-means++, реализованная в scikit-learn (используйте параметр init='k-means++'). При такой инициализации центроиды, как правило, располагаются на некотором расстоянии друг от друга, что обычно даёт лучшие результаты, чем случайная инициализация, как показано в источнике. Подробные примеры сравнения различных схем инициализации см. в разделах Демонстрация кластеризации K-Means на наборе данных рукописных цифр и Эмпирическая оценка влияния инициализации k-means.
K-means++ также можно вызвать независимо, чтобы выбрать начальные точки для других алгоритмов кластеризации; подробности и примеры использования см. в описании sklearn.cluster.kmeans_plusplus.
Алгоритм поддерживает веса образцов, задаваемые параметром sample_weight. Это позволяет придавать некоторым образцам больший вес при вычислении центров кластеров и значений инерции. Например, присвоение образцу веса 2 эквивалентно добавлению его дубликата в набор данных \(X\).
Примеры
-
Кластеризация текстовых документов с помощью k-means: кластеризация документов с помощью
KMeansиMiniBatchKMeansна основе разреженных данных - Пример инициализации K-Means++: использование K-means++ для выбора начальных точек для других алгоритмов кластеризации.
2.3.2.1. Низкоуровневый параллелизм
KMeans использует параллелизм на основе OpenMP через Cython. Небольшие блоки данных (256 образцов) обрабатываются параллельно, что также позволяет снизить потребление памяти. Подробнее об управлении числом потоков см. в примечаниях о параллелизме.
Примеры
- Иллюстрация предположений k-means: демонстрация случаев, когда k-means работает ожидаемым образом, и случаев, когда это не так
- Демонстрация кластеризации K-Means на наборе данных рукописных цифр: кластеризация рукописных цифр
Литература
- «k-means++: преимущества тщательного выбора начальных точек» Артур, Дэвид и Сергей Васильвицкий, Материалы восемнадцатого ежегодного симпозиума ACM-SIAM по дискретным алгоритмам, Общество промышленной и прикладной математики (2007)
2.3.2.2. Мини-пакетный K-Means
MiniBatchKMeans — это вариант алгоритма KMeans, который использует мини-пакеты для сокращения времени вычислений, одновременно стремясь оптимизировать ту же целевую функцию. Мини-пакеты — это подмножества входных данных, случайно выбираемые на каждой итерации обучения. Они значительно сокращают объём вычислений, необходимый для сходимости к локальному решению. В отличие от других алгоритмов, сокращающих время сходимости k-means, мини-пакетный k-means обычно даёт результаты лишь немного хуже стандартного алгоритма.
Алгоритм циклически выполняет два основных шага, как и обычный k-means. На первом шаге из набора данных случайным образом выбираются \(b\) образцов, образующих мини-пакет. Затем каждый из них назначается ближайшему центроиду. На втором шаге обновляются центроиды. В отличие от k-means, это делается отдельно для каждого образца. Для каждого образца мини-пакета назначенный ему центроид обновляется с помощью потокового среднего этого образца и всех предыдущих образцов, назначенных данному центроиду. В результате скорость изменения центроида со временем уменьшается. Эти шаги выполняются до сходимости или достижения заранее заданного числа итераций.
MiniBatchKMeans сходится быстрее, чем KMeans, однако качество результатов ниже. На практике эта разница в качестве может быть весьма небольшой, как показано в примере и цитируемом источнике.

Примеры
-
Сравнение алгоритмов кластеризации K-Means и MiniBatchKMeans: сравнение
KMeansиMiniBatchKMeans -
Кластеризация текстовых документов с помощью k-means: кластеризация документов с помощью
KMeansиMiniBatchKMeansна основе разреженных данных - Онлайн-обучение словаря частей лиц
Литература
- «Кластеризация K-Means в веб-масштабе» Д. Скалли, Материалы 19-й международной конференции по Всемирной паутине (2010).
2.3.3. Распространение близости
AffinityPropagation формирует кластеры, передавая сообщения между парами образцов до сходимости. Затем набор данных описывается небольшим числом примеров, выбранных как наиболее репрезентативные для других образцов. Сообщения, передаваемые между парами, отражают пригодность одного образца быть примером для другого; их значения обновляются с учётом значений других пар. Обновление выполняется итеративно до сходимости, после чего выбираются окончательные примеры и формируется итоговая кластеризация.

Распространение близости может быть полезно тем, что число кластеров определяется на основе предоставленных данных. Для этого важны два параметра: предпочтение, управляющее числом используемых примеров, и коэффициент демпфирования, который ослабляет сообщения ответственности и доступности, чтобы избежать численных колебаний при их обновлении.
Главный недостаток распространения близости — его вычислительная сложность. Временная сложность алгоритма составляет порядка \(O(N^2 T)\), где \(N\) — число образцов, а \(T\) — число итераций до сходимости. Кроме того, сложность по памяти составляет порядка \(O(N^2)\) при использовании плотной матрицы сходства, но уменьшается при использовании разреженной матрицы сходства. Поэтому распространение близости лучше всего подходит для наборов данных малого и среднего размера.
Описание алгоритма
Сообщения, передаваемые между точками, относятся к одной из двух категорий. Первая — ответственность \(r(i, k)\), то есть накопленное свидетельство того, что образец \(k\) должен быть примером для образца \(i\). Вторая — доступность \(a(i, k)\), то есть накопленное свидетельство того, что образец \(i\) должен выбрать образец \(k\) в качестве своего примера; при этом учитываются значения для всех остальных образцов, для которых \(k\) может быть примером. Таким образом, образцы выбирают примеры, если те (1) достаточно похожи на многие образцы и (2) выбраны многими образцами в качестве их представителей.
Формально ответственность образца \(k\) за то, чтобы быть примером для образца \(i\), задаётся выражением:
Здесь \(s(i, k)\) — сходство между образцами \(i\) и \(k\). Доступность образца \(k\) в качестве примера для образца \(i\) задаётся выражением:
Изначально все значения \(r\) и \(a\) равны нулю, а вычисления повторяются до сходимости. Как упоминалось выше, чтобы избежать численных колебаний при обновлении сообщений, в процесс итераций вводится коэффициент демпфирования \(\lambda\):
где \(t\) обозначает номер итерации.
Примеры
- Демонстрация алгоритма кластеризации с распространением близости: распространение близости на синтетическом наборе двумерных данных с 3 классами
- Визуализация структуры фондового рынка Распространение близости на финансовых временных рядах для поиска групп компаний
2.3.4. Сдвиг среднего
MeanShift кластеризация предназначена для обнаружения областей в гладком распределении плотности образцов. Это алгоритм на основе центроидов, который работает, обновляя кандидатов в центроиды, чтобы они соответствовали среднему значению точек в заданной области. Затем эти кандидаты фильтруются на этапе постобработки, чтобы устранить близкие дубликаты и сформировать итоговый набор центроидов.
Математические подробности
Положение кандидатов в центроиды итеративно корректируется с помощью метода, называемого восхождением на холм, который находит локальные максимумы оценённой плотности вероятности. Для кандидата в центроиды \(x\) на итерации \(t\) кандидат обновляется согласно следующему уравнению:
Здесь \(m\) — вектор сдвига среднего, вычисляемый для каждого центроида и направленный в область максимального увеличения плотности точек. Для вычисления \(m\) определим \(N(x)\) как множество образцов в окрестности на заданном расстоянии от \(x\). Тогда \(m\) вычисляется по следующему уравнению, фактически обновляя центроид так, чтобы он совпадал со средним значением образцов в его окрестности:
В общем случае уравнение для \(m\) зависит от ядра, используемого для оценки плотности. Общая формула имеет вид:
В нашей реализации \(K(x)\) равно 1, если \(x\) достаточно мало, и 0 в противном случае. Фактически \(K(y - x)\) показывает, находится ли \(y\) в окрестности \(x\).
Алгоритм автоматически определяет количество кластеров, не полагаясь на параметр bandwidth, который задаёт размер области поиска. Этот параметр можно задать вручную, но его также можно оценить с помощью предоставленной функции estimate_bandwidth, вызываемой, если ширина полосы не задана.
Алгоритм плохо масштабируется, поскольку во время выполнения ему требуется выполнять несколько поисков ближайших соседей. Алгоритм гарантированно сходится, однако прекращает итерации, когда изменения центроидов становятся незначительными.
Новая выборка получает метку посредством поиска ближайшего центроида.

Примеры
- Демонстрация алгоритма кластеризации сдвигом среднего: кластеризация сдвигом среднего на синтетических двумерных наборах данных с 3 классами.
Ссылки
- «Сдвиг среднего: надёжный подход к анализу пространства признаков» Д. Команичиу и П. Меер, IEEE Transactions on Pattern Analysis and Machine Intelligence (2002)
2.3.5. Спектральная кластеризация
SpectralClustering выполняет низкоразмерное вложение матрицы близости между образцами, а затем кластеризацию, например с помощью KMeans, компонент собственных векторов в низкоразмерном пространстве. Этот метод особенно эффективен с вычислительной точки зрения, если матрица близости разрежена и для задачи нахождения собственных значений используется решатель amg (обратите внимание: для решателя amg требуется установленный модуль pyamg).
Текущая версия SpectralClustering требует заранее указать количество кластеров. Метод хорошо работает с небольшим количеством кластеров, но не рекомендуется для большого их числа.
Для двух кластеров SpectralClustering решает выпуклую релаксацию задачи нормализованных разрезов на графе сходства: разделяет граф на две части так, чтобы вес разрезанных рёбер был мал по сравнению с весами рёбер внутри каждого кластера. Этот критерий особенно интересен при работе с изображениями, где вершинами графа являются пиксели, а веса рёбер графа сходства вычисляются с помощью функции от градиента изображения.


Предупреждение
Преобразование расстояний в корректные меры сходства
Обратите внимание: если значения вашей матрицы сходства распределены некорректно, например присутствуют отрицательные значения или вместо матрицы сходства используется матрица расстояний, спектральная задача будет вырожденной и неразрешимой. В этом случае рекомендуется преобразовать элементы матрицы. Например, для матрицы расстояний со знаковыми значениями обычно применяют тепловое ядро:
similarity = np.exp(-beta * distance / distance.std())
Примеры такого применения приведены в соответствующих разделах.
Примеры
- Спектральная кластеризация для сегментации изображений: выделение объектов на зашумлённом фоне с помощью спектральной кластеризации.
- Разделение изображения греческих монет на области: спектральная кластеризация для разделения изображения монет на области.
2.3.5.1. Различные стратегии назначения меток
Можно использовать разные стратегии назначения меток, соответствующие параметру assign_labels объекта SpectralClustering. Стратегия "kmeans" позволяет учитывать более мелкие детали, но может быть нестабильной. В частности, если не контролировать random_state, результаты могут различаться при каждом запуске, поскольку они зависят от случайной инициализации. Альтернативная стратегия "discretize" полностью воспроизводима, но обычно создаёт области довольно равномерной и геометрически правильной формы. Недавно добавленный параметр "cluster_qr" — это детерминированная альтернатива, которая в приведённом ниже примере обычно обеспечивает визуально наилучшее разбиение.
|
|
|
|---|---|---|
|
|
|


Ссылки
- «Многоклассовая спектральная кластеризация» Стелла Ю и Цзяньбо Ши, 2003
- «Простая, прямая и эффективная многопутевая спектральная кластеризация» Анил Дамле, Виктор Минден, Лексинг Ин, 2019
2.3.5.2. Спектральная кластеризация графов
Спектральную кластеризацию также можно использовать для разбиения графов с помощью их спектральных вложений. В этом случае матрицей близости является матрица смежности графа, а SpectralClustering инициализируется с помощью affinity='precomputed':
>>> from sklearn.cluster import SpectralClustering
>>> sc = SpectralClustering(3, affinity='precomputed', n_init=100,
...                         assign_labels='discretize')
>>> sc.fit_predict(adjacency_matrix)
Ссылки
- «Введение в спектральную кластеризацию» Ульрике фон Люксбург, 2007
- «Нормализованные разрезы и сегментация изображений» Цзяньбо Ши, Джитендра Малик, 2000
- «Спектральная сегментация с точки зрения случайных блужданий» Марина Мейла, Цзяньбо Ши, 2001
- «О спектральной кластеризации: анализ и алгоритм» Эндрю Нг, Майкл Джордан, Яир Вайс, 2001
- «Предобусловленная спектральная кластеризация для задачи потоковой обработки графов со стохастическим блочным разбиением» Дэвид Жужунашвили, Эндрю Князев
2.3.6. Иерархическая кластеризация
Иерархическая кластеризация — это общее семейство алгоритмов кластеризации, которые формируют вложенные кластеры, последовательно объединяя или разделяя их. Такая иерархия кластеров представляется в виде дерева (или дендрограммы). Корень дерева — единственный кластер, включающий все образцы, а листья — кластеры, содержащие по одному образцу. Дополнительные сведения см. на странице Википедии.
Объект AgglomerativeClustering выполняет иерархическую кластеризацию снизу вверх: каждое наблюдение сначала образует собственный кластер, а затем кластеры последовательно объединяются. Критерий объединения определяет метрику, используемую для выбора стратегии слияния:
- Ward минимизирует сумму квадратов отклонений внутри всех кластеров. Это подход, минимизирующий дисперсию, и в этом смысле он похож на целевую функцию k-means, но реализуется с помощью агломеративного иерархического подхода.
- Максимальная или полная связь минимизирует максимальное расстояние между наблюдениями из пар кластеров.
- Средняя связь минимизирует среднее расстояние между всеми наблюдениями из пар кластеров.
- Одиночная связь минимизирует расстояние между ближайшими наблюдениями из пар кластеров.
AgglomerativeClustering также масштабируется на большое количество образцов при совместном использовании с матрицей связности, но без ограничений связности между образцами этот метод требует больших вычислительных затрат: на каждом шаге он рассматривает все возможные слияния.
2.3.6.1. Различные типы связи: Ward, полная, средняя и одиночная связь
AgglomerativeClustering поддерживает стратегии связи Ward, одиночную, среднюю и полную.

Для агломеративной кластеризации характерен эффект «богатые становятся богаче», приводящий к неравномерным размерам кластеров. В этом отношении одиночная связь — худшая стратегия, а Ward обеспечивает наиболее равномерные размеры. Однако при использовании Ward нельзя менять меру близости (или расстояние, используемое при кластеризации), поэтому для неевклидовых метрик хорошей альтернативой является средняя связь. Одиночная связь, хотя и неустойчива к зашумлённым данным, вычисляется очень эффективно и поэтому может быть полезна для иерархической кластеризации больших наборов данных. Одиночная связь также может хорошо работать с неглобулярными данными.
Примеры
-
Различные варианты агломеративной кластеризации двумерного вложения цифр: изучение различных стратегий связи на реальном наборе данных.
- Сравнение различных методов иерархической кластеризации с разными типами связи на тестовых наборах данных: изучение различных стратегий связи на тестовых наборах данных.
2.3.6.2. Визуализация иерархии кластеров
Дерево, представляющее иерархическое объединение кластеров, можно визуализировать в виде дендрограммы. Визуальный анализ часто помогает понять структуру данных, особенно если размер выборки невелик.

Примеры
2.3.6.3. Добавление ограничений связности
Интересная особенность AgglomerativeClustering заключается в возможности добавлять в алгоритм ограничения связности (можно объединять только соседние кластеры) с помощью матрицы связности, которая определяет для каждого образца соседние образцы в соответствии с заданной структурой данных. Например, в приведённом ниже примере со швейцарским рулетом ограничения связности запрещают объединять точки, не являющиеся соседними на поверхности рулета, и таким образом позволяют избежать образования кластеров, проходящих через перекрывающиеся витки рулета.


Эти ограничения полезны не только для задания определённой локальной структуры, но и для ускорения алгоритма, особенно при большом количестве образцов.
Ограничения связности задаются с помощью матрицы связности: разреженной матрицы scipy, ненулевые элементы которой расположены только на пересечении строк и столбцов с индексами связанных элементов набора данных. Эту матрицу можно построить на основе априорной информации: например, можно кластеризовать веб-страницы, объединяя только те страницы, между которыми есть ссылка. Её также можно построить на основе данных, например с помощью sklearn.neighbors.kneighbors_graph, чтобы ограничить слияние ближайшими соседями, как в этом примере, или с помощью sklearn.feature_extraction.image.grid_to_graph, разрешая объединять только соседние пиксели изображения, как в примере с монетами.
Предупреждение
Ограничения связности при одиночной, средней и полной связи
Ограничения связности в сочетании с одиночной, полной или средней связью могут усиливать эффект «богатые становятся богаче» в агломеративной кластеризации, особенно если они строятся с помощью sklearn.neighbors.kneighbors_graph. При малом количестве кластеров обычно образуется несколько очень крупных кластеров и почти пустые кластеры (см. обсуждение в разделе Иерархическая кластеризация со структурой и без неё). Одиночная связь — наиболее чувствительный к этой проблеме вариант.

Примеры
- Демонстрация структурированной иерархической кластеризации Ward на изображении монет: кластеризация Ward для разделения изображения монет на области.
- Иерархическая кластеризация со структурой и без неё: пример работы алгоритма Ward со швейцарским рулетом, сравнение структурированных и неструктурированных подходов.
- Агломерация признаков и отбор отдельных признаков: пример снижения размерности с помощью агломерации признаков на основе иерархической кластеризации Ward.
2.3.6.4. Изменение метрики
Одиночную, среднюю и полную связь можно использовать с различными расстояниями (или мерами близости), в частности с евклидовым расстоянием (l2), расстоянием Манхэттена (или Cityblock, или l1), косинусным расстоянием либо с предварительно вычисленной матрицей близости.
- Расстояние l1 часто хорошо подходит для разреженных признаков или разреженного шума, то есть когда многие признаки равны нулю, как при анализе текстов с использованием частот редких слов.
- Косинусное расстояние cosine интересно тем, что оно инвариантно относительно глобального масштабирования сигнала.
При выборе метрики рекомендуется использовать ту, которая максимизирует расстояния между образцами разных классов и минимизирует расстояния между образцами внутри каждого класса.


Примеры
2.3.6.5. Бисекция K-Means
Объект BisectingKMeans — это итеративный вариант KMeans, использующий дивизивную иерархическую кластеризацию. Вместо одновременного создания всех центроидов они выбираются последовательно на основе предыдущей кластеризации: кластер повторно разделяется на два новых кластера, пока не будет достигнуто требуемое количество кластеров.
BisectingKMeans эффективнее, чем KMeans, при большом количестве кластеров, поскольку на каждом этапе деления он работает только с подмножеством данных, тогда как KMeans всегда работает со всем набором данных.
Хотя BisectingKMeans по своей конструкции не может использовать преимущества инициализации "k-means++", он всё же обеспечивает результаты по инерции, сопоставимые с KMeans(init="k-means++"), при меньших вычислительных затратах и, вероятно, даёт лучшие результаты, чем KMeans со случайной инициализацией.
Этот вариант эффективнее агломеративной кластеризации, если количество кластеров невелико по сравнению с количеством точек данных.
Кроме того, этот вариант не создаёт пустых кластеров.
- Существуют две стратегии выбора кластера для разделения:
-
-
bisecting_strategy="largest_cluster"выбирает кластер с наибольшим количеством точек -
bisecting_strategy="biggest_inertia"выбирает кластер с наибольшей инерцией (кластер с наибольшей суммой квадратов ошибок внутри)
-
Выбор кластера с наибольшим количеством точек в большинстве случаев даёт результат такой же точности, как и выбор по инерции, и выполняется быстрее (особенно для больших наборов данных, где вычисление ошибки может быть затратным).
Выбор кластера с наибольшим количеством точек также, вероятно, приведёт к кластерам похожих размеров, тогда как известно, что KMeans создаёт кластеры разных размеров.
Различия между Bisecting K-Means и обычным K-Means можно увидеть в примере Сравнение производительности Bisecting K-Means и обычного K-Means. Обычный алгоритм K-Means обычно создаёт несвязанные кластеры, тогда как кластеры Bisecting K-Means упорядочены и образуют хорошо заметную иерархию.
Ссылки
- «Сравнение методов кластеризации документов» Майкл Стайнбах, Джордж Карипис и Випин Кумар, кафедра компьютерных наук и инженерии Университета Миннесоты (июнь 2000 г.)
- «Анализ производительности алгоритмов K-Means и Bisecting K-Means на данных веб-журналов» К. Абирами и д-р П. Майилваханан, International Journal of Emerging Technologies in Engineering Research (IJETER), том 4, выпуск 8 (август 2016 г.)
- «Алгоритм Bisecting K-means на основе самоопределения по K значениям и оптимизации центра кластеризации» Цзянь Ди, Синьюэ Гоу, факультет управления и компьютерной инженерии Северо-Китайского электроэнергетического университета, Баодин, Хэбэй, Китай (август 2017 г.)
2.3.7. DBSCAN
Алгоритм DBSCAN рассматривает кластеры как области высокой плотности, разделённые областями низкой плотности. Благодаря такому довольно общему подходу кластеры, обнаруженные DBSCAN, могут иметь любую форму, в отличие от k-means, который предполагает, что кластеры имеют выпуклую форму. Центральным понятием DBSCAN являются опорные точки — точки, находящиеся в областях высокой плотности. Таким образом, кластер представляет собой набор опорных точек, каждая из которых находится близко к другим (расстояние измеряется некоторой метрикой), и набор неопорных точек, расположенных близко к опорной точке (но сами опорными точками не являющихся). Алгоритм имеет два параметра, min_samples и eps, которые формально определяют, что мы подразумеваем под плотной областью. Более высокое значение min_samples или более низкое значение eps указывают на то, что для формирования кластера необходима более высокая плотность.
Если говорить более формально, опорной точкой считается точка набора данных, для которой в пределах расстояния eps существует не менее min_samples других точек; они называются соседями этой опорной точки. Это означает, что опорная точка находится в плотной области векторного пространства. Кластер — это набор опорных точек, который можно построить рекурсивно: взять опорную точку, найти всех её соседей, которые являются опорными точками, найти всех их соседей, которые являются опорными точками, и так далее. В кластер также входит набор неопорных точек — точек, которые являются соседями опорной точки кластера, но сами не являются опорными точками. Интуитивно такие точки находятся на периферии кластера.
По определению любая опорная точка является частью кластера. Любая точка, которая не является опорной и находится на расстоянии не менее eps от любой опорной точки, считается алгоритмом выбросом.
Параметр min_samples в первую очередь определяет, насколько алгоритм устойчив к шуму (для зашумлённых и больших наборов данных может быть желательно увеличить этот параметр), тогда как параметр eps крайне важно выбрать подходящим образом для набора данных и функции расстояния; обычно его нельзя оставлять равным значению по умолчанию. Он определяет локальную окрестность точек. Если выбрать слишком малое значение, большая часть данных вообще не будет кластеризована (и будет помечена как -1 — «шум»). Если выбрать слишком большое значение, близкие кластеры сольются в один, а в конечном итоге весь набор данных будет возвращён как единый кластер. В литературе обсуждались некоторые эвристики выбора этого параметра, например основанные на точке перегиба графика расстояний до ближайших соседей (см. обсуждение в приведённых ниже источниках).
На рисунке ниже цвет обозначает принадлежность к кластеру, а большие круги соответствуют опорным точкам, найденным алгоритмом. Маленькие круги — это неопорные точки, которые всё же являются частью кластера. Выбросы обозначены чёрными точками внизу.

Примеры
Реализация
Алгоритм DBSCAN детерминирован: для одних и тех же данных в одном и том же порядке он всегда генерирует одинаковые кластеры. Однако результаты могут отличаться, если данные переданы в другом порядке. Во-первых, хотя опорные точки всегда будут отнесены к одним и тем же кластерам, метки этих кластеров зависят от порядка, в котором эти точки встречаются в данных. Во-вторых, что ещё важнее, кластер, к которому относятся неопорные точки, может зависеть от порядка данных. Это происходит, если неопорная точка находится на расстоянии меньше eps от двух опорных точек из разных кластеров. Из неравенства треугольника следует, что расстояние между этими двумя опорными точками должно быть больше eps, иначе они принадлежали бы одному кластеру. Неопорная точка относится к кластеру, который первым формируется при проходе по данным, поэтому результат зависит от порядка данных.
Текущая реализация использует деревья сфер и kd-деревья для определения окрестностей точек, что позволяет избежать вычисления полной матрицы расстояний (как это делалось в версиях scikit-learn до 0.14). Возможность использовать пользовательские метрики сохранена; подробности см. в NearestNeighbors.
Потребление памяти для больших наборов выборок
По умолчанию эта реализация неэффективна с точки зрения использования памяти, поскольку строит полную матрицу попарного сходства в случаях, когда невозможно использовать kd-деревья или деревья сфер (например, для разреженных матриц). Эта матрица занимает \(n^2\) чисел с плавающей точкой. Обойти это ограничение можно несколькими способами:
- Использовать кластеризацию OPTICS вместе с методом
extract_dbscan. Кластеризация OPTICS также вычисляет полную матрицу попарных расстояний, но одновременно хранит в памяти только одну строку (сложность по памяти \(\mathcal{O}(n)\)). - Можно предварительно вычислить разреженный граф окрестностей радиуса (отсутствующие элементы считаются находящимися за пределами eps) эффективным с точки зрения памяти способом и запустить dbscan для него с помощью
metric='precomputed'. См.sklearn.neighbors.NearestNeighbors.radius_neighbors_graph. - Набор данных можно сжать, удалив точные дубликаты, если они есть, или используя BIRCH. Тогда для большого количества точек останется лишь относительно небольшое число представителей. При обучении DBSCAN можно передать
sample_weight.
Литература
- Алгоритм на основе плотности для обнаружения кластеров в больших пространственных базах данных с шумом Ester, M., H. P. Kriegel, J. Sander и X. Xu. В сборнике трудов 2-й Международной конференции по обнаружению знаний и интеллектуальному анализу данных, Портленд, штат Орегон, AAAI Press, с. 226–231. 1996.
- DBSCAN: повторное рассмотрение — почему и как следует (по-прежнему) использовать DBSCAN. Schubert, E., Sander, J., Ester, M., Kriegel, H. P. и Xu, X. (2017). В ACM Transactions on Database Systems (TODS), 42(3), 19.
2.3.8. HDBSCAN
Алгоритм HDBSCAN можно рассматривать как расширение DBSCAN и OPTICS. В частности, DBSCAN предполагает, что критерий кластеризации (то есть требование к плотности) однороден во всём пространстве. Иными словами, DBSCAN может испытывать трудности при обнаружении кластеров с разной плотностью. HDBSCAN снимает это ограничение и исследует все возможные уровни плотности, строя альтернативное представление задачи кластеризации.
Примечание
Эта реализация основана на оригинальной реализации HDBSCAN из scikit-learn-contrib/hdbscan, созданной на основе [LJ2017].
Примеры
2.3.8.1. Граф взаимной достижимости
Сначала HDBSCAN определяет \(d_c(x_p)\) — основное расстояние точки выборки \(x_p\) как расстояние до её min_samples-го ближайшего соседа, включая саму точку. Например, если min_samples=5 и \(x_*\) — 5-й ближайший сосед \(x_p\), то основное расстояние равно:
Затем определяется \(d_m(x_p, x_q)\) — расстояние взаимной достижимости двух точек \(x_p, x_q\):
Эти два понятия позволяют построить граф взаимной достижимости \(G_{ms}\), определённый для фиксированного значения min_samples: каждой точке выборки \(x_p\) сопоставляется вершина графа, а рёбра между точками \(x_p, x_q\) имеют вес, равный расстоянию взаимной достижимости \(d_m(x_p, x_q)\) между ними. Можно построить подграфы этого графа, обозначаемые \(G_{ms,\varepsilon}\), удалив все рёбра со значением больше \(\varepsilon\): из исходного графа. На этом этапе точки, основное расстояние которых меньше \(\varepsilon\): помечаются как шум. Оставшиеся точки кластеризуются путём нахождения компонент связности полученного графа.
Примечание
Нахождение компонент связности усечённого графа \(G_{ms,\varepsilon}\) эквивалентно запуску DBSCAN* с параметрами min_samples и \(\varepsilon\). DBSCAN* — это слегка модифицированная версия DBSCAN, упомянутая в [CM2013].
2.3.8.2. Иерархическая кластеризация
HDBSCAN можно рассматривать как алгоритм, выполняющий кластеризацию DBSCAN* для всех значений \(\varepsilon\). Как отмечалось выше, это эквивалентно нахождению компонент связности графов взаимной достижимости для всех значений \(\varepsilon\). Для эффективного выполнения этой операции HDBSCAN сначала извлекает минимальное остовное дерево (MST) из полностью связного графа взаимной достижимости, а затем жадно удаляет рёбра с наибольшими весами. Алгоритм HDBSCAN в общих чертах выглядит следующим образом:
- Извлечь MST графа \(G_{ms}\).
- Расширить MST, добавив для каждой вершины «петлю» с весом, равным основному расстоянию соответствующей точки выборки.
- Инициализировать для MST один кластер и одну метку.
- Удалить из MST ребро с наибольшим весом (рёбра с одинаковым весом удаляются одновременно).
- Назначить метки кластеров компонентам связности, содержащим концы удалённого ребра. Если в компоненте нет хотя бы одного ребра, вместо этого ей назначается метка «null», обозначающая шум.
- Повторять шаги 4–5, пока не останется компонент связности.
Таким образом, HDBSCAN позволяет иерархически получить все возможные разбиения, которые можно получить с помощью DBSCAN* для фиксированного значения min_samples. Это позволяет HDBSCAN выполнять кластеризацию при разных уровнях плотности, поэтому задавать \(\varepsilon\) как гиперпараметр больше не требуется. Вместо этого используется только значение min_samples, которое, как правило, является более устойчивым гиперпараметром.


HDBSCAN можно сгладить с помощью дополнительного гиперпараметра min_cluster_size, который задаёт, что во время иерархической кластеризации компоненты, содержащие менее minimum_cluster_size точек, считаются шумом. На практике можно задать minimum_cluster_size = min_samples, чтобы связать параметры и упростить пространство гиперпараметров.
Литература
Campello, R.J.G.B., Moulavi, D., Sander, J. (2013). Кластеризация на основе плотности с использованием иерархических оценок плотности. В: Pei, J., Tseng, V.S., Cao, L., Motoda, H., Xu, G. (ред.) Advances in Knowledge Discovery and Data Mining. PAKDD 2013. Lecture Notes in Computer Science(), т. 7819. Springer, Берлин, Гейдельберг. Кластеризация на основе плотности с использованием иерархических оценок плотности
L. McInnes и J. Healy, (2017). Ускоренная иерархическая кластеризация на основе плотности. В: IEEE International Conference on Data Mining Workshops (ICDMW), 2017, с. 33–42. Ускоренная иерархическая кластеризация на основе плотности
2.3.9. OPTICS
Алгоритм OPTICS во многом похож на алгоритм DBSCAN и может рассматриваться как обобщение DBSCAN, в котором требование eps заменено с одного значения на диапазон значений. Ключевое различие между DBSCAN и OPTICS состоит в том, что алгоритм OPTICS строит граф достижимости, который присваивает каждой точке как расстояние reachability_, так и позицию в кластере — атрибут ordering_; эти два атрибута назначаются при обучении модели и используются для определения принадлежности к кластеру. Если OPTICS запустить со значением inf по умолчанию для max_eps, извлечение кластеров в стиле DBSCAN можно многократно выполнять за линейное время для любого заданного значения eps с помощью метода cluster_optics_dbscan. Установка меньшего значения max_eps сокращает время выполнения; его можно рассматривать как максимальный радиус окрестности каждой точки для поиска других потенциально достижимых точек.

Расстояния достижимости, вычисляемые OPTICS, позволяют выделять кластеры с переменной плотностью в пределах одного набора данных. Как показано на графике выше, сочетание расстояний достижимости и ordering_ набора данных даёт график достижимости, на котором плотность точек представлена по оси Y, а точки упорядочены так, что близкие точки расположены рядом. «Срез» графика достижимости на одном уровне даёт результаты, похожие на DBSCAN: все точки выше «среза» классифицируются как шум, а каждый разрыв при чтении слева направо обозначает новый кластер. При извлечении кластеров OPTICS по умолчанию анализирует крутые склоны графика, чтобы найти кластеры; пользователь может задать, что считать крутым склоном, с помощью параметра xi. Возможны и другие способы анализа самого графика, например построение иерархического представления данных с помощью дендрограмм графика достижимости; иерархию кластеров, обнаруженных алгоритмом, можно получить через параметр cluster_hierarchy_. На графике выше цвета выбраны так, чтобы цвета кластеров в плоскости совпадали с цветами линейных сегментов кластеров на графике достижимости. Обратите внимание, что синий и красный кластеры соседствуют на графике достижимости и могут быть представлены иерархически как дочерние кластеры более крупного родительского кластера.
Примеры
Сравнение с DBSCAN
Результаты метода cluster_optics_dbscan алгоритма OPTICS и DBSCAN очень похожи, но не всегда идентичны; в частности, различаются метки периферийных точек и точек шума. Отчасти это связано с тем, что первые точки каждой плотной области, обрабатываемые OPTICS, имеют большое расстояние достижимости, хотя и находятся близко к другим точкам этой области, поэтому иногда помечаются как шум, а не как периферийные точки. Это влияет на соседние точки, когда их рассматривают как кандидатов для отнесения к периферийным точкам или шуму.
Обратите внимание: для любого фиксированного значения eps DBSCAN обычно работает быстрее OPTICS; однако при многократных запусках с разными значениями eps один запуск OPTICS может потребовать меньше суммарного времени, чем DBSCAN. Также важно отметить, что результаты OPTICS близки к результатам DBSCAN только в том случае, если eps и max_eps близки.
Вычислительная сложность
Для вычисления полной матрицы расстояний не используются деревья пространственной индексации, что позволяет эффективно расходовать память при работе с большими наборами точек. Различные метрики расстояния можно передать с помощью ключевого аргумента metric.
Для больших наборов данных похожих (но не идентичных) результатов можно добиться с помощью HDBSCAN. Реализация HDBSCAN многопоточна и имеет лучшую алгоритмическую временную сложность, чем OPTICS, но хуже масштабируется по памяти. Для чрезвычайно больших наборов данных, для которых при использовании HDBSCAN исчерпывается системная память, OPTICS сохраняет масштабирование памяти порядка \(n\) (в отличие от \(n^2\)); однако, вероятно, потребуется настроить параметр max_eps, чтобы получить решение за приемлемое время.
Литература
- «OPTICS: упорядочение точек для выявления структуры кластеризации». Ankerst, Mihael, Markus M. Breunig, Hans-Peter Kriegel и Jörg Sander. В ACM Sigmod Record, т. 28, № 2, с. 49–60. ACM, 1999.
2.3.10. BIRCH
Birch строит для заданных данных дерево, называемое деревом признаков кластеризации (Clustering Feature Tree, CFT). Данные по сути с потерями сжимаются до набора узлов признаков кластеризации (узлов CF). Узлы CF содержат несколько подкластеров, называемых подкластерами признаков кластеризации (подкластерами CF), а эти подкластеры CF, расположенные в нетерминальных узлах CF, могут иметь дочерние узлы CF.
Подкластеры CF содержат необходимую для кластеризации информацию, благодаря чему нет необходимости хранить все входные данные в памяти. Эта информация включает:
- Количество образцов в подкластере.
- Линейная сумма — n-мерный вектор, содержащий сумму всех образцов.
- Сумма квадратов — сумма квадратов L2-норм всех образцов.
- Центроиды — для того, чтобы избежать повторного вычисления линейной суммы / n_samples.
- Квадрат нормы центроидов.
У алгоритма BIRCH два параметра: порог и коэффициент ветвления. Коэффициент ветвления ограничивает число подкластеров в узле, а порог ограничивает расстояние между поступающим образцом и существующими подкластерами.
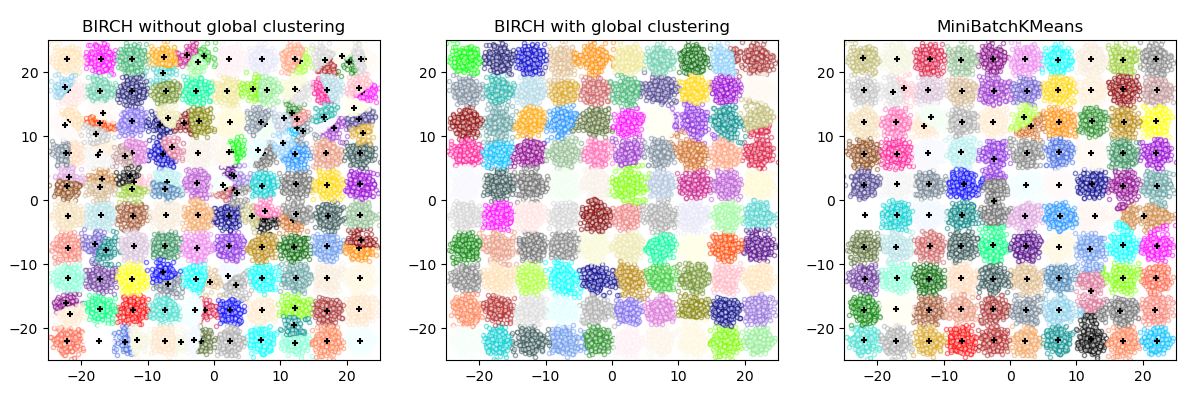
Этот алгоритм можно рассматривать как разновидность метода сокращения объёма данных, поскольку он сокращает входные данные до набора подкластеров, получаемых непосредственно из листьев CFT. Затем эти сокращённые данные можно обработать, передав их глобальному алгоритму кластеризации. Глобальный алгоритм кластеризации можно задать с помощью n_clusters. Если n_clusters имеет значение None, подкластеры считываются непосредственно из листьев; в противном случае глобальный этап кластеризации присваивает этим подкластерам метки глобальных кластеров, а образцы сопоставляются с меткой глобального кластера ближайшего подкластера.
Описание алгоритма
- Новый образец вставляется в корень дерева CF, который является узлом CF. Затем он объединяется с подкластером корня, у которого после объединения будет наименьший радиус, при соблюдении ограничений порога и коэффициента ветвления. Если у подкластера есть дочерний узел, процесс повторяется, пока не будет достигнут лист. После нахождения ближайшего подкластера в листе рекурсивно обновляются свойства этого подкластера и родительских подкластеров.
- Если радиус подкластера, полученного при объединении нового образца с ближайшим подкласетером, больше квадрата порога и число подкластеров превышает коэффициент ветвления, для нового образца временно выделяется место. Выбираются два наиболее удалённых подкластера, а остальные подкластеры делятся на две группы на основе расстояний между этими подкластерами.
- Если у разделённого узла есть родительский подкластер и имеется место для нового подкластера, родительский узел разделяется на два. Если места нет, этот узел снова разделяется на два, и процесс рекурсивно продолжается, пока не будет достигнут корень.
BIRCH или MiniBatchKMeans?
- BIRCH не очень хорошо масштабируется для данных высокой размерности. Как правило, если
n_featuresпревышает двадцать, лучше использовать MiniBatchKMeans. - Если необходимо сократить число экземпляров данных или получить большое число подкластеров — например, на этапе предварительной обработки, — BIRCH полезнее, чем MiniBatchKMeans.
Как использовать partial_fit?
Чтобы не выполнять глобальную кластеризацию при каждом вызове partial_fit, рекомендуется:
- Сначала задать
n_clusters=None. - Обучить модель на всех данных, многократно вызывая partial_fit.
- Задать требуемое значение для
n_clustersс помощьюbrc.set_params(n_clusters=n_clusters). - В конце вызвать
partial_fitбез аргументов, то естьbrc.partial_fit(), чтобы выполнить глобальную кластеризацию.
Ссылки
- Tian Zhang, Raghu Ramakrishnan, Maron Livny. BIRCH: эффективный метод кластеризации данных для больших баз данных. https://www.cs.sfu.ca/CourseCentral/459/han/papers/zhang96.pdf
- Roberto Perdisci. JBirch — реализация алгоритма кластеризации BIRCH на Java. https://code.google.com/archive/p/jbirch
2.3.11. Оценка качества кластеризации
Оценить качество алгоритма кластеризации не так просто, как подсчитать количество ошибок или точность и полноту алгоритма классификации с учителем. В частности, любая метрика оценки не должна учитывать абсолютные значения меток кластеров, а должна оценивать, определяет ли эта кластеризация разделение данных, сходное с некоторым эталонным набором классов, или удовлетворяет ли она предположению, согласно которому объекты одного класса более похожи друг на друга, чем объекты разных классов, согласно некоторой метрике сходства.
2.3.11.1. Индекс Рэнда
Если известны истинные назначения классов labels_true и назначения, полученные нашим алгоритмом кластеризации для тех же образцов labels_pred, (скорректированный или нескорректированный) индекс Рэнда — это функция, которая измеряет сходство двух назначений, не учитывая перестановки:
>>> from sklearn import metrics
>>> labels_true = [0, 0, 0, 1, 1, 1]
>>> labels_pred = [0, 0, 1, 1, 2, 2]
>>> metrics.rand_score(labels_true, labels_pred)
0.66
Индекс Рэнда не гарантирует, что при случайной разметке будет получено значение, близкое к 0.0. Скорректированный индекс Рэнда учитывает случайность и задаёт такую базовую оценку.
>>> metrics.adjusted_rand_score(labels_true, labels_pred)
0.24
Как и для всех метрик кластеризации, можно поменять местами 0 и 1 в предсказанных метках, переименовать 2 в 3 и получить ту же оценку:
>>> labels_pred = [1, 1, 0, 0, 3, 3]
>>> metrics.rand_score(labels_true, labels_pred)
0.66
>>> metrics.adjusted_rand_score(labels_true, labels_pred)
0.24
Кроме того, и rand_score, и adjusted_rand_score симметричны: перестановка аргументов не меняет оценки. Поэтому их можно использовать как меры согласованности:
>>> metrics.rand_score(labels_pred, labels_true)
0.66
>>> metrics.adjusted_rand_score(labels_pred, labels_true)
0.24
Идеальная разметка получает оценку 1.0:
>>> labels_pred = labels_true[:]
>>> metrics.rand_score(labels_true, labels_pred)
1.0
>>> metrics.adjusted_rand_score(labels_true, labels_pred)
1.0
Для плохо согласующихся меток (например, независимых разметок) оценки ниже, а для скорректированного индекса Рэнда оценка будет отрицательной или близкой к нулю. Однако для нескорректированного индекса Рэнда оценка, хотя и будет ниже, не обязательно окажется близкой к нулю:
>>> labels_true = [0, 0, 0, 0, 0, 0, 1, 1]
>>> labels_pred = [0, 1, 2, 3, 4, 5, 5, 6]
>>> metrics.rand_score(labels_true, labels_pred)
0.39
>>> metrics.adjusted_rand_score(labels_true, labels_pred)
-0.072
Примеры
- Коррекция на случайность при оценке качества кластеризации: анализ влияния размера набора данных на значения метрик кластеризации для случайных назначений.
Математическая формулировка
Пусть C — назначение истинных классов, а K — результат кластеризации. Определим \(a\) и \(b\) следующим образом:
- \(a\) — количество пар элементов, принадлежащих одному и тому же множеству в C и одному и тому же множеству в K
- \(b\) — количество пар элементов, принадлежащих разным множествам в C и разным множествам в K
Тогда нескорректированный индекс Рэнда задаётся формулой:
где \(C_2^{n_{samples}}\) — общее количество возможных пар в наборе данных. Не имеет значения, выполняется ли вычисление для упорядоченных или неупорядоченных пар, если во всех случаях оно выполняется согласованно.
Однако индекс Рэнда не гарантирует, что случайные назначения меток дадут значение, близкое к нулю (особенно если количество кластеров имеет тот же порядок величины, что и количество образцов).
Чтобы устранить этот эффект, можно вычесть ожидаемое значение RI \(E[\text{RI}]\) для случайных разметок, определив скорректированный индекс Рэнда следующим образом:
Ссылки
- Сравнение разбиений L. Hubert и P. Arabie, Journal of Classification, 1985
- Свойства скорректированного индекса Рэнда Hubert—Arabie D. Steinley, Psychological Methods, 2004
- Статья об индексе Рэнда в Википедии
- Минимальный скорректированный индекс Рэнда для двух кластеризаций заданного размера, 2022, J. E. Chacón и A. I. Rastrojo
2.3.11.2. Оценки на основе взаимной информации
Если известны истинные назначения классов labels_true и назначения, полученные нашим алгоритмом кластеризации для тех же образцов labels_pred, взаимная информация — это функция, которая измеряет согласие двух назначений, не учитывая перестановки. Доступны две нормализованные версии этой меры: нормализованная взаимная информация (NMI) и скорректированная взаимная информация (AMI). NMI часто используется в литературе, тогда как AMI была предложена позднее и нормализована с учётом случайности:
>>> from sklearn import metrics
>>> labels_true = [0, 0, 0, 1, 1, 1]
>>> labels_pred = [0, 0, 1, 1, 2, 2]

>>> metrics.adjusted_mutual_info_score(labels_true, labels_pred)
0.22504
Можно поменять местами 0 и 1 в предсказанных метках, переименовать 2 в 3 и получить ту же оценку:
>>> labels_pred = [1, 1, 0, 0, 3, 3]
>>> metrics.adjusted_mutual_info_score(labels_true, labels_pred)
0.22504
Все три меры — mutual_info_score, adjusted_mutual_info_score и normalized_mutual_info_score — симметричны: перестановка аргументов не меняет оценку. Поэтому их можно использовать как меры согласованности:
>>> metrics.adjusted_mutual_info_score(labels_pred, labels_true)
0.22504
Идеальная разметка получает оценку 1.0:
>>> labels_pred = labels_true[:]
>>> metrics.adjusted_mutual_info_score(labels_true, labels_pred)
1.0

>>> metrics.normalized_mutual_info_score(labels_true, labels_pred)
1.0
Для mutual_info_score это неверно, поэтому её сложнее интерпретировать:
>>> metrics.mutual_info_score(labels_true, labels_pred)
0.69
Плохие разметки (например, независимые) дают неположительные оценки:
>>> labels_true = [0, 1, 2, 0, 3, 4, 5, 1]
>>> labels_pred = [1, 1, 0, 0, 2, 2, 2, 2]
>>> metrics.adjusted_mutual_info_score(labels_true, labels_pred)
-0.10526
Примеры
- Коррекция на случайность при оценке качества кластеризации: анализ влияния размера набора данных на значения метрик кластеризации для случайных назначений. Этот пример также включает скорректированный индекс Рэнда.
Математическая формулировка
Пусть заданы два назначения меток (для одних и тех же N объектов), \(U\) и \(V\). Их энтропия — это мера неопределённости разбиения, определяемая следующим образом:
где \(P(i) = |U_i| / N\) — вероятность того, что случайно выбранный объект из \(U\) попадёт в класс \(U_i\). Аналогично для \(V\):
где \(P'(j) = |V_j| / N\). Взаимная информация (MI) между \(U\) и \(V\) вычисляется по формуле:
где \(P(i, j) = |U_i \cap V_j| / N\) — вероятность того, что случайно выбранный объект попадёт одновременно в оба класса \(U_i\) и \(V_j\).
Её также можно выразить через мощности множеств:
Нормализованная взаимная информация определяется как
Это значение взаимной информации, как и нормализованный вариант, не скорректировано с учётом случайности и будет возрастать с увеличением количества различных меток (кластеров) независимо от фактической величины «взаимной информации» между назначениями меток.
Ожидаемое значение взаимной информации можно вычислить с помощью следующего уравнения [VEB2009]. В этом уравнении \(a_i = |U_i|\) (количество элементов в \(U_i\)), а \(b_j = |V_j|\) (количество элементов в \(V_j\)).
Используя ожидаемое значение, скорректированную взаимную информацию можно вычислить по формуле, аналогичной формуле скорректированного индекса Рэнда:
Для нормализованной и скорректированной взаимной информации в качестве нормирующего значения обычно используется некоторое обобщённое среднее энтропий каждой кластеризации. Существует несколько обобщённых средних, и строгих правил выбора одного из них нет. Выбор во многом зависит от конкретной области; например, в обнаружении сообществ чаще всего используется среднее арифметическое. Различные методы нормализации дают «качественно сходные результаты» [YAT2016]. В нашей реализации этот выбор задаётся параметром average_method.
Vinh и др. (2010) назвали варианты NMI и AMI в соответствии с методом усреднения [VEB2010]. Их варианты ‘sqrt’ и ‘sum’ соответствуют среднему геометрическому и среднему арифметическому; мы используем более распространённые названия этих средних.
Ссылки
- Strehl, Alexander и Joydeep Ghosh (2002). «Ансамбли кластеров — структура для повторного использования знаний при объединении нескольких разбиений». Journal of Machine Learning Research 3: 583-617. doi:10.1162/153244303321897735.
- Статья о (нормализованной) взаимной информации в Википедии
- Статья о скорректированной взаимной информации в Википедии
Vinh, Epps и Bailey (2009). «Информационно-теоретические меры для сравнения кластеризаций». Материалы 26-й ежегодной международной конференции по машинному обучению — ICML ‘09. doi:10.1145/1553374.1553511. ISBN 9781605585161.
Vinh, Epps и Bailey (2010). «Информационно-теоретические меры для сравнения кластеризаций: варианты, свойства, нормализация и коррекция на случайность». JMLR <https://jmlr.csail.mit.edu/papers/volume11/vinh10a/vinh10a.pdf>
Yang, Algesheimer и Tessone (2016). «Сравнительный анализ алгоритмов обнаружения сообществ в искусственных сетях». Scientific Reports 6: 30750. doi:10.1038/srep30750.
2.3.11.3. Однородность, полнота и V-мера
Если известны истинные назначения классов образцов, можно определить интуитивно понятные метрики с помощью анализа условной энтропии.
В частности, Rosenberg и Hirschberg (2007) определяют следующие два желательных свойства любого назначения кластеров:
- однородность: каждый кластер содержит объекты только одного класса.
- полнота: все объекты заданного класса назначены одному и тому же кластеру.
Эти понятия можно представить в виде оценок homogeneity_score и completeness_score. Обе оценки находятся в диапазоне от 0.0 до 1.0 (чем выше, тем лучше):
>>> from sklearn import metrics
>>> labels_true = [0, 0, 0, 1, 1, 1]
>>> labels_pred = [0, 0, 1, 1, 2, 2]

>>> metrics.homogeneity_score(labels_true, labels_pred)
0.66

>>> metrics.completeness_score(labels_true, labels_pred)
0.42
Их среднее гармоническое, называемое V-мерой, вычисляется функцией v_measure_score:
>>> metrics.v_measure_score(labels_true, labels_pred)
0.516
Формула этой функции имеет следующий вид:
По умолчанию beta равно 1.0. Если использовать значение beta меньше 1:
>>> metrics.v_measure_score(labels_true, labels_pred, beta=0.6)
0.547
больший вес будет придаваться однородности, а если использовать значение больше 1:
>>> metrics.v_measure_score(labels_true, labels_pred, beta=1.8)
0.48
больший вес будет придаваться полноте.
V-мера фактически эквивалентна рассмотренной выше взаимной информации (NMI), если в качестве функции агрегирования используется среднее арифметическое [B2011].
Однородность, полноту и V-меру можно вычислить одновременно с помощью homogeneity_completeness_v_measure следующим образом:
>>> metrics.homogeneity_completeness_v_measure(labels_true, labels_pred)
(0.67, 0.42, 0.52)
Следующее назначение кластеров немного лучше, поскольку оно однородно, но не является полным:
>>> labels_pred = [0, 0, 0, 1, 2, 2]
>>> metrics.homogeneity_completeness_v_measure(labels_true, labels_pred)
(1.0, 0.68, 0.81)
Примечание
v_measure_score симметрична: её можно использовать для оценки согласия двух независимых назначений для одного и того же набора данных.
Это не относится к completeness_score и homogeneity_score: обе связаны следующим соотношением:
homogeneity_score(a, b) == completeness_score(b, a)
Примеры
- Коррекция на случайность при оценке качества кластеризации: анализ влияния размера набора данных на значения метрик кластеризации для случайных назначений.
Математическая формулировка
Оценки однородности и полноты формально задаются следующим образом:
где \(H(C|K)\) — условная энтропия классов при заданных назначениях кластеров, определяемая как:
а \(H(C)\) — энтропия классов, определяемая как:
Здесь \(n\) — общее количество образцов, \(n_c\) и \(n_k\) — количество образцов, принадлежащих соответственно классу \(c\) и кластеру \(k\), а \(n_{c,k}\) — количество образцов класса \(c\), назначенных кластеру \(k\).
Условная энтропия кластеров при заданном классе \(H(K|C)\) и энтропия кластеров \(H(K)\) определяются симметричным образом.
Кроме того, Rosenberg и Hirschberg определяют V-меру как среднее гармоническое однородности и полноты:
Ссылки
- V-мера: внешняя метрика оценки кластеризации на основе условной энтропии Andrew Rosenberg и Julia Hirschberg, 2007
Идентификация и характеристика событий в социальных сетях, Hila Becker, докторская диссертация.
2.3.11.4. Оценки Фоулкса — Мэллоуза
Исходный индекс Фоулкса — Мэллоуза (FMI) предназначался для измерения сходства между двумя результатами кластеризации, что по своей сути является сравнением без учителя. Адаптацию индекса Фоулкса — Мэллоуза для обучения с учителем (реализованную в sklearn.metrics.fowlkes_mallows_score) можно использовать, если известны истинные метки классов образцов. FMI определяется как среднее геометрическое точности и полноты попарного сравнения:
В приведённой выше формуле:
-
TP(Истинно положительные): количество пар точек, сгруппированных вместе как в истинных метках, так и в предсказанных. -
FP(Ложно положительные): количество пар точек, сгруппированных вместе в предсказанных метках, но не в истинных. -
FN(Ложно отрицательные): количество пар точек, сгруппированных вместе в истинных метках, но не в предсказанных.
Оценка принимает значения от 0 до 1. Высокое значение указывает на хорошее сходство двух кластеризаций.
>>> from sklearn import metrics
>>> labels_true = [0, 0, 0, 1, 1, 1]
>>> labels_pred = [0, 0, 1, 1, 2, 2]
>>> metrics.fowlkes_mallows_score(labels_true, labels_pred)
0.47140
Можно поменять местами 0 и 1 в предсказанных метках, переименовать 2 в 3 и получить ту же оценку:
>>> labels_pred = [1, 1, 0, 0, 3, 3]

>>> metrics.fowlkes_mallows_score(labels_true, labels_pred)
0.47140
Идеальная разметка получает оценку 1.0:
>>> labels_pred = labels_true[:]
>>> metrics.fowlkes_mallows_score(labels_true, labels_pred)
1.0
Плохая разметка (например, независимая) получает нулевую оценку:
>>> labels_true = [0, 1, 2, 0, 3, 4, 5, 1]
>>> labels_pred = [1, 1, 0, 0, 2, 2, 2, 2]
>>> metrics.fowlkes_mallows_score(labels_true, labels_pred)
0.0
Литература
- E. B. Fowkles and C. L. Mallows, 1983. “A method for comparing two hierarchical clusterings”. Journal of the American Statistical Association. https://www.tandfonline.com/doi/abs/10.1080/01621459.1983.10478008
- Статья в Википедии об индексе Фоулкса — Мэллоуза
2.3.11.5. Коэффициент силуэта
Если истинные метки неизвестны, оценку необходимо выполнять с использованием самой модели. Коэффициент силуэта (sklearn.metrics.silhouette_score) — пример такой оценки: более высокий коэффициент силуэта соответствует модели с более чётко определёнными кластерами. Коэффициент силуэта определяется для каждого образца и состоит из двух величин:
- a: среднее расстояние между образцом и всеми остальными точками того же класса.
- b: среднее расстояние между образцом и всеми остальными точками следующего ближайшего кластера.
Коэффициент силуэта s для отдельного образца определяется следующим образом:
Коэффициент силуэта для набора образцов вычисляется как среднее значение коэффициентов силуэта для каждого образца.
>>> from sklearn import metrics
>>> from sklearn.metrics import pairwise_distances
>>> from sklearn import datasets
>>> X, y = datasets.load_iris(return_X_y=True)
Обычно коэффициент силуэта применяют к результатам кластерного анализа.
>>> import numpy as np
>>> from sklearn.cluster import KMeans
>>> kmeans_model = KMeans(n_clusters=3, random_state=1).fit(X)
>>> labels = kmeans_model.labels_
>>> metrics.silhouette_score(X, labels, metric='euclidean')
0.55
Примеры
- Выбор числа кластеров с помощью анализа силуэтов при кластеризации методом K-средних : В этом примере анализ силуэтов используется для выбора оптимального значения n_clusters.
Литература
- Peter J. Rousseeuw (1987). “Silhouettes: a Graphical Aid to the Interpretation and Validation of Cluster Analysis”. Computational and Applied Mathematics 20: 53-65.
2.3.11.6. Индекс Калинского — Харабаша
Если истинные метки неизвестны, для оценки модели можно использовать индекс Калинского — Харабаша (sklearn.metrics.calinski_harabasz_score), также известный как критерий отношения дисперсий. Более высокая оценка Калинского — Харабаша соответствует модели с более чётко определёнными кластерами.
Индекс представляет собой отношение суммы межкластерного разброса к внутрикластерному разбросу для всех кластеров (разброс определяется как сумма квадратов расстояний):
>>> from sklearn import metrics
>>> from sklearn.metrics import pairwise_distances
>>> from sklearn import datasets
>>> X, y = datasets.load_iris(return_X_y=True)
Обычно индекс Калинского — Харабаша применяют к результатам кластерного анализа:
>>> import numpy as np
>>> from sklearn.cluster import KMeans
>>> kmeans_model = KMeans(n_clusters=3, random_state=1).fit(X)
>>> labels = kmeans_model.labels_
>>> metrics.calinski_harabasz_score(X, labels)
561.59
Математическая формулировка
Для набора данных \(E\) размера \(n_E\), разбитого на \(k\) кластеров, оценка Калинского — Харабаша \(s\) определяется как отношение среднего межкластерного разброса к внутрикластерному разбросу:
где \(\mathrm{tr}(B_k)\) — след матрицы межгруппового разброса, а \(\mathrm{tr}(W_k)\) — след матрицы внутрикластерного разброса, определяемой следующим образом:
где \(C_q\) — множество точек кластера \(q\), \(c_q\) — центр кластера \(q\), \(c_E\) — центр \(E\), а \(n_q\) — количество точек в кластере \(q\).
Литература
- Caliński, T., & Harabasz, J. (1974). “A Dendrite Method for Cluster Analysis”. Communications in Statistics-theory and Methods 3: 1-27.
2.3.11.7. Индекс Дэвиса — Болдина
Если истинные метки неизвестны, для оценки модели можно использовать индекс Дэвиса — Болдина (sklearn.metrics.davies_bouldin_score): более низкий индекс Дэвиса — Болдина соответствует модели с лучшим разделением кластеров.
Этот индекс отражает среднее «сходство» между кластерами; сходство является мерой, сопоставляющей расстояние между кластерами с размером самих кластеров.
Ноль — минимально возможная оценка. Значения, близкие к нулю, указывают на лучшее разбиение.
Обычно индекс Дэвиса — Болдина применяют к результатам кластерного анализа следующим образом:
>>> from sklearn import datasets
>>> iris = datasets.load_iris()
>>> X = iris.data
>>> from sklearn.cluster import KMeans
>>> from sklearn.metrics import davies_bouldin_score
>>> kmeans = KMeans(n_clusters=3, random_state=1).fit(X)
>>> labels = kmeans.labels_
>>> davies_bouldin_score(X, labels)
0.666
Математическая формулировка
Индекс определяется как среднее сходство каждого кластера \(C_i\) для \(i=1, ..., k\) с наиболее похожим на него кластером \(C_j\). В контексте этого индекса сходство определяется мерой \(R_{ij}\), которая учитывает компромисс между следующими величинами:
- \(s_i\) — среднее расстояние между каждой точкой кластера \(i\) и центроидом этого кластера, также называемое диаметром кластера.
- \(d_{ij}\) — расстояние между центроидами кластеров \(i\) и \(j\).
Простой способ определить \(R_{ij}\) так, чтобы она была неотрицательной и симметричной:
Тогда индекс Дэвиса — Болдина определяется следующим образом:
Литература
- Davies, David L.; Bouldin, Donald W. (1979). “A Cluster Separation Measure” IEEE Transactions on Pattern Analysis and Machine Intelligence. PAMI-1 (2): 224-227.
- Halkidi, Maria; Batistakis, Yannis; Vazirgiannis, Michalis (2001). “On Clustering Validation Techniques” Journal of Intelligent Information Systems, 17(2-3), 107-145.
- Статья в Википедии об индексе Дэвиса — Болдина.
2.3.11.8. Матрица сопряжённости
Матрица сопряжённости (sklearn.metrics.cluster.contingency_matrix) показывает мощность пересечения для каждой пары истинного и предсказанного кластеров. Матрица сопряжённости содержит достаточную статистику для всех метрик кластеризации в случаях, когда образцы являются независимыми и одинаково распределёнными, и нет необходимости учитывать экземпляры, не отнесённые ни к одному кластеру.
Пример:
>>> from sklearn.metrics.cluster import contingency_matrix
>>> x = ["a", "a", "a", "b", "b", "b"]
>>> y = [0, 0, 1, 1, 2, 2]
>>> contingency_matrix(x, y)
array([[2, 1, 0],
       [0, 1, 2]])
Первая строка выходного массива указывает, что есть три образца, истинный кластер которых — «a». Из них два относятся к предсказанному кластеру 0, один — к кластеру 1, а ни один — к кластеру 2. Вторая строка указывает, что есть три образца, истинный кластер которых — «b». Из них ни один не относится к предсказанному кластеру 0, один относится к кластеру 1, а два — к кластеру 2.
Матрица ошибок для задачи классификации — это квадратная матрица сопряжённости, в которой порядок строк и столбцов соответствует списку классов.
Литература
2.3.11.9. Матрица ошибок для пар
Матрица ошибок для пар (sklearn.metrics.cluster.pair_confusion_matrix) — это матрица сходства 2x2
для двух кластеризаций, вычисляемая с учётом всех пар образцов и подсчётом пар, отнесённых к одному или разным кластерам в истинной и предсказанной кластеризациях.
Она содержит следующие элементы:
\(C_{00}\) : количество пар, в которых образцы не сгруппированы вместе ни в одной из кластеризаций
\(C_{10}\) : количество пар, в которых образцы сгруппированы вместе в кластеризации по истинным меткам, но не сгруппированы вместе в другой кластеризации
\(C_{01}\) : количество пар, в которых образцы не сгруппированы вместе в кластеризации по истинным меткам, но сгруппированы вместе в другой кластеризации
\(C_{11}\) : количество пар, в которых образцы сгруппированы вместе в обеих кластеризациях
Если считать пару образцов, сгруппированных вместе, положительной парой, то, как и в бинарной классификации, количество истинно отрицательных пар равно \(C_{00}\), ложно отрицательных — \(C_{10}\), истинно положительных — \(C_{11}\), а ложно положительных — \(C_{01}\).
При полном совпадении разметок все ненулевые элементы находятся на диагонали, независимо от фактических значений меток:
>>> from sklearn.metrics.cluster import pair_confusion_matrix
>>> pair_confusion_matrix([0, 0, 1, 1], [0, 0, 1, 1])
array([[8, 0],
       [0, 4]])
>>> pair_confusion_matrix([0, 0, 1, 1], [1, 1, 0, 0])
array([[8, 0],
       [0, 4]])
Разметка, при которой все образцы классов отнесены к одним и тем же кластерам, является полной, но не всегда чистой, поэтому получает штраф; у такой матрицы есть ненулевые внедиагональные элементы:
>>> pair_confusion_matrix([0, 0, 1, 2], [0, 0, 1, 1])
array([[8, 2],
       [0, 2]])
Матрица не является симметричной:
>>> pair_confusion_matrix([0, 0, 1, 1], [0, 0, 1, 2])
array([[8, 0],
       [2, 2]])
Если образцы классов полностью распределены по разным кластерам, разбиение совершенно неполное, поэтому все диагональные элементы матрицы равны нулю:
>>> pair_confusion_matrix([0, 0, 0, 0], [0, 1, 2, 3])
array([[ 0,  0],
       [12,  0]])
Литература
- “Comparing Partitions” L. Hubert and P. Arabie, Journal of Classification 1985
© 2007–2026 The scikit-learn developers
Licensed under the 3-clause BSD License.
https://scikit-learn.org/1.9/modules/clustering.html


